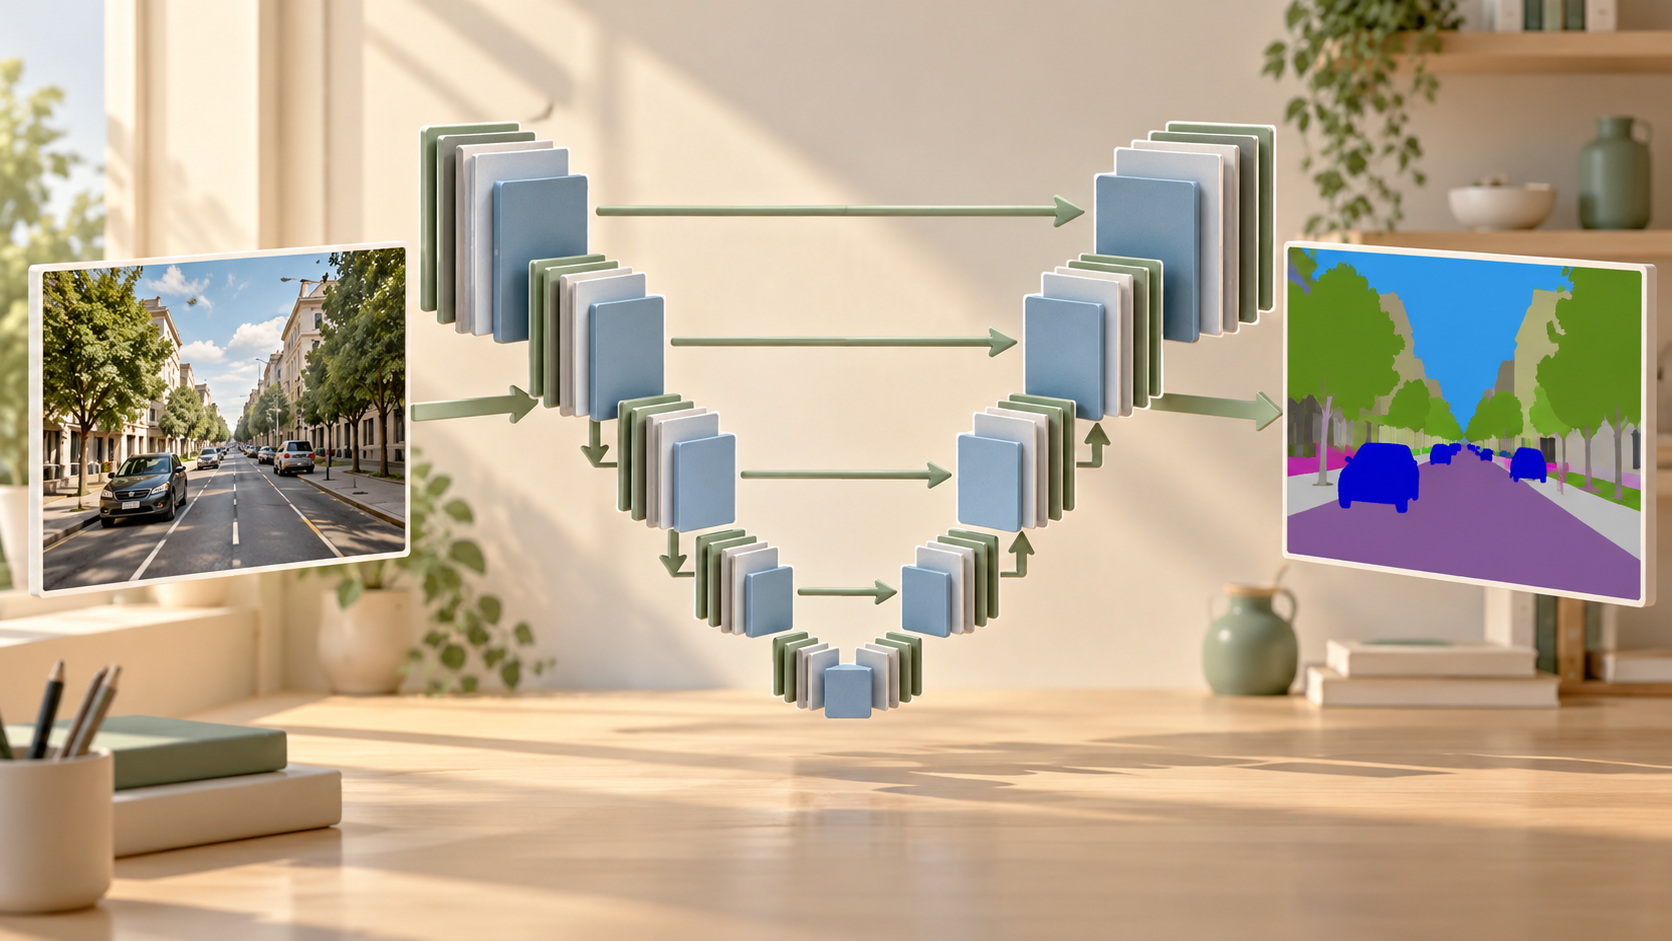
学习初稿 · 第 20 课。 本篇已开放网页阅读,用于先建立完整认识。文中手算值和示意记录不代表真实训练成绩;真实数据训练、预训练权重和板端测试以本篇具体说明为准,本篇已附代码练习,实际验证范围见文末与包内记录。
当矩形框不能满足需求
如果要测量区域面积、提取目标轮廓或区分道路边界,仅有框不够。语义分割为每个像素分配类别;实例分割还区分同类别的不同对象。本课只做前景与背景的二分类语义分割。
一张 RGB 图输入 [N,3,H,W],本课的单通道二分类输出是 [N,1,H,W] logits。标签同形状,前景为 1、背景为 0。多类互斥分割则常输出 [N,C,H,W] 并用整数掩码 [N,H,W],损失约定不同。
为什么需要编码与解码
编码路径逐步整合空间上下文并减小分辨率;解码路径恢复空间尺寸。下采样有助于理解较大范围的信息,却可能损失边界细节,所以 U-Net 将较早的高分辨率特征与后面的解码特征结合。U-Net 原论文
这里的跳跃连接常通过通道拼接实现,与 ResNet 常见的逐元素相加不同。拼接要求空间大小匹配,并会增加通道数;后续卷积的输入通道必须据此设置。
一个独立的教学网络
下面只依赖 PyTorch,生成一块矩形作为标签。网络仅有一次下采样,属于 U-Net 思路的缩小教学实现,不是完整原论文结构。它执行一次训练步,验证形状与梯度链路,不应期待一次更新就学会分割。
|
本例把前景亮度直接编码进输入,任务刻意简单。它只帮助理解数据与输出关系。若训练多个位置、尺寸和噪声的矩形,也仍然是合成任务,不能把高 IoU 解释成真实物体分割能力。
掩码处理和图片处理不能完全一样
几何增强需要同步作用于图片与掩码。类别索引掩码缩放通常使用最近邻,避免插值得到 0.3、1.7 这样没有类别意义的编号。图片则可使用适合的连续插值方式。
本例的二分类损失接原始 logits,不应先 Sigmoid 再传给带 logits 的接口。显示结果时才用 Sigmoid 转换,并按验证集确定的阈值生成前景布尔掩码。
标签若以 0 和 255 存储,读取后需要明确转换成 0 和 1,不能直接把 255 当作二元概率目标。也要检查掩码是否和原图尺寸、方向一致。
像素准确率可能被背景掩盖
若前景只占 5%,全预测背景也有 95% 像素准确率。可以查看前景 IoU:预测前景与真实前景交集除以并集。Dice 则是两倍交集除以两者面积之和,它与 IoU 相关但数值不同。
真实前景与预测都为空时,并集为零,需要提前定义统计策略,例如单独报告空图并从前景平均中排除。不同策略不能不加说明地混合比较。
检查边界时还应查看可视化叠图,确认模型是否只是学了背景或面积。损失很低不代表每个小目标边缘都正确。
练习
- 拼接
[2,8,32,32]与[2,16,32,32]后形状是什么? - 交集 30、预测面积 50、真实面积 40,IoU 是多少?
- 为什么本课矩形实验成功不能证明能分割汽车?
参考答案
沿通道拼接后为 [2,24,32,32]。并集为 60,所以 IoU 为 0.5。合成矩形的颜色、背景和形状分布远比真实图像简单,标签还直接对应亮度,缺少真实场景的独立验证。
下一课介绍另一种组织视觉信息的方法:把图片划成块,再让不同块通过注意力交换信息。
配套代码练习
实验:小型 U-Net 的一次训练步
查看完整代码:main.py
"""小型 U-Net 的一次训练步。运行方式与练习见 README.md。"""
import torch
from torch import nn
import torch.nn.functional as F

torch.manual_seed(7)
torch.set_num_threads(2)

class TinyUNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.enc = nn.Sequential(nn.Conv2d(3, 8, 3, padding=1), nn.ReLU())
        self.low = nn.Sequential(nn.Conv2d(8, 16, 3, padding=1), nn.ReLU())
        self.dec = nn.Sequential(nn.Conv2d(24, 8, 3, padding=1), nn.ReLU(),
                                 nn.Conv2d(8, 1, 1))

    def forward(self, x):
        skip = self.enc(x)
        low = self.low(F.max_pool2d(skip, 2))
        up = F.interpolate(low, size=skip.shape[-2:], mode='bilinear',
                           align_corners=False)
        return self.dec(torch.cat([skip, up], dim=1))

mask = torch.zeros(2, 1, 32, 32)
mask[:, :, 8:24, 10:22] = 1
images = mask.repeat(1, 3, 1, 1) * 0.7 + torch.rand(2, 3, 32, 32) * 0.2
model = TinyUNet()
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
optimizer.zero_grad()
logits = model(images)
assert logits.shape == mask.shape
loss = F.binary_cross_entropy_with_logits(logits, mask)
loss.backward()
optimizer.step()
print(tuple(logits.shape), bool(torch.isfinite(loss)))
with torch.no_grad():
prediction = model(images).sigmoid() >= 0.5
truth = mask.bool()
intersection = (prediction & truth).sum().item()
union = (prediction | truth).sum().item()
print('一步训练后合成掩码 IoU:', intersection/union if union else 1.0)
在项目根目录执行;下载包解压后,在解压目录执行 python3 main.py。
cd 'content/posts/AI-深度学习/从零搭建视觉模型/20-图像分割与UNet/code' && python3 main.py本篇已附独立实验包,在代码卡片中查看源码、下载或复制运行命令。解压后执行 python3 main.py;依赖安装见包内 README.md。
观察目标: 输出 [2,1,32,32],损失有限且完成反向更新;合成矩形不代表真实分割精度。
动手修改: 把输入改为奇数尺寸 31×29,保持掩码与输入对应,验证解码器仍能恢复原尺寸。
所有输入均在本篇代码中构造;运行范围和验证记录见包内 verification.md。