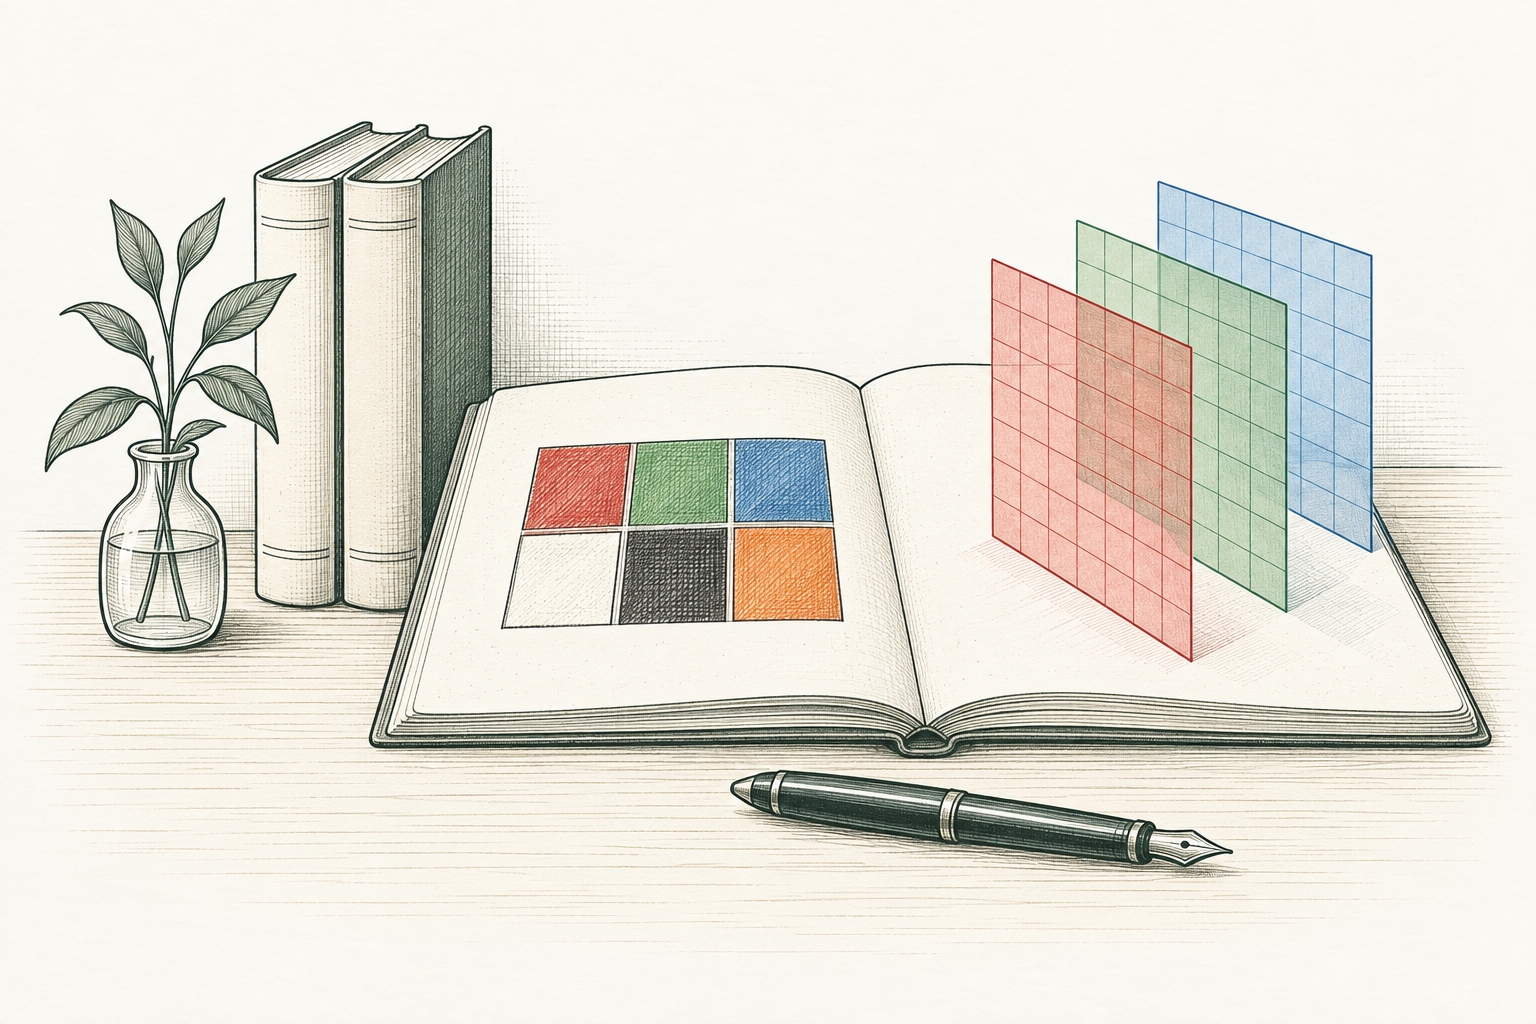
完成《Python 起步》后,已经能读图片、取像素、复制数组。但看到 permute、float32、/ 255.0 和 unsqueeze,还会问:为什么需要这些步骤?
本篇放在 Python 起步与《图片如何变成张量》实验之间。只需要乘除法、下标和数组基础,先理解数据如何表示,不急着引入严格的数学定义。卷积、损失与梯度留到搭建和训练模型时再补。
本课已于 2026-09-28 完成学习。文末四道练习已补齐答案与易错总结,默认折叠,可先独立思考再展开对照。
1. 电脑怎样表示一张图片
先用这张宽 3、高 2 的图片贯穿全文。下标从 0 开始。
| 位置 | 第 0 列 | 第 1 列 | 第 2 列 |
|---|---|---|---|
| 第 0 行 | 红 [255, 0, 0] |
绿 [0, 255, 0] |
蓝 [0, 0, 255] |
| 第 1 行 | 白 [255, 255, 255] |
黑 [0, 0, 0] |
橙 [255, 128, 0] |
一个像素对应网格中的一个位置。RGB 表示这个位置用红、绿、蓝三个通道值描述颜色;它们属于同一个像素,并不是三个像素。
易错记录(2026-09-28):把橙色误认为红色。
我看到
[255, 128, 0]的 R 通道是 255,就以为它应该是红色。这里忽略了 G 通道还有 128:像素颜色由 R、G、B 三个值共同决定,不能只看最大通道。对照记忆:
[255, 0, 0]是纯红色,[255, 128, 0]是橙色,[255, 255, 0]是黄色。保持 R 为 255、B 为 0,逐渐增加 G,颜色就会从红色经过橙色向黄色变化。这是 RGB 光的加色混合,不是颜料混色。
因此,这张图片有:
|
这也解释了为什么“像素数量与通道数无关”,但像素数据的大小与通道数有关。一张同样尺寸的单通道灰度图仍有 6 个像素,只需 6 个通道值。
文件大小与像素数据大小为什么不同
本例使用 uint8,即 8 位无符号整数。8 位共有 2⁸ = 256 种组合,从 0 编号到 255,每个通道值占 1 字节。
紧密排列的像素数据占 18 × 1 = 18 字节。如果将同样的 18 个值改成 float32,每个占 4 字节,就需要 72 字节。这里不计算数组对象、文件头或其他开销。
磁盘上的 PNG、JPEG 有自己的编码和压缩方式;本课的 P3 PPM 还把数字写成文本,例如 255 对应三个字符。因此,不能直接用文件大小推导解码后有多少像素。
用 C/C++ 的经验理解:读取一个文本文件得到的是字符,要经过解析才能得到数值;图片解码也是把文件表示转换成可计算的数据表示。
2. 标量、向量、矩阵和张量是什么
先按需要多少个下标,区分这些数据:
| 表示 | 本例中的对象 | 形状 | 取出一个数需要几个下标 |
|---|---|---|---|
| 标量 | 橙色像素的 G 值 128 |
() |
0 |
| 一维数组,可用来表示向量 | 一个 RGB 像素 [255, 128, 0] |
(3,) |
1 |
| 二维数组,可用来表示矩阵 | 整张图的 G 通道 | (2, 3) |
2 |
| 三维数组 | 一张 HWC 格式的 RGB 图片 | (2, 3, 3) |
3 |
| 四维数组 | 一批 NCHW 格式的 RGB 图片 | (N, 3, 2, 3) |
4 |
G 通道单独拿出来,是这样一个矩阵:
|
在这门编程入门课里,可以先把 PyTorch 张量理解为能够参与张量运算、带有形状与数据类型等信息的多维数组。它也可以是零维、一维或二维,不是只有三维以上才叫张量。数学中张量还有更严格的定义,当前的图片输入实验不需要先掌握它。
张量不是图片专用格式,也可以装声音、坐标或其他数字。NumPy 已经能装这些像素;转换成 PyTorch 张量,是为了接入后面的模型计算工具,并不是转换后数据才突然具有“智能”。
“三维向量”和“三维张量”不要混淆
线性代数里说 RGB 是“三维向量”,通常指它有三个分量。程序中的形状却是 (3,),只有一个轴,ndim 为 1。
这里说图片是“三维张量”,指它有三个轴,形状是 (H, W, C)。它不是只有三个数,也不是说图片变成了立体场景。
3. 形状、维度、轴和索引分别描述什么
用 (2, 3, 3) 举例:
- 轴:访问数据的方向,本例约定为行、列、通道。
- 轴编号:从 0 开始,本例轴 0 是 H,轴 1 是 W,轴 2 是 C。
- 形状
shape:每个轴的长度,即(2, 3, 3)。 - 维度数
ndim:轴的数量,这里是 3。 - 索引:在某个轴上选择的位置,例如第二行、第三列、第二个通道(下标依次为 1、2、1)。
因此,橙色像素的绿色分量写成:
|
取出整个橙色像素,保留通道轴:
|
取出整张图的 G 通道,保留行和列:
|
其中 : 表示保留这个轴上的全部位置。张量的形状本身不会标注“这是行”“这是通道”,这些含义来自我们与接口的约定。
为什么宽高顺序常常反过来
Pillow 的图片尺寸用 (宽, 高),对应这里的 (3, 2);我们得到的数组按“行、列、通道”访问,所以是 (高, 宽, 通道),即 (2, 3, 3)。
图片没有旋转。这是尺寸接口和数组索引使用了不同的描述顺序。用宽高不相等的图片练习,更容易发现把它们写反的问题。
4. 为什么调整为 CHW,还要增加 N
HWC 可以理解为:先找到某行某列的像素,再选其中的通道。CHW 则是:先选中一个通道平面,再找该平面的行和列。
|
后面的 PyTorch 卷积实验使用 NCHW:N 是一批中的图片数量,C 是通道数,H、W 是高度和宽度。Conv2d 接受这种带批次的输入,也支持没有批次维的 CHW;本课程统一使用 NCHW,方便从一张扩展到多张。见 Conv2d 官方输入说明。
因此,使用 CHW 是为了匹配后续接口约定,不是说 HWC 表示错误,也不是所有模型都必须用同一种布局。RGB 与 BGR 则是通道内部的颜色顺序,是另一个问题;把 HWC 调成 CHW 不会自动把 RGB 变成 BGR。
permute(2, 0, 1) 的数字从哪里来
原来的轴编号是 0=H、1=W、2=C。新顺序要 C、H、W,就依次填写原来的轴编号:
|
2 不是“取第三个颜色值”,而是“把原来的第 2 号轴放在最前面”。permute 返回按新顺序解释数据的视图,像素对应关系保持不变。见 permute 官方说明。
为什么不能只用 reshape
把一份按 HWC 排列的数据直接 reshape(3, 2, 3),只是按元素顺序重新分组,没有完成所需的按轴重排。本例虽然形状也变成 (3, 2, 3),取出的“橙色位置”却会变成 [0, 255, 0]。
可以类比 C 的连续数组:同一串数字按不同长度切成几段,不等于已经把所有 R 值、G 值、B 值分别归组。形状相同只是检查的一部分,还需要检查像素的对应关系。
一张图片为什么也有批次维度
一张图片的 CHW 是 (3, 2, 3),增加一个长度为 1 的 N 轴后是 (1, 3, 2, 3)。它表达“这一批包含一张图片”,没有复制像素,也没有产生新图片。
两张同尺寸图片组成一批时,形状可以是 (2, 3, 2, 3)。增加批次轴有助于统一处理一张与多张输入;它本身不是训练,也不保证加速。
5. 为什么转成浮点数,再除以 255
先把这两个操作拆开理解。
转换类型:让数据能够表示小数
uint8 能表示 0~255 的整数,不能保存 0.5。模型计算中会遇到非整数权重、加权结果和梯度,后续课程因此采用 float32。这里只是选择一种常用的学习配置,实际模型也可能使用其他浮点或量化类型。
|
单纯转换类型不会自动把 255 变成 1,也不会改变图片的形状。输入采用浮点数不等于开启自动求导,当前实验还没有进行训练。
缩放数值:使用一个明确的范围约定
本例的 8 位通道值范围是 0~255,除以 255 就得到 0~1:
|
例如,一个通道值乘以 0.2:原尺度是 255 × 0.2 = 51,缩放后是 1 × 0.2 = 0.2。输入尺度会影响后续计算的数值尺度,所以训练和使用模型时必须采用一致的预处理约定。
这不是“神经网络只能接收 0~1”,也不是“这样一定能训练得更好”。对于已有模型,应该按它训练时要求的范围处理;本课程从头做简单实验,选用这个容易观察的约定。
为什么不除以 256,或者当前图片的最大值
256 是可能取值的数量,255 才是本例的最大允许值。若想把 255 映射为 1,应除以 255。
也不要把这一步换成“除以当前图片中的最大值”。假设两张图片的像素值分别全为 64 和 128,各自除以自身最大值后都会变成全 1,原本不同的数值会被映射成相同结果。
按固定的 255 缩放,它们分别约为 0.251 和 0.502,保留了原来强度的差别。图片未必包含 0 或 255,所以缩放后实际最小值、最大值也不必恰好为 0、1。
这里没有做减均值、除标准差。以后遇到“归一化”这个词,要看实际公式,而不能只凭名字判断做了哪种处理。
6. 为什么要关心数据是否共享
当一个 NumPy 数组接入 PyTorch 中:
|
两者共享底层内存,对一方元素的修改会反映到另一方。它没有自动复制像素,也没有自动缩放数值。见 from_numpy 官方说明。
这类似于 C/C++ 中多个访问入口引用同一块内存的情况:变量名不同,不代表数据有两份。
需要独立修改时,张量可以用 clone() 复制;本课的 NumPy 数组可以用 copy() 复制。相反,普通赋值 other = hwc 只是给同一个张量对象增加一个名字。
contiguous() 是否一定复制
维度重排后,张量可以利用形状和步长信息,以新的顺序访问原来的内存。步长描述沿某个轴移动一个位置时,底层存储需要跨过多少个元素。
contiguous() 在需要时把数据整理成指定的连续布局;如果已经符合要求,可能直接返回原张量。它不是“无论如何都创建独立副本”的接口。见 contiguous 官方说明。
初学时先区分三个问题:像素数值是否变了、轴的顺序是否变了、数据是否复制了。这三件事不能相互推断。
7. 跟着橙色像素走一遍
将整张图作为输入,下面追踪位于第 1 行、第 2 列的橙色像素:
| 阶段 | 整份数据的形状 | 类型 | 如何取橙色像素 | 通道值 |
|---|---|---|---|---|
| NumPy HWC | (2, 3, 3) |
uint8 |
pixels[1, 2] |
[255, 128, 0] |
| PyTorch HWC | (2, 3, 3) |
torch.uint8 |
hwc[1, 2] |
[255, 128, 0] |
| PyTorch CHW | (3, 2, 3) |
torch.uint8 |
chw[:, 1, 2] |
[255, 128, 0] |
| 转为浮点数 | (3, 2, 3) |
torch.float32 |
floating[:, 1, 2] |
[255.0, 128.0, 0.0] |
| 除以 255 | (3, 2, 3) |
torch.float32 |
scaled[:, 1, 2] |
约 [1.0, 0.501961, 0.0] |
| 增加批次轴 | (1, 3, 2, 3) |
torch.float32 |
batch[0, :, 1, 2] |
约 [1.0, 0.501961, 0.0] |
每一步中通道值的总数量仍然是 18。增加轴不一定增加元素,转换类型可能增加内存占用,而调整轴顺序并不意味着改变了颜色。
8. 先手算,再判断
这些题不需要运行代码,先写下结果即可。做完再结合实验验证,各题的参考答案与练习总结放在题目下方,默认折叠,点击后展开。
练习 1:数清数据
一张宽 5、高 4 的 RGB 图片,通道类型为 uint8:
- 有多少像素、多少通道值?
- HWC、CHW 和单张 NCHW 的形状分别是什么?
- 紧密排列的像素数据占多少字节?改成
float32后是多少?不计额外开销。
点击查看第一题参考答案与本次练习总结
参考答案
第一问:图片宽 5、高 4,每个像素有 R、G、B 三个通道。
|
第二问:不仅要说明字母含义,还要代入具体数值,写出形状。
| 布局 | 各轴含义 | 本题形状 |
|---|---|---|
| HWC | 高、宽、通道 | (4, 5, 3) |
| CHW | 通道、高、宽 | (3, 4, 5) |
| NCHW | 批次中的图片数量、通道、高、宽 | (1, 3, 4, 5) |
N 表示当前这一批的图片数量。本题是一张图片,所以 N 为 1;它不是整个数据集的图片总数。
第三问:只计算紧密排列的像素数据,不计其他开销。
|
本次练习总结
本次回答中的 20 个像素、60 个通道值、60 字节和 240 字节均正确,HWC、CHW、NCHW 的含义也解释正确。需要补充的是第二问的具体形状,不能只写字母的含义。
转换成 float32 后,仍然有 20 个像素、60 个通道值,变化的是每个值占用的字节数。调整轴顺序也不会改变元素总数:4 × 5 × 3、3 × 4 × 5、1 × 3 × 4 × 5 都等于 60,可以用来检查形状中的数量是否一致,但仅凭总数相同还不能证明轴顺序正确。
练习 2:写出索引
对本文 3×2 示例图,分别写出 HWC、CHW、NCHW 三种格式下取得橙色像素全部通道的表达式。NCHW 的批次中只有一张图片。
再写出取得橙色像素 G 值的表达式,结果应为 128(尚未缩放)。
点击查看第二题参考答案与本次易错点
参考答案
橙色像素位于第二行、第三列,下标从 0 开始,所以行下标为 1,列下标为 2。RGB 的通道下标依次是 0、1、2,G 对应 1。批次中只有一张图片,其下标为 0。
| 布局 | 取橙色像素的全部通道 | 直接取橙色像素的 G 值 |
|---|---|---|
| HWC | hwc[1, 2, :] |
hwc[1, 2, 1] |
| CHW | chw[:, 1, 2] |
chw[1, 1, 2] |
| NCHW | batch[0, :, 1, 2] |
batch[0, 1, 1, 2] |
全部通道的结果均为 [255, 128, 0],G 值均为 128。这里的 batch 表示尚未缩放的 NCHW 数据;如果已经除以 255,G 值就约为 0.501961。
HWC 的 hwc[1, 2, :] 可以简写为 hwc[1, 2]。也可以先取出整个像素,再用 [1] 选择 G:
|
本次易错点
本次回答为:HWC [2, 1:],CHW [:, 1, 2],NCHW [1, :, 1, 2],再用 [1] 取 G。其中 CHW 正确;取 G 的思路在已经取出 RGB 像素的前提下也正确。
- HWC 混淆了行列顺序与切片。
[2, 1:]的第一个下标 2 表示第三行,但本例只有两行,会越界。后面的1:表示该轴从下标 1 取到末尾,不是分别指定列和通道。应写成[1, 2, :]:选第 1 行、第 2 列,保留全部通道。 - N 的长度不等于图片下标。 N 为 1 表示这一批只有一张图片,可用下标只有 0。
batch[1, :, 1, 2]会尝试取第二张图片,因而越界;应改为batch[0, :, 1, 2]。 [1]的含义取决于当前数据。 对已经取出的 RGB 像素,orange[1]是 G 值;对完整 HWC 张量,hwc[1]取的是第二行,并非某个像素的 G 值。要先确认正在索引哪个对象。
记住:形状说明每个轴有几个位置,索引说明选择哪个位置。下标从 0 开始,长度为 1 的轴只能取下标 0;逗号分隔不同轴的索引,冒号表示在一个轴上取切片。
练习 3:辨别操作
对每句话判断对错,错误的改成一句正确表述:
- 形状
(3,)的 RGB 向量,在 PyTorch 中是三维张量。 - HWC 改成 CHW 后,RGB 会自动变成 BGR。
- 转成
float32就会自动将 255 缩放成 1。 - 一张全为 128 的图除以 255 后,最大值一定为 1。
(1, 3, 2, 3)中的 1 表示这一批有一张图片。contiguous()可以保证获得一份不共享内存的副本。
点击查看第三题参考答案与本次练习总结
参考答案
六个判断依次为:错误、错误、错误、错误、正确、错误。
- 错误:
(3,)是一维张量。 它只有一个轴,这个轴上有三个元素。RGB 可以作为有三个分量的向量,但不能因此说它在 PyTorch 中有三个轴。 - 错误:调整的是轴的排列顺序。 HWC 改成 CHW 后,行、列、通道这三个轴的位置改变,RGB 通道的颜色顺序和对应像素值保持不变,不会自动变成 BGR。
- 错误:转换类型不等于缩放数值。 转成
float32后,255变为255.0;再除以 255 才得到1.0。 - 错误:本题的最大值约为 0.501961。 整张图的值全为 128,除以 255 后每个值都约为
128 / 255 ≈ 0.501961,所以最小值和最大值都等于这个值,而不是 1。 - 正确:N 为 1 表示这一批只有一张图片。 后面的 3、2、3 分别表示通道数、高度和宽度。
- 错误:
contiguous()不保证独立副本。 如果张量已经符合所要求的连续内存布局,会返回原张量;否则才复制数据,整理成所要求的布局。明确需要独立副本时应使用clone()。
本次练习总结
本次六道题的对错判断全部正确,已经能区分轴顺序、数据类型和数值缩放。几处解释补充得更精确后如下:
- 第一题原回答“一维向量”的理解正确,这里用“一维张量,包含三个元素”更贴合 PyTorch 的语境。
- 第二题原回答“只改变顺序,不改变像素”,需要明确是改变轴的顺序,避免误解成 RGB 颜色顺序也发生了改变。
- 第四题原回答“不一定为 1”,对一般图片成立;但本题明确给出全为 128,因此可以直接算出最大值约为 0.501961。
- 第六题原回答“各种参数一致,就可能共享”,需要把条件具体化为是否已经符合所要求的连续内存布局。这里不是按形状、类型等参数是否相同来判断是否复制。
可以这样区分:contiguous() 的目的是整理内存布局,clone() 的目的是复制数据。不要用前者代替“保证修改副本不影响原数据”的需求。
练习 4:检查共享关系
假设 pixels 是本例的 NumPy 数组,依次执行:
|
pixels[0, 0]、hwc[0, 0]、saved[0, 0] 分别是什么?写出结果并说明哪两者共享数据。
点击查看第四题参考答案与本次练习总结
参考答案
左上角原来是红色像素 [255, 0, 0]。执行 hwc[0, 0, 0] = 0 后,三个结果分别为:
|
torch.from_numpy(pixels) 让 hwc 与 pixels 共享底层数据,因此通过 hwc 将左上角的 R 值改为 0 时,pixels 中对应的值也会改变,像素由红色变为黑色。
saved = hwc.clone() 在修改前创建了独立副本,保存当时的像素数据。后续修改 hwc 不会影响 saved,所以它的左上角仍为红色 [255, 0, 0]。复制发生的时机也很重要:如果在修改之后才调用 clone(),复制到的就会是修改后的值。
本次练习总结
本次通过口述思路完成:hwc 和 pixels 共用数据,修改左上角 R 值会一起变化;saved 是修改前创建的副本,保持不变。理解完全正确,已能区分共享数据与独立副本,无需额外写代码才能完成这道判断题。
9. 接下来,用代码验证这些概念
本课的四道练习已经完成:计算像素与存储大小,区分轴长度与索引,辨别类型转换和数值缩放,判断数据共享与复制。需要特别记住的易错点是:RGB 颜色由三个通道共同决定;长度为 1 的批次轴只能用下标 0;contiguous() 不保证独立副本。
下一步进入《图片如何变成张量》的实验,把本文的橙色像素沿着 HWC → CHW → NCHW 逐步追踪,并检查每一步的形状、类型与数值。能够解释这些变化,比记住一串 API 名称更有用。后续再学习卷积与模型训练。
配套代码练习
实验:跟踪像素、轴与拷贝
查看完整代码:main.py
"""跟踪像素、轴与拷贝。运行方式与练习见 README.md。"""
import copy
# 两行三列,每个像素含 RGB 三个通道。
hwc = [[[255,0,0],[0,255,0],[0,0,255]],
       [[255,255,255],[0,0,0],[255,128,0]]]
chw = [[[hwc[y][x][c]/255 for x in range(3)] for y in range(2)] for c in range(3)]
nchw = [chw]
print('HWC=(2,3,3), CHW=(3,2,3), NCHW=(1,3,2,3)')
print('橙色像素:', [nchw[0][c][1][2] for c in range(3)])
assert nchw[0][1][1][2] == 128/255
alias = hwc
clone = copy.deepcopy(hwc)
alias[0][0][0] = 0
assert hwc[0][0][0] == 0 and clone[0][0][0] == 255
print('共享引用会修改原对象,deepcopy 保留原始值')
在项目根目录执行;下载包解压后,在解压目录执行 python3 main.py。
cd 'content/posts/AI-深度学习/从零搭建视觉模型/03-基础概念/code' && python3 main.py本篇已附独立实验包,在代码卡片中查看源码、下载或复制运行命令。解压后执行 python3 main.py;依赖安装见包内 README.md。
观察目标: 橙色归一化结果为 [1.0, 0.50196…, 0.0]。这里用列表理解轴;张量视图与连续内存在第 4 课验证。
动手修改: 将橙色像素移到第一行第一列,写出 HWC 和 NCHW 的访问下标,再用代码验证。
所有输入均在本篇代码中构造;运行范围和验证记录见包内 verification.md。