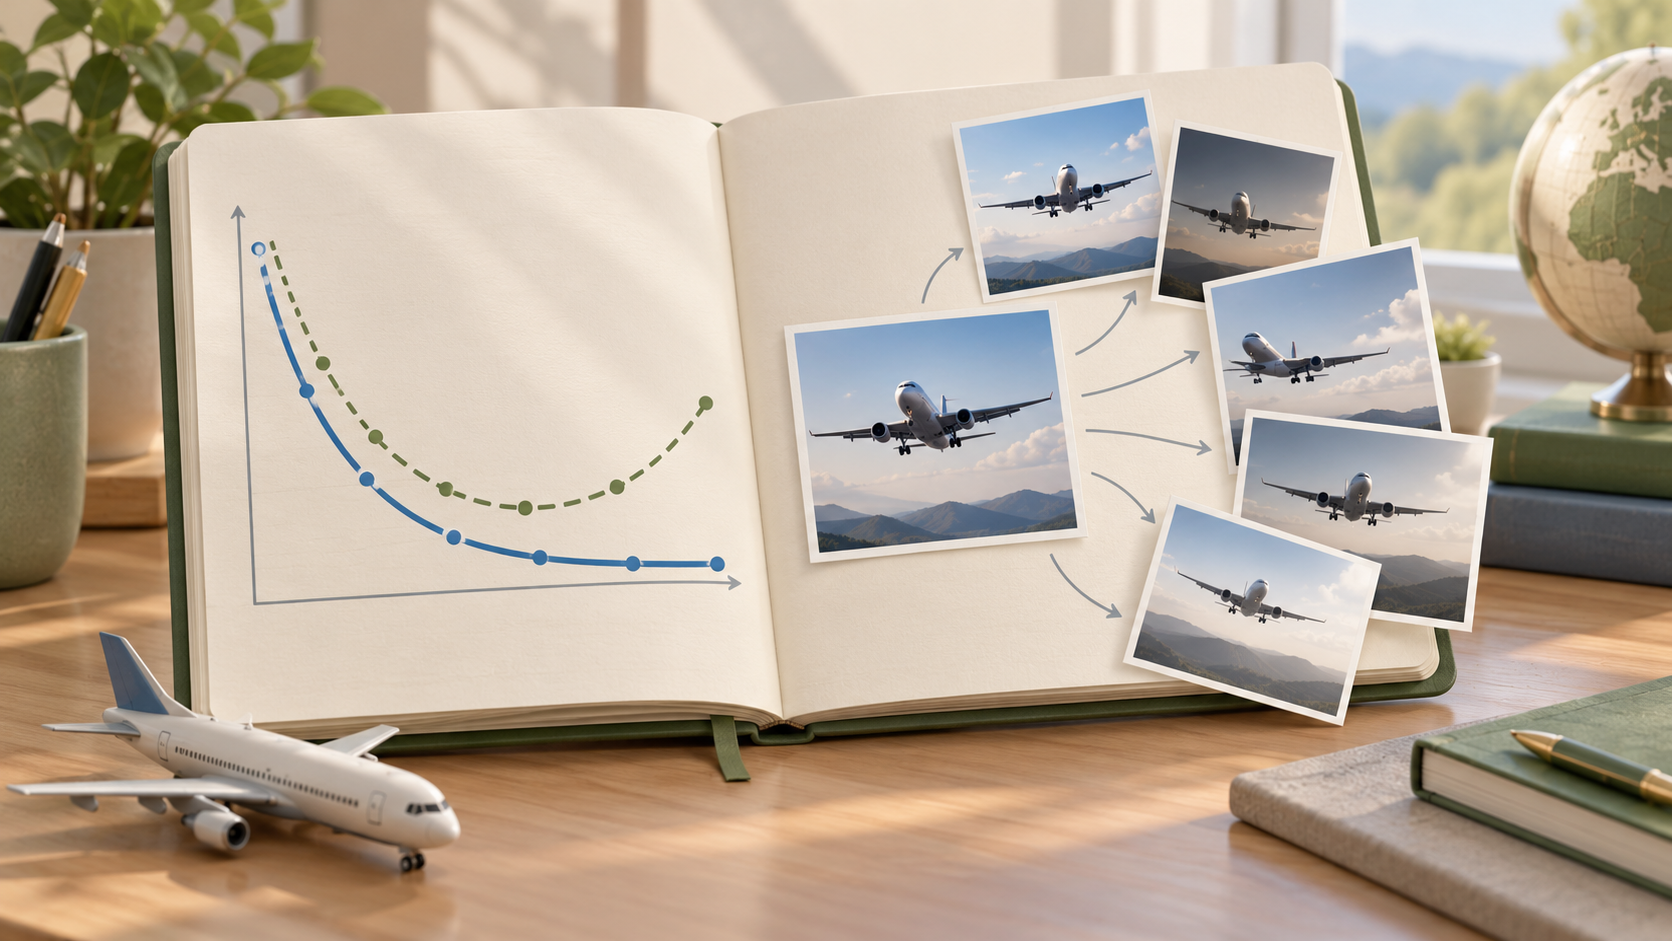
学习初稿 · 第 13 课。 本篇已开放网页阅读,用于先建立完整认识。文中手算值和示意记录不代表真实训练成绩;真实数据训练、预训练权重和板端测试以本篇具体说明为准,本篇已附代码练习,实际验证范围见文末与包内记录。
训练越来越好,陌生图片反而变差
继续使用飞机与汽车分类。假设一组人为构造的记录如下:训练损失从 0.5 降到 0.1,验证损失先从 0.6 降到 0.4,后来升到 0.7。模型更适应训练样本,却未继续改善独立样本表现,这可能是过拟合。
这只是解释现象的示意,不是前一课的实测结果。判断前还应确认验证处理固定、类别映射正确、集合独立,排除评估代码错误。曲线只有几次波动时,也不能立即给出确定结论。
过拟合与欠拟合的处理不同
训练与验证都差,可能是模型容量不足、优化不到位、数据质量差或任务定义不合理。训练明显更好而验证较差,才更值得检查泛化差距。增加训练轮数对这两种情况可能有相反作用。
先问模型是否在利用不稳定线索。例如汽车全在灰色地面、飞机全在蓝天,模型可能学背景颜色而非物体。增强能覆盖部分变化,但不能取代真正多样的数据。若现场常出现夜晚,单纯把白天图片亮度调低不等于已经拥有真实夜间成像分布。
数据增强的底线是保持目标语义
分类中常见的随机裁剪、翻转与颜色变化,要根据任务决定。飞机或汽车水平翻转通常不改变类别;识别文字或左右方向时则可能改变标签。裁剪过强如果把目标完全移走,原来的整图标签就不再可靠。
对于检测和分割,几何增强还必须同步变换框或掩码。图片翻转了,标签仍留在旧位置,会主动教给模型错误的对应关系。后续课程会具体处理这些输出形式。
下面只检查“翻转两次恢复原图”的张量关系,不依赖任何数据下载:
|
实际图像增强可使用 Torchvision 的变换工具;随机参数、数据类型与插值方式要与任务匹配。Torchvision transforms 文档
正则化不只是增加随机性
权重衰减对参数施加收缩倾向;Dropout 在训练中随机屏蔽部分激活,并按设计处理尺度;早停根据验证表现选择停止时机或最佳检查点。它们分别作用于参数、激活和模型选择过程。
model.eval() 会改变 Dropout、BatchNorm 等层的行为,但不等于关闭梯度;torch.no_grad() 则关闭梯度记录,不会自动切换这些层的模式。两者承担不同职责,评估时通常都需要。
正则化过强可能导致模型无法学会训练任务。比如激活被大量丢弃、颜色被改得面目全非、权重衰减过大,都可能同时损害训练和验证结果。不是“加得越多越专业”。
一次只改变一个因素
建立四组对照:原始基线、只加适度增强、只改权重衰减、再组合两者。保持数据划分、输入规则、模型初始化策略和评价流程一致。至少记录训练曲线、验证指标、错误样本与时间成本。
如果随机性影响较大,可使用多个种子重复比较,并报告均值和波动。不要从多次尝试中只挑最好的一次,却把它当成稳定效果。资源有限时也应清楚注明单次运行的局限。
增强仅用于训练。验证与测试需要确定的预处理,使同一输入对应可比较的结果。多裁剪评估等额外策略是独立的评测配置,使用时应明确说明计算预算。
练习
- 一个数字 6 的分类器是否可以随意旋转 180 度?
no_grad()后忘了eval(),Dropout 是否一定停止随机丢弃?- 模型在训练集与验证集都很差,是否应该马上增加 Dropout?
参考答案
不应随意旋转,可能改变为另一个数字或形成不合理样本。no_grad() 不切换训练模式,因此不能保证。两边都差时先检查输入、标签、优化和容量,增加 Dropout 可能进一步妨碍拟合。
下一课把“效果变好了”拆成明确的指标和错误类型,避免只依赖一条总准确率。
配套代码练习
实验:增强、Dropout 与早停
查看完整代码:main.py
"""增强、Dropout 与早停。运行方式与练习见 README.md。"""
import torch
from torch import nn
torch.manual_seed(7)
image = torch.arange(12).reshape(1,3,4).float()/11
flipped = image.flip(-1)
assert torch.equal(flipped.flip(-1),image)
print('原图第一行:',image[0,0].tolist(),'翻转:',flipped[0,0].tolist())
drop = nn.Dropout(0.5)
x = torch.ones(1000)
train = drop(x)
drop.eval()
assert torch.equal(drop(x),x)
print('训练时置零比例:',float((train==0).float().mean()))
# 示意验证损失,用于观察早停,不是实测训练曲线。
values = [0.9,0.7,0.6,0.64,0.68,0.7]
best, stale, best_epoch = float('inf'),0,0
for epoch,value in enumerate(values,1):
    if value < best: best,stale,best_epoch = value,0,epoch
    else: stale += 1
    if stale >= 2:
        print('早停轮次:',epoch,'应恢复轮次:',best_epoch)
        break
assert best_epoch == 3 and epoch == 5
在项目根目录执行;下载包解压后,在解压目录执行 python3 main.py。
cd 'content/posts/AI-深度学习/从零搭建视觉模型/13-过拟合数据增强与正则化/code' && python3 main.py本篇已附独立实验包,在代码卡片中查看源码、下载或复制运行命令。解压后执行 python3 main.py;依赖安装见包内 README.md。
观察目标: 连续两次没有改善时在第 5 轮停止,选择第 3 轮;eval 下 Dropout 保持输入不变。
动手修改: 将 patience 从 2 改为 3;解释数字字符分类为什么不适合任意水平翻转。
所有输入均在本篇代码中构造;运行范围和验证记录见包内 verification.md。