学习初稿 · 第 23 课。 本篇已开放网页阅读,用于先建立完整认识。文中手算值和示意记录不代表真实训练成绩;真实数据训练、预训练权重和板端测试以本篇具体说明为准,本篇已附代码练习,实际验证范围见文末与包内记录。
为什么把浮点数换成较少位数
权重和激活如果用更低位数表示,可能减少存储与内存流量,并利用硬件整数运算。但更少的可表示值意味着近似误差,实际速度也依赖执行后端是否提供高效内核。
量化不能自动补齐不支持的算子,也不是把文件压缩成 zip。推理时采用的数值表示和运算路径必须与模型格式、量化参数及硬件实现一起匹配。
用一个数看懂量化与反量化
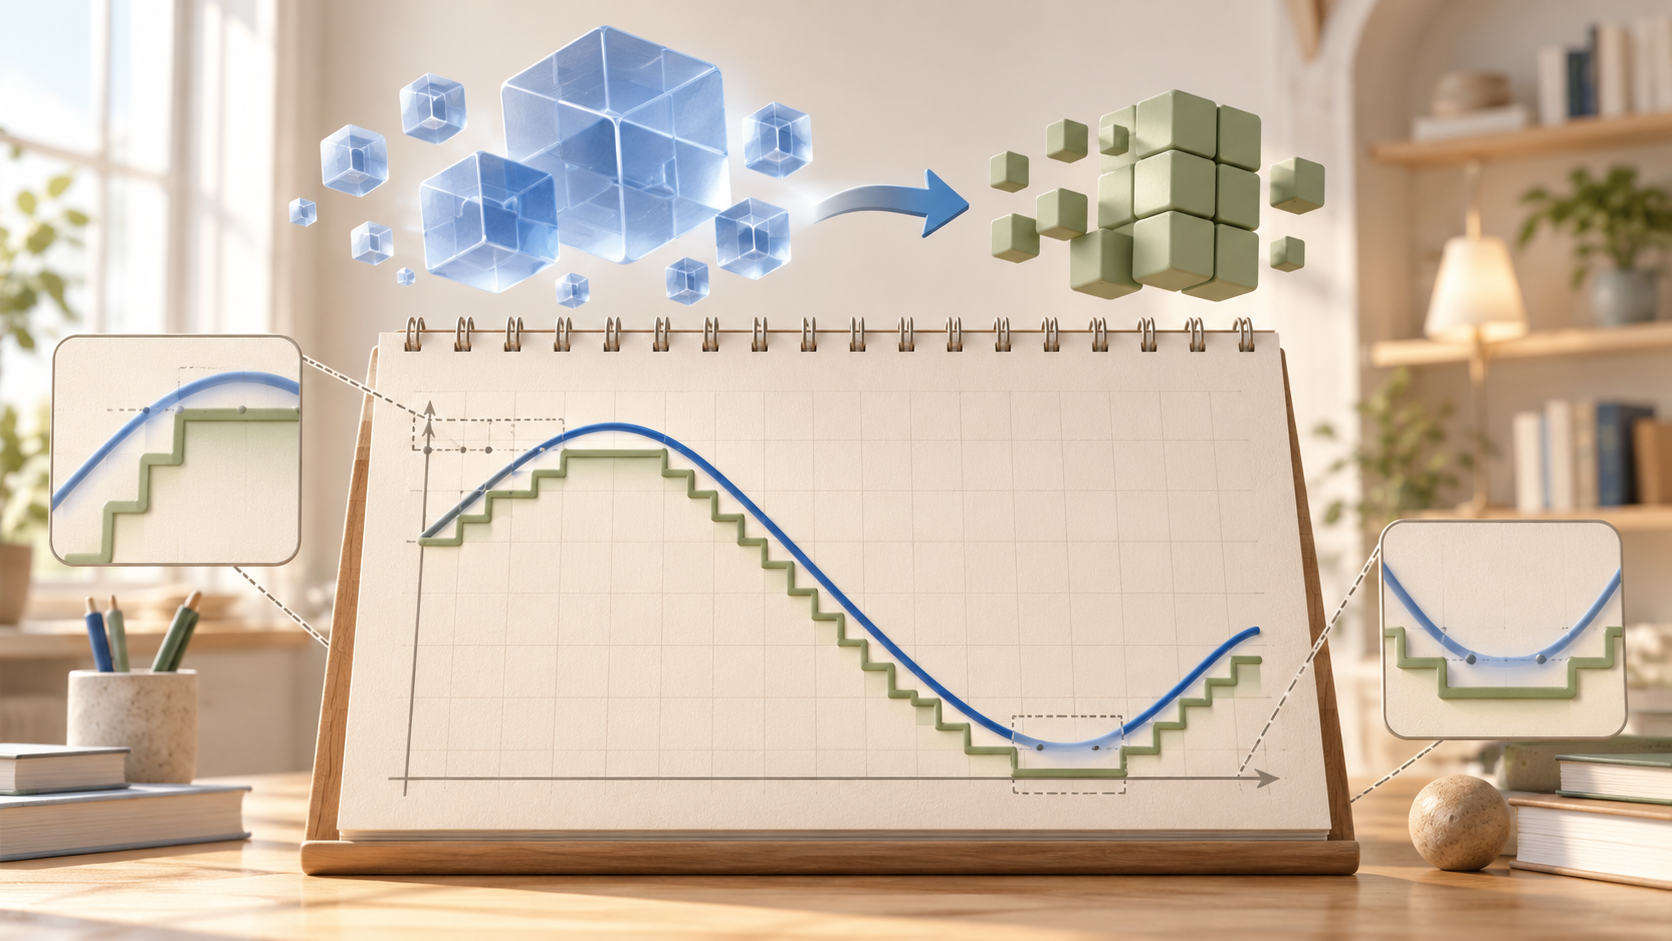
一种常见仿射表示为 q=clip(round(x/s)+z),反量化为 x_hat=(q-z)×s。s 是正的缩放因子,z 是零点,clip 限制整数范围。实际实现的舍入规则与量化范围需要核对。
取 s=0.1、z=0,x=0.26,得到 q=3,恢复为 0.3,误差 0.04。这说明量化后数值通常不能完全恢复。若输入范围超出整数能表示的区间,还会发生截断,而不只是舍入。
|
20.0 超过此设置的上界 12.7,误差远大于一个量化步长。真实模型需要根据张量分布与硬件支持选择范围,不能对所有层固定同一个随意的 scale。
对称、非对称与逐通道
对称量化通常围绕零安排范围,非对称量化可用零点表达偏移。逐张量使用一组量化参数,逐通道则为不同通道设置参数,可能更适合幅度差异明显的权重。是否支持、沿哪个轴量化,都由具体工具和算子决定。
权重量化与激活量化是不同维度。某种低比特权重格式可能仍用浮点激活;另一种实现则把两者都量化。只写“INT8 模型”不足以说明图中每一处精度。
校准数据决定观察到的范围
训练后静态量化常用代表性数据估计激活分布;动态量化会在运行时计算部分量化参数;量化感知训练则在训练中模拟相关误差。它们适用的算子、成本和工具链不同。ONNX Runtime 量化文档
校准集通常不需要任务标签,但需要与实际输入一致的预处理和分布。只用全黑图或少量相似图片,可能无法覆盖现场激活范围。校准不是独立测试,不能用最终测试集反复调整量化策略并继续声称测试独立。
对飞机汽车分类,应覆盖两类、不同亮度与背景。若将来上摄像头,公开小图片的校准并不保证现场可靠。数据来源、数量、预处理和校准方法应随模型一起记录。
分三层比较精度
先比较单个张量的浮点与反量化误差,定位是否存在明显截断;再比较网络 logits 或其他输出;最后在同一份验证数据上计算任务指标。一个整体平均误差很小的模型,也可能在少数关键样本上翻转类别。
应保存浮点正确、量化错误的样本列表,并按类别和条件分析。误差集中在某一层时,可以检查其范围、量化轴和算子实现;是否保留部分层高精度,需要工具链支持并重新测性能。
静态量化后图里可能出现量化与反量化节点。这些节点本身不证明硬件已经使用整数加速,应查看实际后端执行与 profiling。频繁跨精度转换可能抵消收益。
一份可比较的实验表
| 项目 | 浮点基线 | 量化模型 |
|---|---|---|
| 数据清单与预处理 | 同一版本 | 同一版本 |
| 模型文件与哈希 | 实际记录 | 实际记录 |
| 准确率与每类指标 | 实测 | 实测 |
| 峰值内存 | 实测 | 实测 |
| 预热后延迟 | 同设备同边界 | 同设备同边界 |
| 后端与回退情况 | 记录 | 记录 |
本草稿覆盖数值原理与实验设计,未执行真实模型静态量化,也未生成板端性能数据。后续实现时按目标平台选择具体工具,不把一个 CPU 量化命令冒充 NPU 转换流程。
练习
- s=0.2、z=0,0.52 的量化与恢复值是多少?
- 校准是否需要真实标签?是否可以随便用几张图片?
- 文件缩小四倍,延迟是否一定缩小四倍?
参考答案
按本课舍入方式为 3,恢复为 0.6。校准通常不需任务标签,但输入必须有代表性且预处理一致。文件大小与执行时间受不同因素影响,算子支持、内存、转换和计算共同决定延迟。
下一课把输入、模型、后处理和性能测量接成一个完整验收流程。
配套代码练习
实验:量化舍入、截断与误差
查看完整代码:main.py
"""量化舍入、截断与误差。运行方式与练习见 README.md。"""
values = [-2.0,-0.8,0.0,0.3,0.9,2.0]
def quantize(xs,scale):
    q = [max(-127,min(127,round(x/scale))) for x in xs]
    restored = [v*scale for v in q]
    error = max(abs(a-b) for a,b in zip(xs,restored))
    clipped = sum(abs(x/scale)>127 for x in xs)
    return q,restored,error,clipped
for limit in [1.0,2.0]:
    q,restored,error,clipped = quantize(values,limit/127)
    print('校准范围:',(-limit,limit),'整数:',q,'反量化:',restored,'最大误差:',error,'截断数:',clipped)
    if limit==2.0: assert error <= (limit/127)/2 + 1e-12 and clipped==0
    else: assert clipped==2 and error==1.0
在项目根目录执行;下载包解压后,在解压目录执行 python3 main.py。
cd 'content/posts/AI-深度学习/从零搭建视觉模型/23-量化与精度对比/code' && python3 main.py本篇已附独立实验包,在代码卡片中查看源码、下载或复制运行命令。解压后执行 python3 main.py;依赖安装见包内 README.md。
观察目标: 范围 [-1,1] 截断两个值,最大误差 1;覆盖 [-2,2] 后无截断且误差不超过半个量化步长。
动手修改: 加入一个 20.0 的离群值,用全范围和原范围分别量化,比较普通样本误差与截断误差。
所有输入均在本篇代码中构造;运行范围和验证记录见包内 verification.md。