学习初稿 · 第 16 课。 本篇已开放网页阅读,用于先建立完整认识。文中手算值和示意记录不代表真实训练成绩;真实数据训练、预训练权重和板端测试以本篇具体说明为准,本篇已附代码练习,实际验证范围见文末与包内记录。
网络加深以后,为什么不一定更好
小型 CNN 已经能建立分类闭环。接下来如果继续增加层数,模型的表达能力可能增强,但优化也可能变困难。更深的网络即使在训练集上表现变差,也不能一概归因于过拟合,因为过拟合通常体现为训练好、独立数据差。
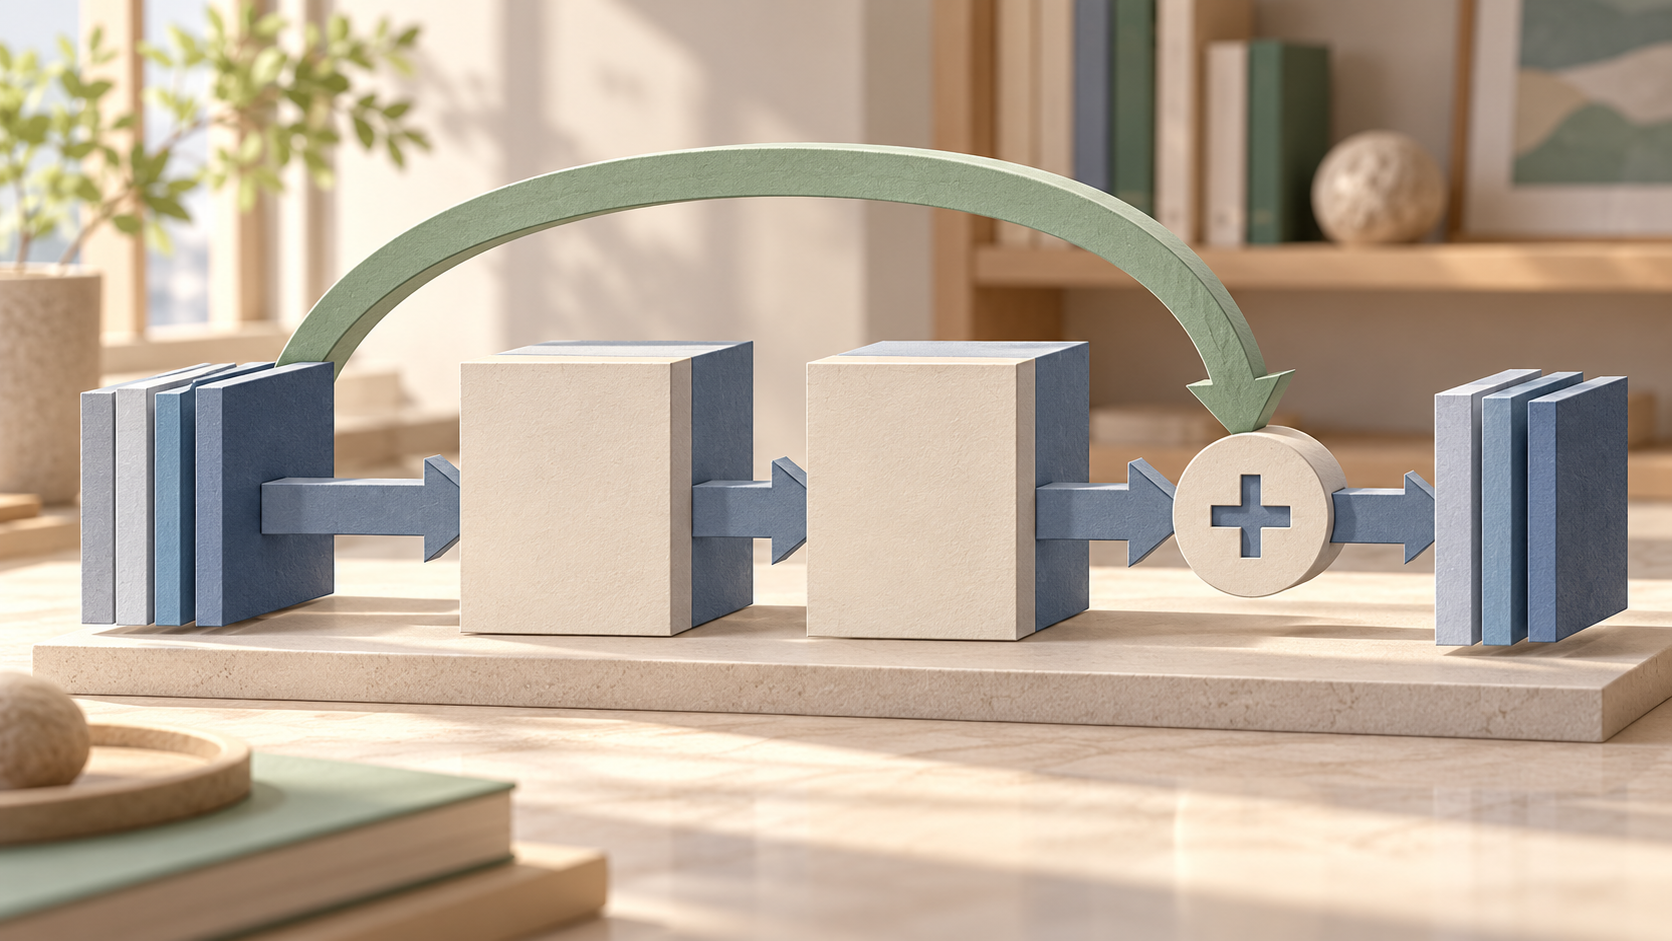
ResNet 的重要思路是让一组层学习相对于输入的改变量,再通过捷径把输入加回来。记输入为 x、分支变换为 F,输出先写成 y=x+F(x)。具体网络还可能在相加之后使用激活函数。ResNet 原论文
残差不是训练损失
这里的“残差”指网络分支学习的变换,不是标签减预测的误差。若当前合适的变换接近保持输入不变,学习一个较小的改变量可能比重新构造整个映射更方便。捷径也为梯度传播提供额外路径。
这并不保证任意加深都会提升精度,也不等于跳过了训练。分支中的卷积仍然需要学习,捷径需要遵守形状和数据类型约定。
相加之前先看形状
两个张量相加时,预期的空间位置和通道应正确对应。主分支如果把通道从 8 变成 16,或把宽高减半,就不能直接用原输入相加。常见做法是在捷径上使用 1×1 卷积及适当步长投影到匹配形状。
下面的小实验只验证一个同形状残差块,不使用预训练参数,也不展示真实分类结果:
|
不能为了让代码跑通就随意 reshape 一个分支。元素数量相同不意味着通道和位置语义相同,尤其在空间下采样后更不能用简单重排代替正确的投影。
BatchNorm 与 train、eval
BatchNorm 包含可学习参数,也包含运行统计。标准设置下,训练与评估使用统计的方式不同。因此模型进入 eval() 后,即使权重没有改,也可能与训练模式得到不同输出。
冻结参数的 requires_grad=False 不自动冻结运行统计;no_grad() 同样不切换层的模式。这一点在下一课冻结主干时尤其重要。若希望固定预训练特征,应明确设置相关层的行为。
ResNet-18 不等于一个模型文件
ResNet-18 是一种结构配置。随机初始化的 ResNet-18 与加载预训练权重的 ResNet-18,虽然结构相同,却不具备相同能力。用于原任务分类时,最后一层对应原类别数;迁移到飞机汽车二分类,需要明确更换分类头并训练它。
可先用 torchvision.models.resnet18(weights=None) 查看结构与输出,再在迁移课中讨论预训练参数。接口默认不加载预训练权重,具体预处理与权重配置应查对应文档。ResNet-18 官方接口
本系列的 32×32 小图片与常见 ImageNet 预训练的输入处理不同。放大图片不会恢复原本不存在的细节,也不能保证直接迁移一定更优,因此需要与小 CNN 基线比较。
练习
- 主分支输出
[2,16,8,8],捷径是[2,8,16,16],能否直接相加? - 冻结卷积权重后,BatchNorm 统计是否一定不变?
- 为什么随机 ResNet 能前向计算,却不能当预训练分类器使用?
参考答案
不能,需要对齐通道与空间尺寸,例如设计合适的投影捷径。运行统计受模式与配置影响,不随参数冻结自动停止更新。结构只规定计算方式,语义识别能力还依赖训练得到的参数及正确输入处理。
下一课把结构与预训练参数连接起来,学习先训练分类头,再逐步微调。
配套代码练习
实验:残差分支形状与投影
查看完整代码:main.py
"""残差分支形状与投影。运行方式与练习见 README.md。"""
import torch
from torch import nn
torch.manual_seed(7)
torch.set_num_threads(2)
class Block(nn.Module):
    def __init__(self,cin,cout,stride=1):
        super().__init__()
        self.main = nn.Sequential(nn.Conv2d(cin,cout,3,stride,padding=1),nn.ReLU(),nn.Conv2d(cout,cout,3,padding=1))
        self.skip = nn.Identity() if cin==cout and stride==1 else nn.Conv2d(cin,cout,1,stride)
    def forward(self,x):
        main,skip = self.main(x),self.skip(x)
        assert main.shape == skip.shape
        return torch.relu(main+skip)
x = torch.randn(2,8,16,16,requires_grad=True)
for cout,stride in [(8,1),(16,2)]:
    block = Block(8,cout,stride)
    y = block(x)
    y.mean().backward()
    assert torch.isfinite(x.grad).all()
    print('input',tuple(x.shape),'output',tuple(y.shape),'skip',type(block.skip).__name__)
在项目根目录执行;下载包解压后,在解压目录执行 python3 main.py。
cd 'content/posts/AI-深度学习/从零搭建视觉模型/16-ResNet与残差连接/code' && python3 main.py本篇已附独立实验包,在代码卡片中查看源码、下载或复制运行命令。解压后执行 python3 main.py;依赖安装见包内 README.md。
观察目标: 同形状块输出 [2,8,16,16];投影块输出 [2,16,8,8]。
动手修改: 把降采样块的 skip 强制换成 Identity,观察报错并手算两条分支形状。
所有输入均在本篇代码中构造;运行范围和验证记录见包内 verification.md。
完整阅读目录 · 上一篇:MLP 综合实践 · 下一篇