本篇已于 2026-10-06 完成学习。示例代码及六道练习参考答案已在本机 CPU 上运行验证,答案默认折叠。第一、二题保留实际提交的练习总结,第三至六题按复习需要补齐参考实现与要点说明。
如果还不熟悉 Python,先完成《Python 起步:写给 C/C++ 开发者》及其配套实验,再继续本篇。
如果已经会写代码,却还不清楚为什么调整维度、转浮点数或除以 255,先读《视觉模型入门:从像素到张量的基础概念》。本篇随后通过实验验证这些概念。
这次想弄懂什么
在《模型基础知识》中,模型被类比成一个函数:输入张量,经过计算,得到输出张量。
这次从这个函数的输入开始:磁盘上的一张图片,怎样变成代码里的张量?看到 [1, 3, 224, 320] 时,每一个数字分别表示什么?
本篇完成后,应当能把图片的宽、高、颜色通道,与张量里的数字逐个对应起来。后续再沿着“小型 CNN → 训练 → 评估 → 保存与预测”的顺序继续。
先看清一张只有 6 个像素的图片
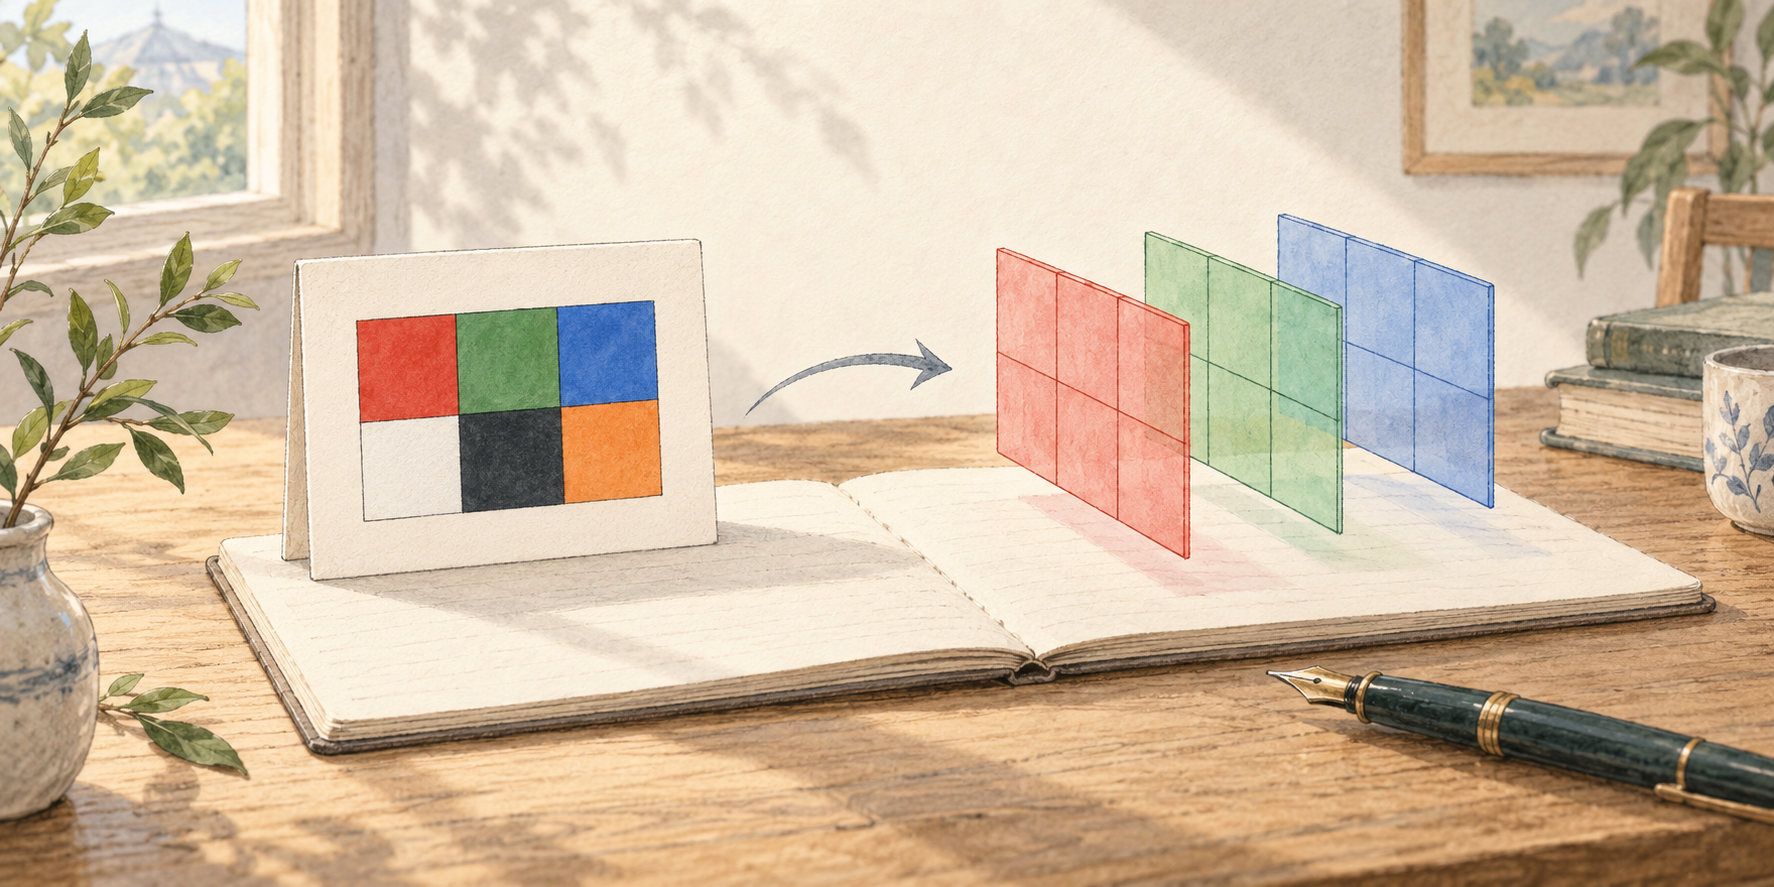
实验目录中的 sample.ppm 是一张 RGB 图片,宽 3 像素、高 2 像素。它采用文本格式,可以直接用编辑器打开。
| 位置 |
第 0 列 |
第 1 列 |
第 2 列 |
| 第 0 行 |
红 (255, 0, 0) |
绿 (0, 255, 0) |
蓝 (0, 0, 255) |
| 第 1 行 |
白 (255, 255, 255) |
黑 (0, 0, 0) |
橙 (255, 128, 0) |
这里每个像素有 R、G、B 三个数,分别描述红、绿、蓝通道的强度。示例采用 8 位无符号整数,每个通道的数值范围是 0~255。
图片文件中的存储方式与解码后的像素数组是两回事。本课用 Pillow 解码图片,再显式转换为 RGB,统一得到三个通道。Pillow 的图片打开与模式转换接口见官方文档。
跑一次实验
实验 01:图片如何变成张量
在项目根目录执行;下载包解压后,在解压目录执行 python3 main.py。
cd 'content/posts/AI-深度学习/从零搭建视觉模型/04-图片如何变成张量/code' && python3 main.py
代码位于项目中的:
1
2
3
4
5
6
7
8
9 | 04-图片如何变成张量/
├── articles/图片如何变成张量.md
├── images/封面.png
└── code/
├── README.md
├── requirements.txt
├── main.py
├── sample.ppm
└── verification.md
|
本机已有依赖,在博客项目根目录执行:
1 | python3 content/posts/AI-深度学习/从零搭建视觉模型/04-图片如何变成张量/code/main.py
|
如果是新环境,先按 本篇 code/README.md 创建虚拟环境并安装依赖。本课使用 CPU,不需要配置 GPU。
以下是示例图片的实际输出节选:
1
2
3
4
5
6
7
8
9
10 | 原始图片: mode=RGB, size(W,H)=(3, 2)
处理后图片: mode=RGB, size(W,H)=(3, 2)
NumPy HWC: shape=(2, 3, 3), dtype=uint8
左上角 RGB: [255, 0, 0]
Tensor HWC: shape=(2, 3, 3), dtype=torch.uint8
Tensor CHW: shape=(3, 2, 3), dtype=torch.uint8
CHW 左上角 RGB: [255, 0, 0]
float CHW: shape=(3, 2, 3), dtype=torch.float32, range=[0.0000, 1.0000]
模型输入 NCHW: shape=(1, 3, 2, 3), dtype=torch.float32, device=cpu
输入左上角 RGB: [1.0, 0.0, 0.0]
|
这次只生成了待送入模型的数据,没有定义网络,也没有发生训练。
从 HWC 到 NCHW
下面是完整脚本中最需要理解的几行。image 是已经由 Pillow 读取并转换成 RGB 的图片。
1
2
3
4
5 | pixels = np.array(image, dtype=np.uint8, copy=True)
hwc = torch.from_numpy(pixels)
chw = hwc.permute(2, 0, 1).contiguous()
scaled = chw.to(dtype=torch.float32) / 255.0
batch = scaled.unsqueeze(0)
|
第一步:像素数组 HWC
NumPy 数组的形状是 (2, 3, 3),三个维度分别是:
| 符号 |
含义 |
本例数值 |
| H |
Height,高,对应行数 |
2 |
| W |
Width,宽,对应列数 |
3 |
| C |
Channel,通道数 |
3 |
pixels[0, 0] 取的是第 0 行、第 0 列的全部通道,结果为 [255, 0, 0]。
注意:Pillow 的 image.size 使用 (W, H),这个 NumPy 数组使用 (H, W, C)。图片没有旋转,只是两个接口描述尺寸的顺序不同。
torch.from_numpy 把数组接入 PyTorch 中,保留形状和数据类型,并共享底层内存;这一步本身没有缩放像素。接口说明
第二步:调整为 CHW
原来维度的编号是 0=H、1=W、2=C。
1 | chw = hwc.permute(2, 0, 1).contiguous()
|
permute(2, 0, 1) 把通道维放到前面,因此得到 (3, 2, 3)。此时取左上角三个颜色值需要写成 chw[:, 0, 0],结果仍是 [255, 0, 0]。
这是维度顺序的调整,RGB 的颜色含义保持不变。contiguous() 在需要时整理内存布局,便于后续操作;permute 的维度置换语义见官方文档。
不要用 reshape(3, H, W) 代替这一步:改形状不能代替按轴重排,得到相同的形状也不代表像素对应正确。
第三步:转换类型并缩放数值
1 | scaled = chw.to(dtype=torch.float32) / 255.0
|
红色像素从 [255, 0, 0] 变为 [1.0, 0.0, 0.0]。形状仍是 CHW,变化的是类型和数值尺度。
这里做的是把 8 位像素缩放到 [0, 1],尚未做减均值、除标准差等处理。图片不一定包含纯黑或纯白,所以换一张图片后,实际最小值和最大值不一定恰好是 0 和 1。
第四步:增加批次维度 N
1 | batch = scaled.unsqueeze(0)
|
unsqueeze(0) 在开头插入一个长度为 1 的维度,得到 (1, 3, 2, 3);本例的 N=1 表示这一批只有一张图片。接口说明
对于接下来准备搭建的 PyTorch CNN,采用如下输入约定:
1 | NCHW = 批次中的图片数 × 通道数 × 图片高度 × 图片宽度
|
具体模型的输入类型、布局、颜色顺序和预处理要求需要单独确认。此前项目笔记中的部署模型示例,以及本课的 float32 RGB NCHW,不能直接当作所有模型通用的输入规范。
自己改两次参数
先使用不相等的宽、高,防止正方形图片掩盖维度顺序问题:
1 | python3 content/posts/AI-深度学习/从零搭建视觉模型/04-图片如何变成张量/code/main.py --resize 320 224
|
--resize 的参数顺序是宽、高。最终张量应当是 (1, 3, 224, 320)。本例会直接拉伸图片,实际项目是否需要保留比例、裁剪或填充,要根据任务与模型要求决定。
再换一张自己的图片:
1 | python3 content/posts/AI-深度学习/从零搭建视觉模型/04-图片如何变成张量/code/main.py /你的图片路径/photo.jpg
|
运行前先猜测最终形状,再与输出对照。也可以找一张灰度图,观察原始模式与转换成 RGB 之后通道数的区别。
课后练习
下面 6 道题覆盖本篇的主要操作,每题参考答案放在题目下方,默认折叠,点击后展开。可以继续使用 playground/test.py,也可以在本篇 code/ 下新建 practice_01.py 等文件。读取本篇的 sample.ppm 时,根据脚本实际位置确定路径,不依赖终端当前目录;若脚本在 playground/,可使用放在该目录中的同一份示例图片。
本课使用 Pillow、NumPy 和 PyTorch,全部在 CPU 上完成。不需要写网络或训练模型。打印形状时可使用 tuple(tensor.shape),打印通道值时可使用 .tolist()。
练习 1:同一个像素,两种索引
读取 sample.ppm 并转换为 RGB,建立 uint8 NumPy 数组,再转成 PyTorch 的 HWC 张量和 CHW 张量。
要求:
- 打印 NumPy 数组、HWC 张量、CHW 张量的形状。
- 分别从 HWC 和 CHW 张量中取出第二行、第三列的橙色像素。
- 从 CHW 张量中提取整张图的 G 通道。
预期结果:
1
2
3
4
5
6 | NumPy: (2, 3, 3)
HWC: (2, 3, 3)
CHW: (3, 2, 3)
HWC 橙色像素: [255, 128, 0]
CHW 橙色像素: [255, 128, 0]
G 通道: [[0, 255, 0], [255, 0, 128]]
|
用 permute 调整维度。像素值必须从张量中取出,不能直接写进输出。
点击查看第一题参考答案与本次练习总结
参考答案
保留本次实现中的读取、转换和索引操作,整理为只处理默认示例图片的版本。脚本与 sample.ppm 放在同一目录,可保存为本篇 code/practice_01.py。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27 | from pathlib import Path
import numpy as np
import torch
from PIL import Image
def main():
path = Path(__file__).resolve().parent / "sample.ppm"
with Image.open(path) as source:
image = source.convert("RGB")
pixels = np.array(image, dtype=np.uint8, copy=True)
hwc = torch.from_numpy(pixels)
chw = hwc.permute(2, 0, 1).contiguous()
print(f"NumPy: {pixels.shape}")
print(f"HWC: {tuple(hwc.shape)}")
print(f"CHW: {tuple(chw.shape)}")
print(f"HWC 橙色像素: {hwc[1, 2, :].tolist()}")
print(f"CHW 橙色像素: {chw[:, 1, 2].tolist()}")
print(f"G 通道: {chw[1, :, :].tolist()}")
print(f"两种布局的 G 通道相同: {torch.equal(hwc[:, :, 1], chw[1])}")
if __name__ == "__main__":
main()
|
预期输出:
1
2
3
4
5
6
7 | NumPy: (2, 3, 3)
HWC: (2, 3, 3)
CHW: (3, 2, 3)
HWC 橙色像素: [255, 128, 0]
CHW 橙色像素: [255, 128, 0]
G 通道: [[0, 255, 0], [255, 0, 128]]
两种布局的 G 通道相同: True
|
本次练习总结(2026-10-06)
本次提交的形状、橙色像素和 G 通道输出全部正确,没有逻辑错误。还分别从 HWC 和 CHW 中提取了 G 通道,验证了调整轴顺序后像素对应关系保持不变。
- 同一个像素,不同布局的索引不同。 HWC 用
hwc[1, 2, :],CHW 用 chw[:, 1, 2],结果都是 [255, 128, 0]。行下标 1、列下标 2 没有改变,只是通道轴的位置变了。
- 提取 G 通道时保留全部行列。 HWC 用
hwc[:, :, 1],CHW 用 chw[1, :, :];后者也可以简写为 chw[1]。
- 张量的显示格式不影响结果。 原代码直接打印张量,显示为带有
tensor(...) 和 dtype 的形式;答案使用 .tolist() 方便与题目中的列表格式对照,两种打印方式都正确。
- 固定索引需要匹配输入尺寸。 原代码保留了
--resize,但 [1, 2] 要求图片至少有 2 行、3 列。调整尺寸后,这个位置也未必仍是橙色。本题使用默认 3×2 示例,不调整尺寸;尺寸变换留到后续练习处理。
练习 2:缩放改变了什么
编写 scale_channels(chw),接收 uint8 CHW 张量,返回 float32 张量,将通道值从 0~255 缩放到 0~1。
要求不修改传入张量。用第一题的 CHW 张量检查:
- 返回形状仍为
(3, 2, 3),类型为 torch.float32。
- 红色像素变为
[1.0, 0.0, 0.0]。
- 橙色像素约为
[1.0, 0.501961, 0.0]。
- 原张量仍为
torch.uint8,橙色像素仍为 [255, 128, 0]。
再用通道值全为 128、形状为 (3, 2, 3) 的 uint8 张量调用函数:结果的最小值和最大值都应约为 0.501961,不应强行变成 0 和 1。可以用 torch.full 创建这份输入。
点击查看第二题参考答案与本次练习总结
参考答案
本次的缩放函数实现正确。下面省去不必要的复制,补齐原张量未改变和全 128 输入的检查。脚本与 sample.ppm 放在同一目录,可保存为本篇 code/practice_02.py。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39 | from pathlib import Path
import numpy as np
import torch
from PIL import Image
def scale_channels(chw_uint8):
chw_float = chw_uint8.to(dtype=torch.float32)
return chw_float / 255.0
def main():
image_path = Path(__file__).resolve().parent / "sample.ppm"
with Image.open(image_path) as source:
image = source.convert("RGB")
pixels = np.array(image, dtype=np.uint8, copy=True)
hwc_uint8 = torch.from_numpy(pixels)
chw_uint8 = hwc_uint8.permute(2, 0, 1).contiguous()
original_chw = chw_uint8.clone()
scaled_chw = scale_channels(chw_uint8)
print(f"缩放后形状: {tuple(scaled_chw.shape)}")
print(f"缩放后类型: {scaled_chw.dtype}")
print(f"红色像素: {scaled_chw[:, 0, 0].tolist()}")
print(f"橙色像素: {scaled_chw[:, 1, 2].tolist()}")
print(f"原张量类型: {chw_uint8.dtype}")
print(f"原橙色像素: {chw_uint8[:, 1, 2].tolist()}")
print(f"原张量数值未变: {torch.equal(chw_uint8, original_chw)}")
uniform_chw = torch.full((3, 2, 3), 128, dtype=torch.uint8)
scaled_uniform_chw = scale_channels(uniform_chw)
print(f"全 128 缩放后最小值: {scaled_uniform_chw.min().item():.6f}")
print(f"全 128 缩放后最大值: {scaled_uniform_chw.max().item():.6f}")
if __name__ == "__main__":
main()
|
预期输出:
1
2
3
4
5
6
7
8
9 | 缩放后形状: (3, 2, 3)
缩放后类型: torch.float32
红色像素: [1.0, 0.0, 0.0]
橙色像素: [1.0, 0.501960813999176, 0.0]
原张量类型: torch.uint8
原橙色像素: [255, 128, 0]
原张量数值未变: True
全 128 缩放后最小值: 0.501961
全 128 缩放后最大值: 0.501961
|
变量名用来说明数据当前的含义:chw_uint8 是尚未缩放的整数张量,chw_float 是只转换了类型的浮点张量,scaled_chw 是完成缩放的结果。original_chw 保存调用前的数据,供后续比较;uniform_chw 表示所有通道值相同的输入,比 test 或 new_scale 更容易理解。
本次练习总结(2026-10-06)
- 原实现正确,没有修改输入。 先
clone(),再转为 float32 并除以 255,能得到题目要求的结果。本次提交只打印了缩放结果,尚未写出全部验证,尤其缺少全 128 输入的检查;上面的答案已补齐。
- 函数中的
clone() 可以省略。 本题输入为 uint8,转成 float32 时会产生新的张量,普通 / 运算也不会原地修改输入。这里不能推广成“所有 .to() 都会复制”:输入已经符合目标类型和设备时,.to() 可能直接返回原张量。
- 验证用的副本仍有用途。
original_chw = chw_uint8.clone() 保存调用前的数值,之后用 torch.equal() 比较;如果只写 original_chw = chw_uint8,两个变量指向同一个张量,就无法靠它发现原地修改。
- 转换类型和缩放是两步。
.to(dtype=torch.float32) 将整数 255 变为浮点数 255.0,随后 / 255.0 才将它变为 1.0;两步都不改变形状。
- 缩放后不一定出现 0 和 1。 每个值固定除以 255,因此全 128 输入的最小值和最大值都约为
0.501961。[0, 1] 描述允许的数值范围,不要求每张图片都包含两个端点。
.item() 和显示精度。 .min()、.max() 返回只有一个值的张量,.item() 将其取为 Python 数值;:.6f 仅让输出保留六位小数,不会改变张量中的数据。
练习 3:封装一张图片的模型输入
编写 image_to_batch(path, size=None),返回一张图片对应的 float32 RGB NCHW 张量,数值范围为 [0, 1]。
要求依次完成读取、转换 RGB、可选尺寸调整、转张量、调整维度、缩放和增加批次维度。size 为 None 时保留原尺寸;否则是 (宽, 高) 元组。
用示例图片验证:
| 调用条件 |
返回形状 |
不传 size |
(1, 3, 2, 3) |
size=(5, 4) |
(1, 3, 4, 5) |
size=(320, 224) |
(1, 3, 224, 320) |
检查不调整尺寸时的橙色像素,结果应约为 [1.0, 0.501961, 0.0]。调整尺寸可能改变像素值,本题对调整后的图片只检查形状、类型和数值范围。
点击查看第三题参考答案与要点
参考答案
以下代码可独立运行,保存时与 sample.ppm 放在同一目录。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31 | from pathlib import Path
import numpy as np
import torch
from PIL import Image, ImageOps
def image_to_batch(path, size=None):
with Image.open(path) as source:
image = ImageOps.exif_transpose(source).convert("RGB")
if size is not None:
image = image.resize(size, Image.Resampling.BILINEAR)
pixels = np.array(image, dtype=np.uint8, copy=True)
hwc_uint8 = torch.from_numpy(pixels)
chw_uint8 = hwc_uint8.permute(2, 0, 1).contiguous()
scaled_chw = chw_uint8.to(dtype=torch.float32) / 255.0
return scaled_chw.unsqueeze(0)
image_path = Path(__file__).resolve().parent / "sample.ppm"
for size in (None, (5, 4), (320, 224)):
batch = image_to_batch(image_path, size)
expected_shape = (1, 3, 2, 3) if size is None else (1, 3, size[1], size[0])
assert tuple(batch.shape) == expected_shape
assert batch.dtype == torch.float32 and batch.device.type == "cpu"
assert 0.0 <= batch.min().item() <= batch.max().item() <= 1.0
print(f"size={size}: shape={tuple(batch.shape)}, dtype={batch.dtype}")
if size is None:
orange = batch[0, :, 1, 2]
assert torch.allclose(orange, torch.tensor([1.0, 128 / 255, 0.0]))
print(f"橙色像素: {orange.tolist()}")
|
预期输出:
1
2
3
4 | size=None: shape=(1, 3, 2, 3), dtype=torch.float32
橙色像素: [1.0, 0.501960813999176, 0.0]
size=(5, 4): shape=(1, 3, 4, 5), dtype=torch.float32
size=(320, 224): shape=(1, 3, 224, 320), dtype=torch.float32
|
要点说明
size 按 Pillow 的 (宽, 高) 传入,返回形状按 NCHW 排列。unsqueeze(0) 只增加批次轴,不复制出另一张图片。这里使用双线性插值;调整尺寸后检查形状、类型与范围,不继续要求固定位置保持原来的橙色。assert 用于验证示例结果,条件不成立时会抛出 AssertionError。
练习 4:共享内存与独立副本
重新读取示例图片,建立 pixels NumPy 数组,再执行:
1
2 | hwc = torch.from_numpy(pixels)
independent = hwc.clone()
|
按顺序完成以下操作并打印结果:
- 将
hwc 的左上角 R 通道改为 0,检查 pixels 左上角是否也变为 [0, 0, 0]。
- 检查
independent 左上角,仍应为 [255, 0, 0]。
- 将
independent 左上角改为 [10, 20, 30],检查 hwc 和 pixels 的左上角仍为 [0, 0, 0]。
这里只修改内存,不覆盖图片文件。.clone() 是本题需要补充的新方法,用于复制张量数据;可以借助上一课的 NumPy .copy() 来理解。
点击查看第四题参考答案与要点
参考答案
以下代码可独立运行,保存时与 sample.ppm 放在同一目录。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23 | from pathlib import Path
import numpy as np
import torch
from PIL import Image
image_path = Path(__file__).resolve().parent / "sample.ppm"
with Image.open(image_path) as source:
pixels = np.array(source.convert("RGB"), dtype=np.uint8, copy=True)
hwc = torch.from_numpy(pixels)
independent = hwc.clone()
hwc[0, 0, 0] = 0
print(f"修改原张量后 pixels 左上角: {pixels[0, 0].tolist()}")
print(f"副本左上角: {independent[0, 0].tolist()}")
assert pixels[0, 0].tolist() == [0, 0, 0]
assert independent[0, 0].tolist() == [255, 0, 0]
independent[0, 0] = torch.tensor([10, 20, 30], dtype=torch.uint8)
print(f"修改副本后 independent 左上角: {independent[0, 0].tolist()}")
print(f"hwc 左上角: {hwc[0, 0].tolist()}")
print(f"pixels 左上角: {pixels[0, 0].tolist()}")
assert hwc[0, 0].tolist() == pixels[0, 0].tolist() == [0, 0, 0]
|
预期输出:
1
2
3
4
5 | 修改原张量后 pixels 左上角: [0, 0, 0]
副本左上角: [255, 0, 0]
修改副本后 independent 左上角: [10, 20, 30]
hwc 左上角: [0, 0, 0]
pixels 左上角: [0, 0, 0]
|
要点说明
torch.from_numpy() 与 NumPy 数组共享底层数据,因此修改 hwc 会影响 pixels。clone() 保存独立副本,之后两边的修改互不影响。写成 independent = hwc 只是让另一个变量引用同一个张量,无法得到独立副本。
练习 5:形状相同,像素不一定相同
重新建立原始 HWC 张量,分别得到两份结果:
1
2 | correct = hwc.permute(2, 0, 1)
wrong = hwc.reshape(3, 2, 3)
|
打印两者形状,再分别取出“通道维上的左上角三个值”和橙色位置的三个值。
预期结果:
1
2
3
4
5
6 | correct 形状: (3, 2, 3)
wrong 形状: (3, 2, 3)
correct 左上角: [255, 0, 0]
wrong 左上角: [255, 0, 0]
correct 橙色位置: [255, 128, 0]
wrong 橙色位置: [0, 255, 0]
|
这张图片中,错误写法碰巧能通过左上角检查。请用 torch.equal(correct, wrong) 比较全部元素,应得到 False;不要只凭形状或单个像素判断转换正确。
点击查看第五题参考答案与要点
参考答案
以下代码可独立运行,保存时与 sample.ppm 放在同一目录。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23 | from pathlib import Path
import numpy as np
import torch
from PIL import Image
image_path = Path(__file__).resolve().parent / "sample.ppm"
with Image.open(image_path) as source:
pixels = np.array(source.convert("RGB"), dtype=np.uint8, copy=True)
hwc = torch.from_numpy(pixels)
correct = hwc.permute(2, 0, 1)
wrong = hwc.reshape(3, 2, 3)
print(f"correct 形状: {tuple(correct.shape)}")
print(f"wrong 形状: {tuple(wrong.shape)}")
print(f"correct 左上角: {correct[:, 0, 0].tolist()}")
print(f"wrong 左上角: {wrong[:, 0, 0].tolist()}")
print(f"correct 橙色位置: {correct[:, 1, 2].tolist()}")
print(f"wrong 橙色位置: {wrong[:, 1, 2].tolist()}")
print(f"全部元素相同: {torch.equal(correct, wrong)}")
assert correct[:, 1, 2].tolist() == [255, 128, 0]
assert wrong[:, 1, 2].tolist() == [0, 255, 0]
assert not torch.equal(correct, wrong)
|
预期输出:
1
2
3
4
5
6
7 | correct 形状: (3, 2, 3)
wrong 形状: (3, 2, 3)
correct 左上角: [255, 0, 0]
wrong 左上角: [255, 0, 0]
correct 橙色位置: [255, 128, 0]
wrong 橙色位置: [0, 255, 0]
全部元素相同: False
|
要点说明
permute 按轴重新解释索引:结果的 [c, h, w] 对应原来的 [h, w, c]。reshape 按元素的逻辑顺序重新分组,不会替你把同一通道的值收集到一起。本例左上角碰巧相同,橙色位置和全量比较才暴露了错误。
练习 6:把两张图片组成一批
取得第二题缩放后的 CHW 张量,记为 first。复制得到 second,把 second 的全部 B 通道设为 0,再将两份 CHW 张量组成一批。
本题可以使用新接口 torch.stack([first, second], dim=0),它在指定位置增加一个维度并堆叠数据,要求输入张量形状相同。
要求:
- 批次形状为
(2, 3, 2, 3),类型为 torch.float32。
- 批次中第一张图片的第一行、第三列像素为
[0.0, 0.0, 1.0]。
- 批次中第二张图片的同一像素为
[0.0, 0.0, 0.0]。
first 原来的蓝色像素仍为 [0.0, 0.0, 1.0]。
这里从 CHW 开始堆叠,不要先分别增加批次维度,否则会多出一层维度。完成这题后,你就实际构造了一份含两张图片的 NCHW 模型输入。
点击查看第六题参考答案与要点
参考答案
以下代码可独立运行,保存时与 sample.ppm 放在同一目录。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27 | from pathlib import Path
import numpy as np
import torch
from PIL import Image
image_path = Path(__file__).resolve().parent / "sample.ppm"
with Image.open(image_path) as source:
pixels = np.array(source.convert("RGB"), dtype=np.uint8, copy=True)
hwc = torch.from_numpy(pixels)
chw_uint8 = hwc.permute(2, 0, 1).contiguous()
first = chw_uint8.to(dtype=torch.float32) / 255.0
second = first.clone()
second[2, :, :] = 0
batch = torch.stack([first, second], dim=0)
print(f"批次形状: {tuple(batch.shape)}")
print(f"批次类型: {batch.dtype}")
print(f"第一张图片原蓝色位置: {batch[0, :, 0, 2].tolist()}")
print(f"第二张图片原蓝色位置: {batch[1, :, 0, 2].tolist()}")
print(f"first 原蓝色位置: {first[:, 0, 2].tolist()}")
assert tuple(batch.shape) == (2, 3, 2, 3)
assert batch.dtype == torch.float32
assert batch[0, :, 0, 2].tolist() == [0.0, 0.0, 1.0]
assert batch[1, :, 0, 2].tolist() == [0.0, 0.0, 0.0]
assert first[:, 0, 2].tolist() == [0.0, 0.0, 1.0]
|
预期输出:
1
2
3
4
5 | 批次形状: (2, 3, 2, 3)
批次类型: torch.float32
第一张图片原蓝色位置: [0.0, 0.0, 1.0]
第二张图片原蓝色位置: [0.0, 0.0, 0.0]
first 原蓝色位置: [0.0, 0.0, 1.0]
|
要点说明
clone() 让第二张图片可以单独修改;B 通道的下标是 2,second[2] = 0 也是同样的写法。stack 在 CHW 外增加 N 轴,得到 NCHW;如果先把每张图片变成 (1, 3, 2, 3) 再 stack,会得到多一层的 (2, 1, 3, 2, 3)。
本篇完成后
现在已经把磁盘上的 RGB 图片转换成了 float32 NCHW 输入:读取并统一颜色模式 → 建立 HWC 数组 → 调整为 CHW → 转浮点并除以 255 → 增加批次维度。也能区分形状变化、数值变化和内存共享,构造含两张图片的批次。
下一步是定义一个小型 CNN,观察张量经过卷积、激活、池化和输出层后的形状变化,再学习标签、损失函数与训练循环。本篇得到的是模型输入,尚未训练模型。