学习初稿 · 第 12 课。 本篇已开放网页阅读,用于先建立完整认识。文中手算值和示意记录不代表真实训练成绩;真实数据训练、预训练权重和板端测试以本篇具体说明为准,本篇已附独立实验包;离线流程检查与真实数据训练分别记录。
从条纹走向真实图片
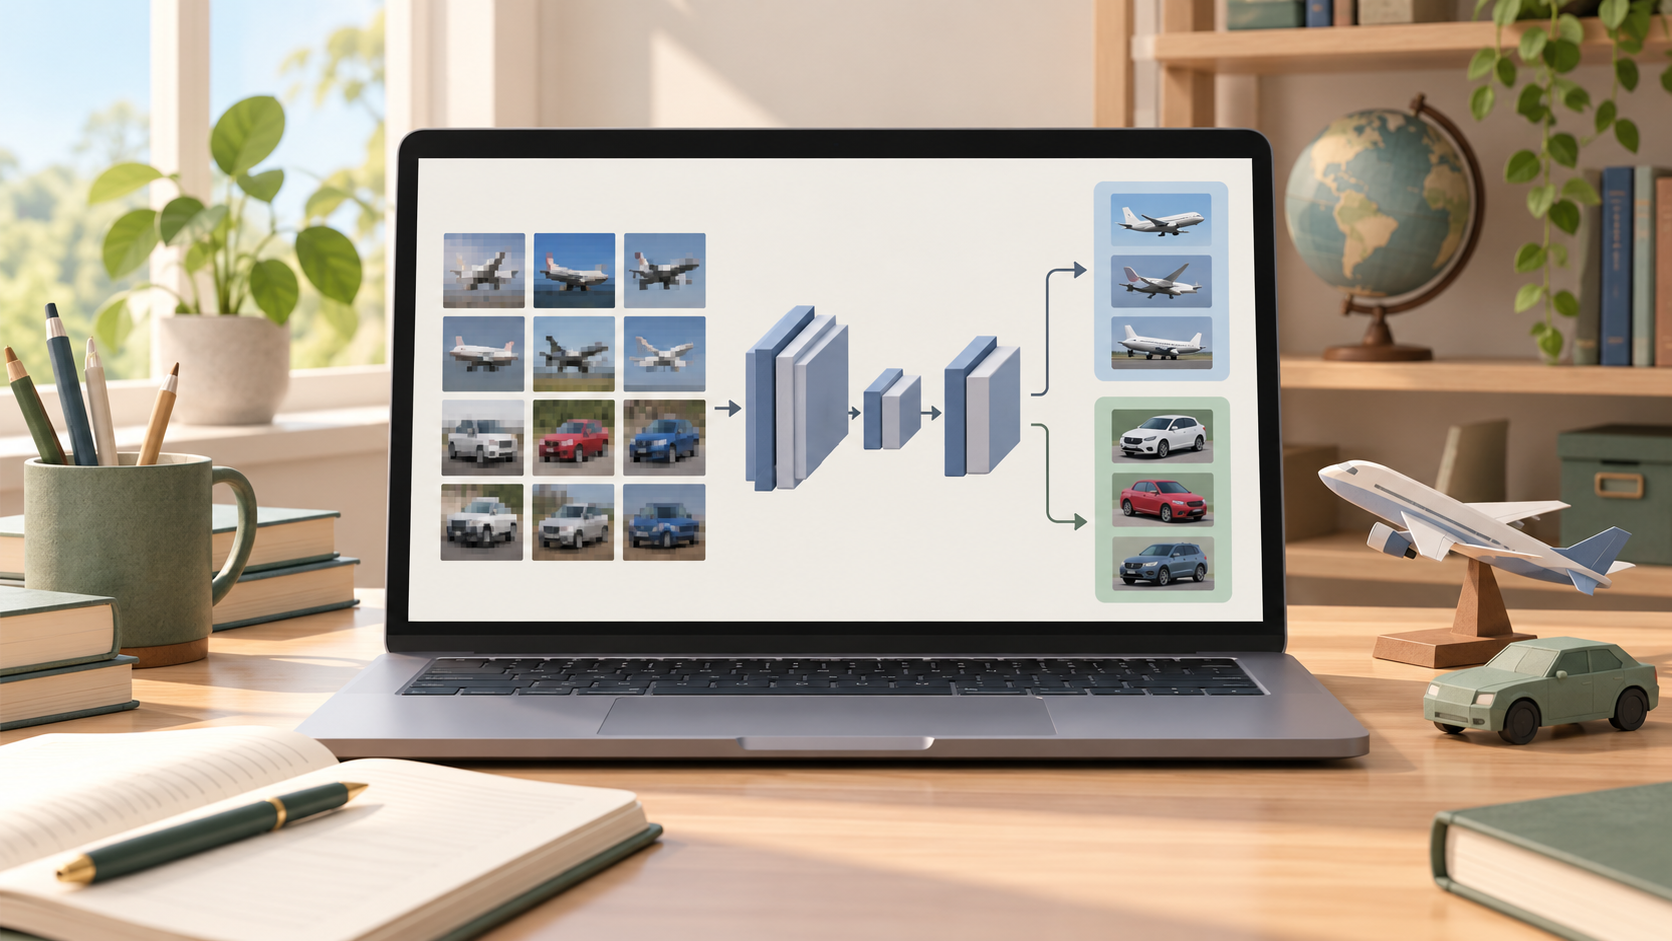
条纹任务帮助我们理解训练循环,但它的规则太整齐。真实图片包含背景、姿态、光照和遮挡,本课用 CIFAR-10 的飞机与汽车子集建立一个可重复的二分类基线。我们仍然只判断整图类别,不输出目标框。
CIFAR-10 图片尺寸很小,适合教学,却不能证明模型能处理真实摄像头拍摄的图片。任务限定为两类还意味着:遇到猫、空背景或模糊帧时,模型仍可能强行给出其中一类。后续产品必须重新设计数据与拒绝机制。
数据约定先固定
原数据的飞机和汽车编号分别为 0、1,本课显式筛选并保留这一顺序。只从官方训练部分划出验证集,官方测试部分暂不读取。每类先取固定随机排序后的 1000 张训练、200 张验证,缩短第一轮实验时间。
这是教学子集规模,不是正式性能评测协议。不同划分、更多数据或不同随机种子可能改变结果。数据接口与下载行为以 Torchvision CIFAR10 文档为准;实际使用还需阅读数据集来源的使用说明。
本课采用 RGB、32×32、ToTensor() 转换到浮点 0~1,不再额外标准化。训练和验证都使用同一确定性输入处理,先建立基线。后面添加随机增强时才改变训练处理。
一个可以读完的完整训练入口
下面脚本依赖匹配版本的 PyTorch 与 Torchvision。配套 code/train.py 已将此流程整理为带参数的入口,可直接执行;运行目录的 data/ 保存数据,runs/ 保存产物,它们都不应自动发布。
默认 download=False,要求本地已有 CIFAR-10。配套脚本首次准备数据时显式传入 --download,这会访问数据源并下载。这里没有把下载或真实训练写成已经完成的事实。
|
逐段理解这份脚本
前两个卷积层处理局部空间信息,池化减少尺寸;自适应平均池化将每个通道归约为一个值,输出 16 个特征;线性层产生两个类别的 logits。这里沿用 CNN 概念,但不依赖其他文章的辅助模块。
evaluate() 用固定参数统计验证结果,既调用 eval() 又关闭梯度。每轮训练开始重新 train()。如果以后加入 Dropout 或 BatchNorm,这些模式切换就会影响计算行为。
保存最佳参数时用了深复制。若只是把 state_dict() 赋给变量后继续训练,其中张量可能仍指向更新中的状态,最终保存的就不一定是当时最佳模型。
第一次运行该观察什么
先确认批次形状是 [N,3,32,32]、标签只有 0 和 1、输出是 [N,2]。然后观察训练损失是否有下降趋势,验证集是否明显优于简单基线。二分类均衡子集的固定单类预测准确率为 50%,但随机初始化某一次的结果不必恰好 50%。
如果训练损失完全不动,先缩小到少量样本排查训练链路;如果训练很好、验证很差,检查划分、样本分布与过拟合。不要靠增加网络复杂度掩盖基础错误。
本草稿没有给出虚构的“五轮达到多少准确率”。后续实测应记录依赖版本、划分、实际耗时、训练曲线和失败样本,并在方案确定后才使用官方测试部分。
练习
- 将每类训练样本减到 100,其他设置不变,应该比较哪些数据?
- 为什么不能用测试集挑选最佳 epoch?
- 为什么最佳模型以验证损失选择,却仍打印验证准确率?
参考答案
比较训练和验证曲线、错误类别与运行成本,不能只看最后一轮训练准确率。测试集参与选 epoch 会变成调参依据,使最终报告偏乐观。损失体现分布与置信程度,准确率体现离散分类结果,两者可能变化不同;选择准则应提前固定。
下一课只改变数据增强与正则化,保留这份基线的划分和评价方式,才能判断变化是否有帮助。
配套代码练习
实验 01:离线检查训练与保存流程
查看完整代码:train.py
from pathlib import Path
import argparse
import copy
import random
import torch
from torch import nn
from torch.utils.data import DataLoader, Subset
from torchvision import datasets, transforms
parser = argparse.ArgumentParser(description='CIFAR-10 飞机/汽车分类基线')
parser.add_argument('--smoke', action='store_true', help='使用构造图片检查流程,不代表真实精度')
parser.add_argument('--download', action='store_true', help='显式允许下载 CIFAR-10')
parser.add_argument('--data', default='data')
parser.add_argument('--output', default='runs')
parser.add_argument('--epochs', type=int, default=5)
args = parser.parse_args()
if args.epochs < 1:
parser.error('--epochs 必须大于 0')
torch.manual_seed(7)
torch.set_num_threads(2)
class TinyCNN(nn.Module):
def __init__(self):
super().__init__()
self.features = nn.Sequential(
nn.Conv2d(3, 8, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
nn.Conv2d(8, 16, 3, padding=1), nn.ReLU(),
nn.AdaptiveAvgPool2d(1),
)
self.head = nn.Linear(16, 2)
def forward(self, x):
return self.head(self.features(x).flatten(1))
if args.smoke:
from torch.utils.data import TensorDataset
raw = TensorDataset(torch.rand(80,3,32,32), torch.arange(80)%2)
train_ids, val_ids = list(range(64)),list(range(64,80))
print('SMOKE: 随机图片,仅检查训练、验证和保存流程')
else:
raw = datasets.CIFAR10(args.data, train=True, download=args.download,
transform=transforms.ToTensor())
train_ids, val_ids = [], []
for label in (0, 1):
ids = [i for i, y in enumerate(raw.targets) if y == label]
random.Random(7 + label).shuffle(ids)
train_ids.extend(ids[:1000])
val_ids.extend(ids[1000:1200])
assert not (set(train_ids) & set(val_ids))
train_loader = DataLoader(Subset(raw, train_ids), batch_size=32,
shuffle=True, num_workers=0)
val_loader = DataLoader(Subset(raw, val_ids), batch_size=64,
shuffle=False, num_workers=0)
model = TinyCNN()
loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
def evaluate():
model.eval()
total_loss = correct = count = 0
for images, labels in val_loader:
logits = model(images)
total_loss += loss_fn(logits, labels).item() * len(labels)
correct += (logits.argmax(1) == labels).sum().item()
count += len(labels)
return total_loss / count, correct / count
best_loss, best_state, best_epoch = float('inf'), None, 0
for epoch in range(1, args.epochs + 1):
model.train()
total_loss = count = 0
for images, labels in train_loader:
optimizer.zero_grad()
logits = model(images)
loss = loss_fn(logits, labels)
loss.backward()
optimizer.step()
total_loss += loss.item() * len(labels)
count += len(labels)
val_loss, val_acc = evaluate()
print(epoch, total_loss / count, val_loss, val_acc)
if val_loss < best_loss:
best_loss = val_loss
best_state = copy.deepcopy(model.state_dict())
best_epoch = epoch
Path(args.output).mkdir(parents=True, exist_ok=True)
torch.save({
'smoke': args.smoke, 'model': best_state, 'epoch': best_epoch,
'classes': ['airplane', 'automobile'],
'input': {'size': [32, 32], 'color': 'RGB', 'scale': '0..1'},
'train_ids': train_ids, 'val_ids': val_ids,
}, Path(args.output) / 'best.pt')
loaded = torch.load(Path(args.output)/'best.pt', weights_only=True)
model.load_state_dict(loaded['model'])
model.eval()
with torch.no_grad():
probe = torch.zeros(1,3,32,32)
assert model(probe).shape == (1,2)
print('保存并重新加载:',Path(args.output)/'best.pt','best_epoch:',best_epoch)
在项目根目录执行;下载包解压后,在解压目录执行 python3 train.py --smoke --epochs 1。
cd 'content/posts/AI-深度学习/从零搭建视觉模型/12-第一个真实图片分类器/code' && python3 train.py --smoke --epochs 1实验 02:本地 CIFAR-10 真实图片训练
查看完整代码:train.py
from pathlib import Path
import argparse
import copy
import random
import torch
from torch import nn
from torch.utils.data import DataLoader, Subset
from torchvision import datasets, transforms
parser = argparse.ArgumentParser(description='CIFAR-10 飞机/汽车分类基线')
parser.add_argument('--smoke', action='store_true', help='使用构造图片检查流程,不代表真实精度')
parser.add_argument('--download', action='store_true', help='显式允许下载 CIFAR-10')
parser.add_argument('--data', default='data')
parser.add_argument('--output', default='runs')
parser.add_argument('--epochs', type=int, default=5)
args = parser.parse_args()
if args.epochs < 1:
parser.error('--epochs 必须大于 0')
torch.manual_seed(7)
torch.set_num_threads(2)
class TinyCNN(nn.Module):
def __init__(self):
super().__init__()
self.features = nn.Sequential(
nn.Conv2d(3, 8, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
nn.Conv2d(8, 16, 3, padding=1), nn.ReLU(),
nn.AdaptiveAvgPool2d(1),
)
self.head = nn.Linear(16, 2)
def forward(self, x):
return self.head(self.features(x).flatten(1))
if args.smoke:
from torch.utils.data import TensorDataset
raw = TensorDataset(torch.rand(80,3,32,32), torch.arange(80)%2)
train_ids, val_ids = list(range(64)),list(range(64,80))
print('SMOKE: 随机图片,仅检查训练、验证和保存流程')
else:
raw = datasets.CIFAR10(args.data, train=True, download=args.download,
transform=transforms.ToTensor())
train_ids, val_ids = [], []
for label in (0, 1):
ids = [i for i, y in enumerate(raw.targets) if y == label]
random.Random(7 + label).shuffle(ids)
train_ids.extend(ids[:1000])
val_ids.extend(ids[1000:1200])
assert not (set(train_ids) & set(val_ids))
train_loader = DataLoader(Subset(raw, train_ids), batch_size=32,
shuffle=True, num_workers=0)
val_loader = DataLoader(Subset(raw, val_ids), batch_size=64,
shuffle=False, num_workers=0)
model = TinyCNN()
loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
def evaluate():
model.eval()
total_loss = correct = count = 0
for images, labels in val_loader:
logits = model(images)
total_loss += loss_fn(logits, labels).item() * len(labels)
correct += (logits.argmax(1) == labels).sum().item()
count += len(labels)
return total_loss / count, correct / count
best_loss, best_state, best_epoch = float('inf'), None, 0
for epoch in range(1, args.epochs + 1):
model.train()
total_loss = count = 0
for images, labels in train_loader:
optimizer.zero_grad()
logits = model(images)
loss = loss_fn(logits, labels)
loss.backward()
optimizer.step()
total_loss += loss.item() * len(labels)
count += len(labels)
val_loss, val_acc = evaluate()
print(epoch, total_loss / count, val_loss, val_acc)
if val_loss < best_loss:
best_loss = val_loss
best_state = copy.deepcopy(model.state_dict())
best_epoch = epoch
Path(args.output).mkdir(parents=True, exist_ok=True)
torch.save({
'smoke': args.smoke, 'model': best_state, 'epoch': best_epoch,
'classes': ['airplane', 'automobile'],
'input': {'size': [32, 32], 'color': 'RGB', 'scale': '0..1'},
'train_ids': train_ids, 'val_ids': val_ids,
}, Path(args.output) / 'best.pt')
loaded = torch.load(Path(args.output)/'best.pt', weights_only=True)
model.load_state_dict(loaded['model'])
model.eval()
with torch.no_grad():
probe = torch.zeros(1,3,32,32)
assert model(probe).shape == (1,2)
print('保存并重新加载:',Path(args.output)/'best.pt','best_epoch:',best_epoch)
在项目根目录执行;下载包解压后,在解压目录执行 python3 train.py --epochs 5。
cd 'content/posts/AI-深度学习/从零搭建视觉模型/12-第一个真实图片分类器/code' && python3 train.py --epochs 5先在包内运行 python3 train.py --smoke --epochs 1,检查训练、验证、保存与重新加载。它使用随机构造图片,不是 CIFAR-10 实测成绩。准备好本地数据后运行 python3 train.py --epochs 5;首次下载使用 --download。依赖、目录参数与修改任务见包内 README.md,实际验证范围见 verification.md。