学习初稿 · 第 7 课。 本篇已开放网页阅读,用于先建立完整认识。本篇已附三个可运行实验,仅依赖 Python 标准库。手算值与实验输入均为构造,不代表真实训练成绩;本章不训练模型、不下载数据。
已经有两个数,为什么还不能直接说识别完成
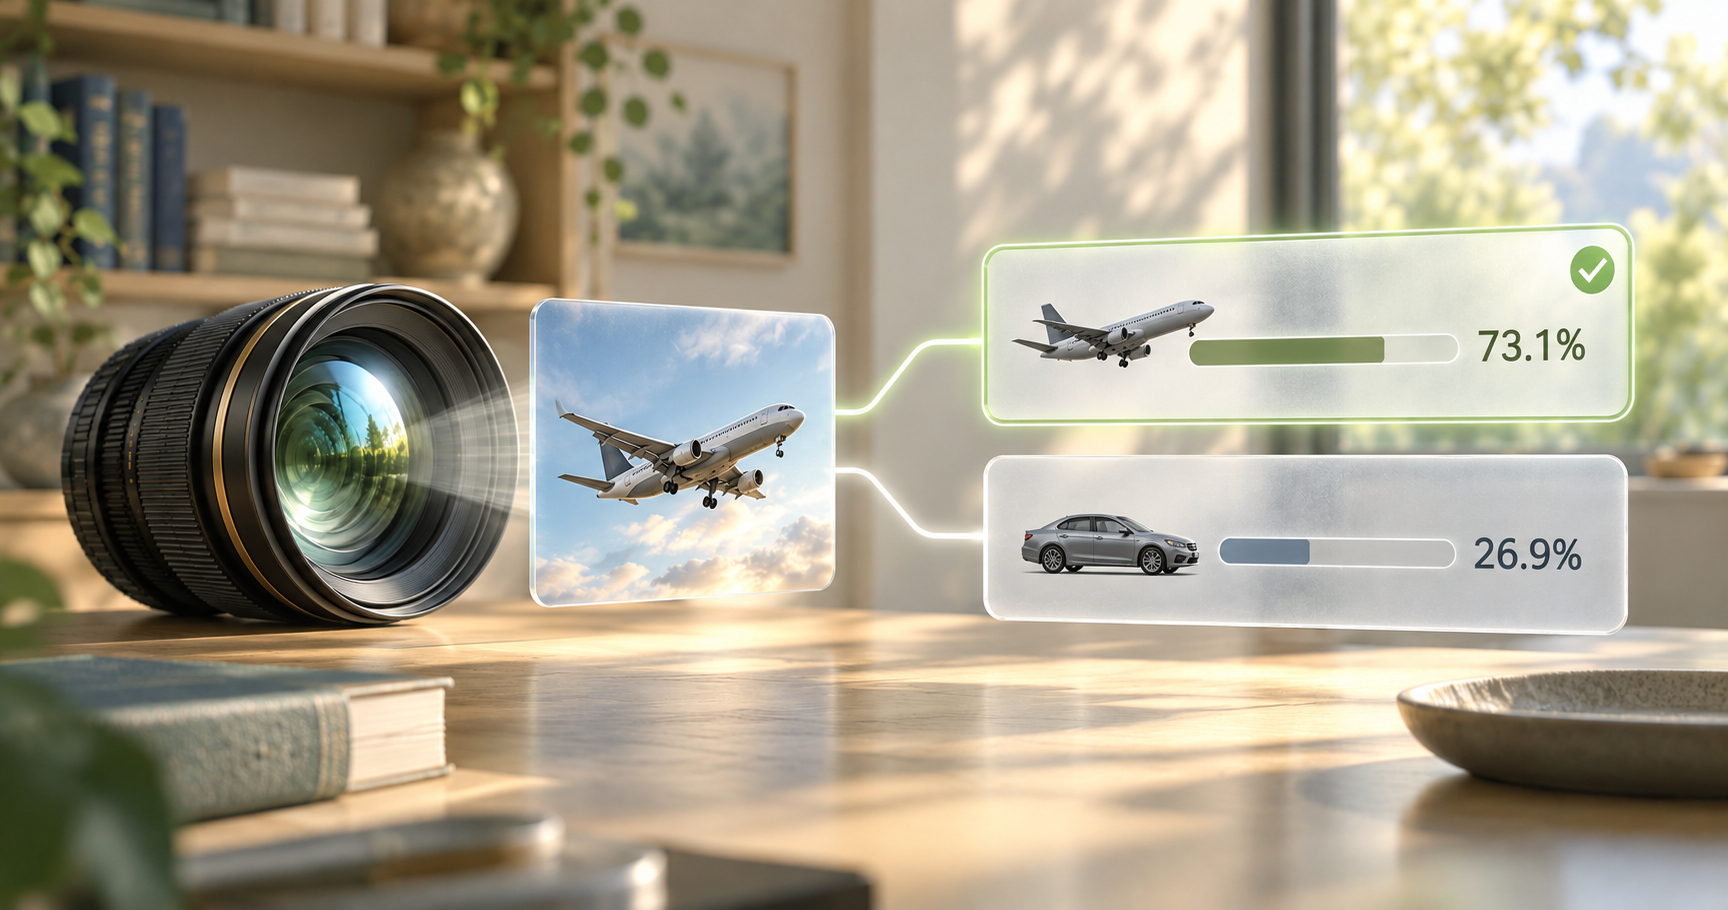
前面的 CNN 把一张图片变成两个分数。我们现在约定第 0 类是飞机,第 1 类是汽车。问题是:这些分数是什么,怎样选类别,低把握的样本如何处理?
以下数值都为手算构造,不表示已训练网络的精度。重点是把网络输出与业务决策分开,避免后面把一个阈值当成通用答案。
logits 是尚未归一化的分数
分类网络最后的线性层可以输出任意实数,例如 [2, 1]、[-4, -5]。把这类未经 Softmax 的类别分数称为 logits。两组数虽然绝对值不同,但类别间差都是 1。
对于互斥类别,Softmax 把各分数的指数除以指数之和。为减少溢出,计算前先减去最大值:
|
两个概率相加为 1,最大项仍在第 0 类。给所有 logits 加同一个常数不会改变 Softmax。因此不能根据“所有分数都小于 0”就判断模型失效。
下面是一段只依赖 Python 标准库的独立计算:
|
输出类别应为飞机。后面用批量张量时,对形状 [N, C] 的输出沿类别轴计算,即常见的 softmax(dim=1) 和 argmax(dim=1),不要把不同图片之间做归一化。
实验 01:亲手比较分数与概率
在配套代码目录运行 python3 01_scores_to_probabilities.py。脚本比较 [2, 1]、[-4, -5]、[102, 101] 和 [1002, 1001]:四组概率约为 [0.7311, 0.2689],类别索引都是 0。最后一组直接计算指数会溢出,先减最大值则能正常计算。
脚本同时检查概率和为 1、整体平移不改变概率,以及 logits 与概率取最大项时结果一致。对于 [0, 0],概率为 [0.5, 0.5],本实现取第一个类别;这只是明确的平分处理规则,不表示第一个类别更可信。
实验 02:一批图片怎样分别选类别
运行 python3 02_batch_predictions.py。这里用 Python 列表模拟 [N, C],输入为 [[3, 1, 0], [0, 2, 1]],形状是 [2, 3]。为了观察三个类别,本实验临时增加轮船,类别顺序为 ['飞机', '汽车', '轮船'],并未改变上一章 CNN 的输出层。
每一行代表一张图,分别做 Softmax 和取最大项,得到索引 [0, 1],对应飞机和汽车。沿图片轴取最大值则会得到三个图片索引,回答的是“每个类别在哪张图上分数最高”,不是本章要解决的问题。
脚本还故意交换飞机与汽车的名称:分数与索引没有变化,解释却反了。因此类别映射必须随模型保存,不能在推理端凭印象重新排列。
最大分数和可信程度是两件事
只需要选择类别时,直接对 logits 取最大项就够了,因为 Softmax 不改变它们的大小顺序。需要查看分布或做某些后处理时,再计算概率。
但 Softmax 最大值不是天然经过校准的现实正确率。陌生场景、错误预处理甚至无关图像,也可能得到很高的最大值。一个只学过飞机和汽车的模型,面对猫仍可能强行选择其中一个。
可以设计“待复核”决策:如果最大值低于某个阈值,就不自动给最终结论。阈值要在验证数据上选择,并统计拒绝率和被接受样本的错误率;不能只看剩余样本准确率变高,就宣称模型整体变好。
实验 03:把低把握结果交给复核
运行 python3 03_threshold_decisions.py,回到飞机、汽车两类。脚本使用四组构造的分数及标签,其中故意包含一个高分错误样本:[5, 0] 的真实标签设为汽车,模型却给飞机约 0.9933 的分数。
每条结果包含 class_id、class_name、score 和 accepted。当 score >= threshold 时接受,否则待复核。被拒绝的结果仍保留候选类别,使用方应先检查 accepted。
| 演示阈值 | 接受样本数 | 拒绝率 | 接受样本错误率 |
|---|---|---|---|
| 0.0 | 4/4 | 0% | 50% |
| 0.7 | 3/4 | 25% | 约 33.3% |
| 0.9 | 1/4 | 75% | 100% |
| 1.0 | 0/4 | 100% | 不适用 |
提高阈值减少了接受数量,却留下了那个高分错误样本。全拒绝时,接受样本错误率没有定义,不能写成 0%。这些阈值只用于观察规则,不是建议上线使用的标准,也没有证明模型具备识别未知类别的能力。
Sigmoid:把一个分数变成一个概率
Softmax 把一组分数放在一起归一化,迫使类别互相竞争。只想知道"这一个类别有多大把握"时,用另一种变换 Sigmoid:它把任意实数变到 0 到 1 之间。
|
0 恰好落在 0.5;正数超过 0.5,负数低于 0.5;离 0 越远越接近 1 或 0,但永远取不到两端。Sigmoid 逐个变换每个分数,各类结果不相加为 1,也互不影响。
它与 Softmax 同源:对两类别分数 [z0, z1] 做 Softmax,第 0 类概率恰等于 σ(z0 − z1)。前文 [2, 1] 算出的 0.7311 就是 σ(1)。所以两类单标签任务里两条路径给出的排序相同;差别要到类别多于两类、或类别不互斥时才出现。
下面这段仍只用标准库。它只在正的一边求 exp,负得再多的分数也不会让 math.exp 溢出:
|
输出约为 [('行人', 0.8808), ('汽车', 0.2689)]。两个数字互不约束:这是"行人 0.88、汽车 0.27"的逐类报告,不是"行人 88%、汽车 12%"的竞争。每一类可以单独与 0.5 比较,也可以单独设置判定阈值——这正是多标签任务的标准做法,对应的训练目标放在下一节说明。
单标签与多标签不能混用
单标签分类假设类别互斥,例如每张样本只属于飞机或汽车。多标签任务允许同一图同时包含行人、汽车和自行车,通常需要各类别独立的输出和对应训练目标。
Softmax 强制类别竞争、总和为 1,不适合直接表达多个标签同时成立。多标签沿用上一节的逐类 Sigmoid:每个类别独立给出概率、独立判定阈值,标签格式从单个整数索引变成 0/1 向量,损失也换成按类二值交叉熵。不要只改最后的阈值,却沿用错误的训练定义。
对于本系列的单标签训练,后续 CrossEntropyLoss 接收原始 logits 与整数类别索引,不能先 Softmax 再把结果当 logits 传入。PyTorch CrossEntropyLoss 文档
把输出接口写完整
至少保存:输出形状、类别顺序、分数类型、决策规则。若返回 JSON,可以分别包含 class_id、class_name、score 和 accepted。是否采用拒绝阈值由任务决定,不要在最初实验里偷偷加一层没有解释的规则。
调试时同时保留原始分数。只保存“飞机”两个字,会丢失后续比较浮点与量化输出的依据,也难以判断边界样本为何发生类别翻转。
练习与答案
[102, 101]与[2, 1]的 Softmax 是否相同?- 两张图、三个类别,输出是
[2, 3],应该沿哪个轴选择类别? - 模型说“汽车 0.99”,能否认定未知现场有 99% 正确率?
参考答案
数学上相同,因为前者只是所有分数同时加 100;稳定实现先减最大值。沿轴 1,即每张图片对应的类别轴。0.99 是模型的归一化输出,是否反映真实正确率需要代表性数据与校准评估,不能直接保证。
下一课《让模型开始学习》会解释:如果真实标签是汽车,怎样把这次预测的错误变成参数更新。
综合实践
想把这些知识接成一套可运行的代码,可以进入实现 MLP:从损失计算、训练到 ONNX 推理。实践包含自生成数据、训练与验证、模型保存、独立推理、ONNX 导出和数值对照;遇到问题可按实践中的索引返回对应理论章节。