系列编排日期为 2026 年 8 月;正文依据 2026-10-12 核对的实现整理。历史实测保留真实日期,教学数字不代表实测;本次未重新执行板端推理。
返回系列目录 · 本篇为 14 章+4 份附录中的一篇。
PIPNet 在这条链路中的职责
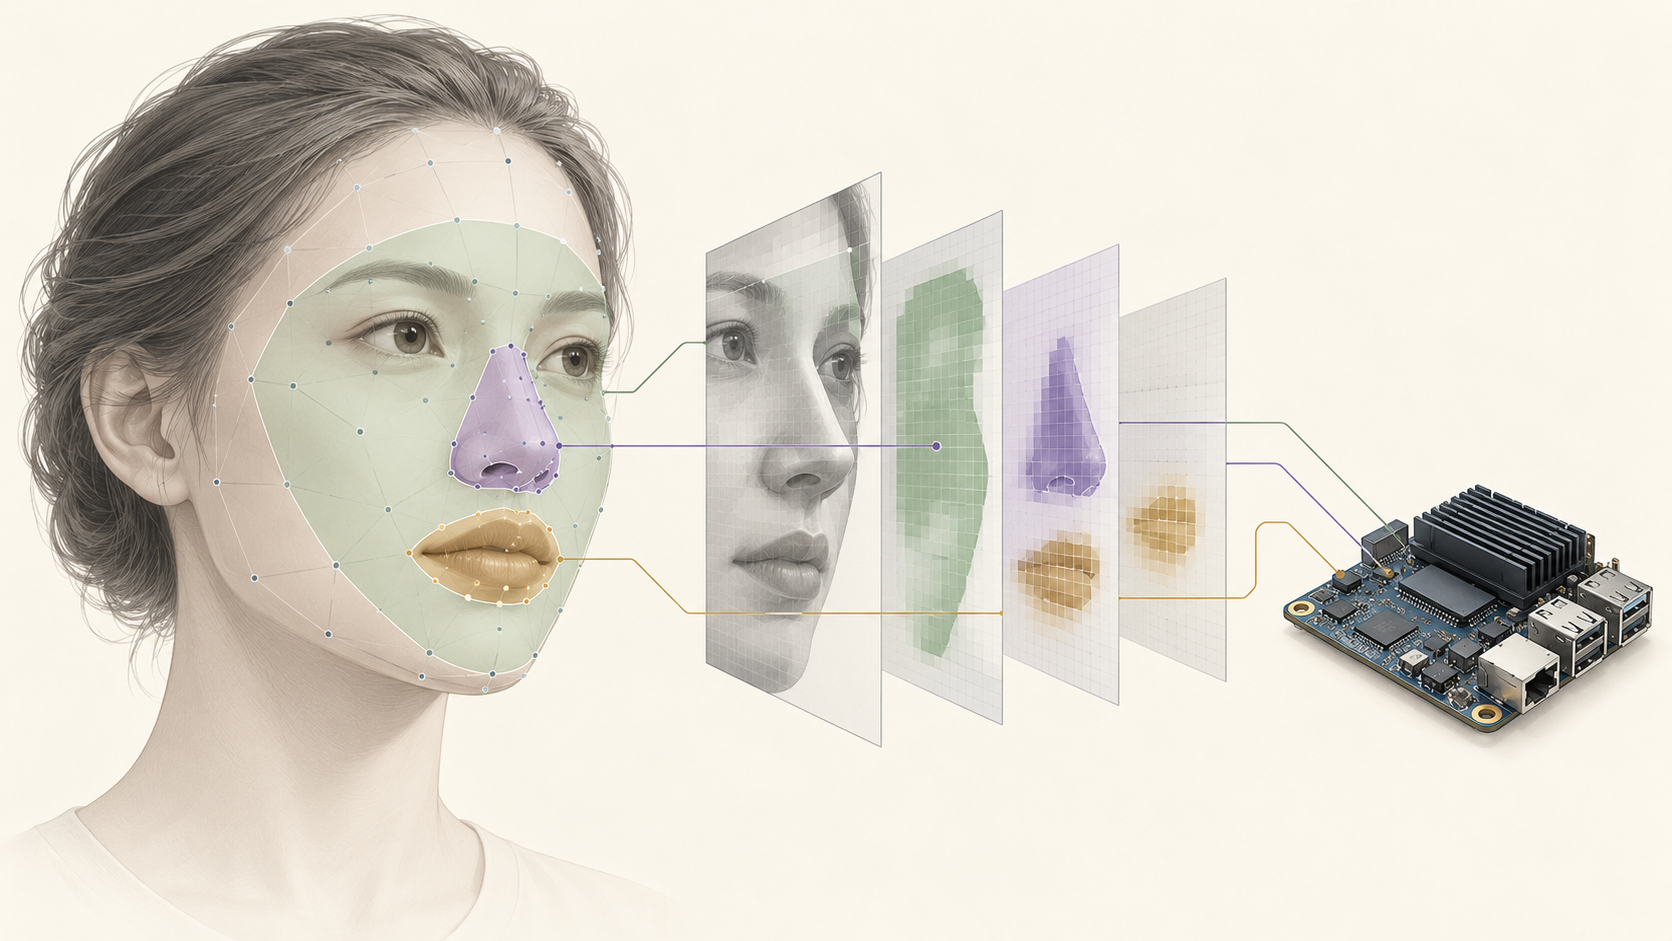
PIPNet 提供鼻嘴区域的位置,还允许观察每个点的响应强弱及不同预测之间的一致性。它本身没有给当前系统输出一个经过校准的“手遮嘴概率”。PIPNet 的原始方法称为 Pixel-in-Pixel Net,研究入口见 官方仓库;以下张量、阈值和统计均按本地部署代码说明。
五个输出张量
| 输出 | 本地形状 | 用途 |
|---|---|---|
cls_map |
[1,98,8,8] |
为每个点选择最强响应网格 |
offset_x |
[1,98,8,8] |
网格内 x 偏移 |
offset_y |
[1,98,8,8] |
网格内 y 偏移 |
nb_x |
[1,980,8,8] |
每个点对十个邻居的 x 预测 |
nb_y |
[1,980,8,8] |
每个点对十个邻居的 y 预测 |
256 输入配合 stride 32 得到 8×8 网格。输出虽然空间分辨率小,坐标仍由连续偏移精修,不能把结果精度简单理解成每点只能落在 64 个位置。
板端检查输出数、尺寸、指针和所有值是否有限。解码失败保持 numPoints=0,主流程转为错误处理;不能沿用上一帧的点位。
自身预测与邻居预测
对第 i 个点,找到 cls_map[i] 的最大位置 (col,row),在相同位置取偏移:
|
假设最大网格为 (3,4)、偏移为 (0.25,0.5),自身归一化坐标为 (0.40625,0.5625),即 256 坐标系中的 (104,144)。随后还要加入其他点对该点的邻居预测,不能在这里直接结束解码。
meanface 数据生成邻接关系;反向索引回答“哪些预测通道指向当前这个点”。本地实现按照补齐的反向索引表,将自身与邻居预测平均,以保持与参考解码一致。meanface 表不是人脸模板直接输出,也不是一张运行时待匹配的人脸照片。
peak 与 gap 的具体计算
|
原始响应不经过概率归一化,可以低于零或超过一。gap 较小意味着两个位置竞争接近;peak 较低意味着响应弱。但它们受脸尺寸、光照、姿态、图像质量及模型转换影响,不能单独对应遮挡。
如果两个位置都为 0.10,peak=0.10、gap=0;即使 peak 超过 0.08,gap 仍会触发弱点条件。仅看均值会掩盖这种局部歧义。
dispersion 为什么需要去重
坐标解码保持原补齐表的平均规则;分散度统计则去除补齐造成的重复邻居。设去重后的自身与邻居预测集合为 Q:
|
它使用裁剪归一化坐标,不是脸宽归一化坐标,也不是跨帧抖动方差。两个预测为 (0.4,0.5) 和 (0.5,0.5) 时,中心 (0.45,0.5),分散度为 0.05。它衡量同一次推理内部多个预测的一致性。
若重复索引被计数多次,某个预测会获得不应有的统计权重。当前代码用集合去重仅用于分散度,不能顺便改变原坐标解码规则,否则与参考实现产生另一种差异。
98 点索引及两种嘴部点集
| 分组 | 索引(含两端) | 点数 |
|---|---|---|
| 下颌轮廓 | 0~32 | 33 |
| 眉部 | 33~50 | 18 |
| 鼻部 | 51~59 | 9 |
| 双眼 | 60~75 | 16 |
| 外唇 | 76~87 | 12 |
| 内唇 | 88~95 | 8 |
| 最后两点 | 96~97 | 2 |
鼻尖使用 54;嘴中心使用外唇 76~87 的均值。嘴部响应统计使用 76~95,共 20 点;嘴部面积 ROI 只用外唇 76~87,共 12 点。代码的半开区间 [76,96) 和 [76,88) 正是在表达这一差别。
从逐点证据到区域证据
当前弱点规则为:peak<0.08 OR gap<0.01 OR dispersion>0.05。区域弱点比例达到 25% 即 suspect=true。鼻部九个点至少三个弱点会达到阈值;嘴部二十个点至少五个弱点会达到阈值。
区域同时记录均值与弱点索引,判定使用逐点逻辑后的比例,不是“区域平均 peak 低于 0.08”。例如五个嘴点很弱、十五个点很强,均值仍可能高,但弱点比例已经达到 25%。
roi_spread_max=0.08 是另一项参考:标记局部不稳定、参与旧规则和物体证据可靠性判断。当前可见优先策略不会仅因此把区域覆盖率改成无效。
应如何验证
比较同一张裁剪的五个原始输出、argmax、邻居索引、最终点坐标、peak、gap 和 dispersion。不要只比较画出来的点是否“看着差不多”。板端卸载后输出必须仍有效;非有限值、错误输出顺序和布局错误应作为错误处理,而不是降低阈值放行。
代码入口:PipNet.cpp::decodePipNet()、PipNetMeanfaceData.h、FaceOcclusionPolicy.cpp::response()。本章教学数字可在附录 D 手工复算。