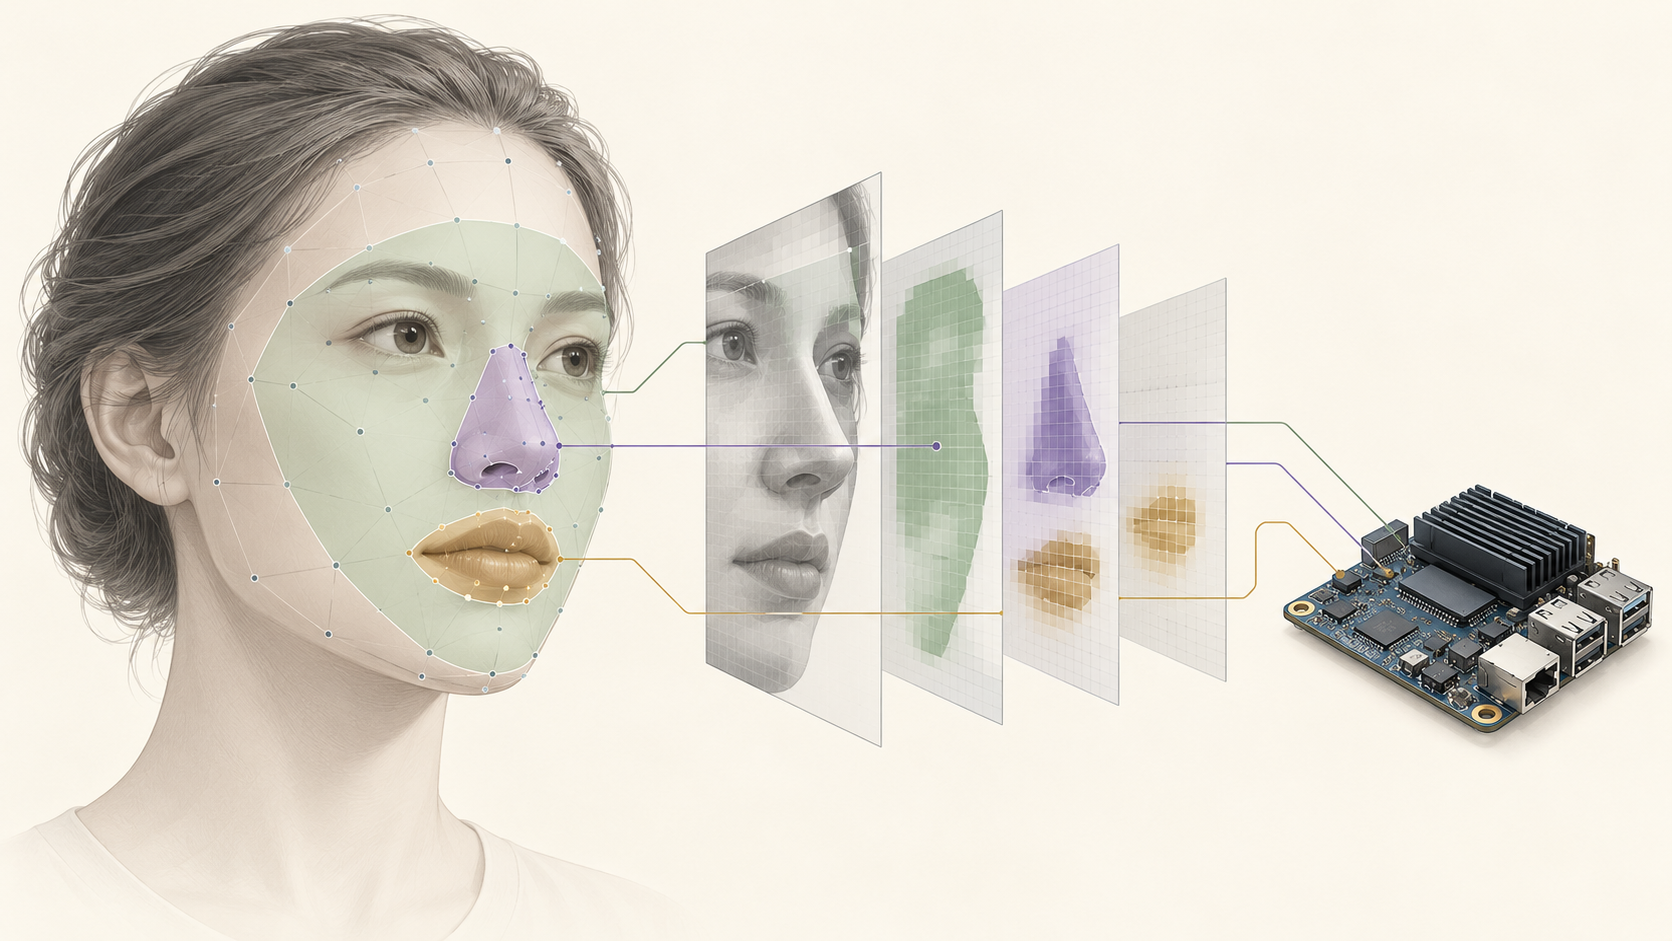
系列编排日期为 2026 年 8 月;正文依据 2026-10-12 核对的实现整理。历史实测保留真实日期,教学数字不代表实测;本次未重新执行板端推理。
返回系列目录 · 本篇为 14 章+4 份附录中的一篇。
预处理就是模型接口的一部分
模型文件相同,输入颜色、数值范围或裁剪几何不同,输出仍可能完全不同。调试时首先固定输入像素,再比较网络输出;不能直接通过调整阈值补偿预处理错误。
本地 OpenCV 图像是 BGR 交错布局:一个像素的 B、G、R 连续存放。板端 OM 接收 BGR planar UINT8:先放整幅 B 平面,再放 G、R 平面。planar() 的位置公式为:
|
NCHW 的概念不能与 BGR/RGB 混为一谈:前者描述维度排列,后者描述通道含义。传入 HWC 字节却声明成 planar,网络会看到错误图像。
五个模型的输入不能共用一套归一化
| 模型 | 几何输入 | 训练侧输入语义 |
|---|---|---|
| YOLOv5s-P34 | 640×640,等比例补边 | RGB,除以 255 |
| YuNet 320 | 320×320,头部 ROI 等比例缩放,右下补黑 | BGR;原网络为 0~255,本地 input255 图配合 AIPP 除以 255,详见第十二章 |
| PIPNet98 | 256×256,直接缩放脸部裁剪 | RGB,ImageNet 均值和标准差 |
| FaceOcc | 与 PIPNet 相同裁剪及尺寸 | 原始 FaceExtraction 权重对应 RGB/255 |
| World64 | 640×640,等比例补边 | RGB/255 |
PIPNet 的归一化为 z=(pixel/255−mean)/std,三个通道的 mean 为 [0.485,0.456,0.406],std 为 [0.229,0.224,0.225]。例如 R=128 时,标准化值约为 0.074,而 RGB/255 的值约为 0.502,两者不能互换。
在板端,AIPP 已经嵌入各自 OM,调用者提供 UINT8 原始值。若先在 CPU 上标准化一次,AIPP 再执行一次,就是重复预处理。FaceOcc 的同名衍生版本可能使用不同配置,本系列只针对本项目原始权重与已转换 OM,不把其他版本的预处理移植过来。
第一层:头部检测的 letterbox
给定原图 W×H 和目标 Tw×Th:
|
例如 960×540 输入到 640×640,缩放后为 640×360,上下各补约 140 像素。模型点 (320,320) 对应原图 (480,270)。本地头模型代码用接近 YOLO 的 nearbyint(half_padding−0.1) 处理整数边界;应保存实际 padding,不要在后处理重新凭理论值猜测。
旧 YOLOv5m 输入是 640×384,不能只换 OM 而保留 640×640 解码。
第二层:扩大头框后找脸
head_padding=0.15 表示左右各扩头宽的 15%,上下各扩头高的 15%,未裁切时整体宽高约为原来的 1.3 倍。它与 World 的 review_expansion=1.6 不是同一种参数。
YuNet 对头部 ROI 缩放到最长边 320,图像放在输入左上角,剩余右边或下边补零。这里没有居中 padding。
|
宽高按各自实际整数缩放尺寸还原,避免取整造成一两个像素的累计偏差。
第三层:脸部裁剪并非四边对称扩展
当前 OcclusionCore.h::faceCrop() 使用带 +1 的框宽高。左右扩展约 10%;上边缘向下移动约脸高的 10%,下边缘也向下移动同量,然后裁到图像边界。它更接近水平扩展并下移裁剪,不能简写为“四周统一扩 10%”。
PIPNet 与 FaceOcc 都对这个裁剪直接 resize 到 256×256。原裁剪可以是矩形,所以几何计算必须恢复长宽比;分割与点位在共同的 256 坐标系内则能够直接对应。
|
原图绘制与采样边界不是同一个判断。u=1 会映射到 256,已超出采样索引 0~255,因此局部 ROI 必须明确拒绝越界,不能简单裁到边缘伪造有效覆盖。
插值、取整与掩膜的区别
当前统计先在 256×256 概率图中阈值化,再对同坐标系的口鼻 mask 计数。显示则把概率图 resize 回原裁剪,再阈值叠绿。插值和阈值运算不交换,因此屏幕上看到的绿色边缘与统计 mask 可能略有不同。
复现覆盖率应复用统计过程,不能对标注截图的绿色像素重新计数。截图还可能经过颜色混合、JPEG 压缩和显示缩放。
定位问题的检查顺序
先比较原图 SHA-256,再比较裁剪四元组和裁剪像素;然后检查通道排列、输入字节数、AIPP、输出布局,最后比较点位和分割。如果第一处偏差已经发生在 crop,后面的网络误差统计就混入了输入差异。
本章依据:StreamNpuOcclusionProcessor.cpp、OcclusionCore.h、yunet_occlusion/model/pipnet_onnx.py、unet_occlusion/README.md、各模型转换脚本。