数据的物理结构
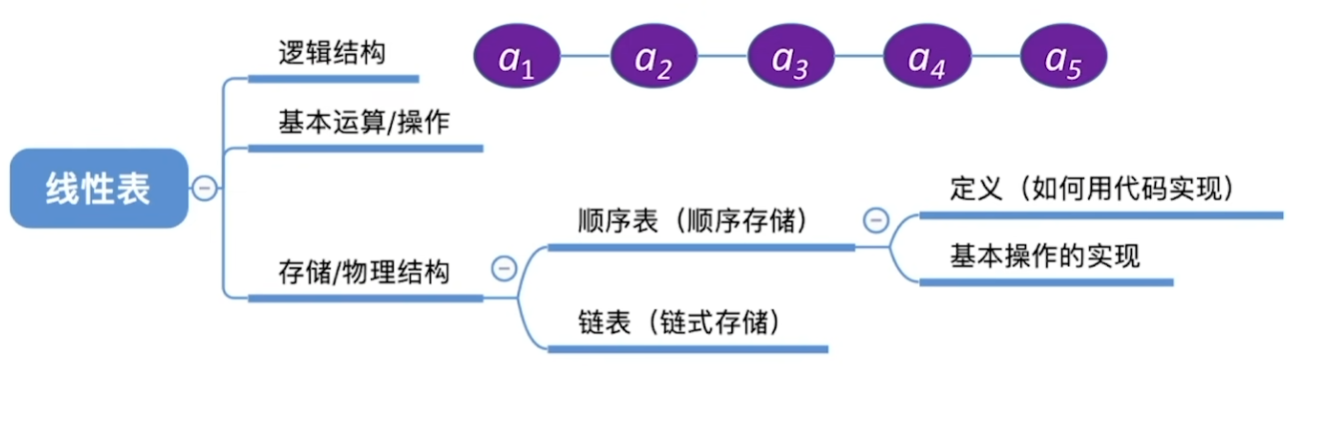
数据存储的形式有两种:顺序式和链式。、
算法的五个特征:输入,输出,有穷性,确定性和可行性。
特征
解释
输入
0个或者多个
输出
一个或者多个输出
有穷性
不会无限循环
确定性
确定性不会有其他含义
可行性
每一步都是可行的
算法的设计要求
可读性
健壮性
1、时间复杂度
关键在于认识: 时间=执行次数
T(n)=O(f(n));
这样就可以用O来记时间复杂度
一般情况下,随着输入规模n的增大,T(n)增长最慢的算法为最优算法。
常见的时间复杂度O(1),O(n),O(n^2),O(log(n)),O(nlog(n)),O(n^3),O(2^n),O(n!),O(n^n)
2、空间复杂度
关键在于认识: 空间=占用内存
一般不关注。
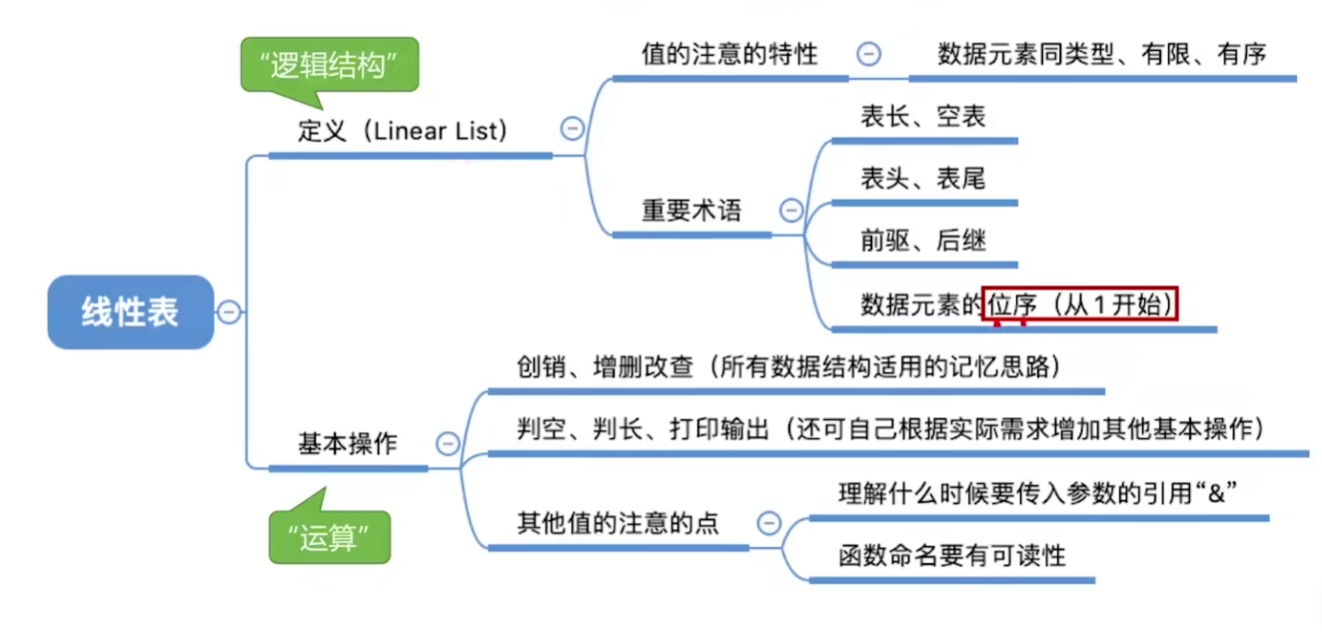
3、线性表
判断方法:如果存在多个元素,且每个元素都有唯一的一个前驱和后继,则该数据结构为线性表。头无前驱,尾无后继。
对数据的操作:增删改查。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15 #include <iostream>
using namespace std;
void test (int value)
2 ;
cout << value << endl;
}
int main ( )
int x = 1 ;
cout << x << endl;
test ( x );
cout << x << endl;
}
这里函数修改了元素值,却没有带回来原因是:传递时,test函数里的x是从main中的x复制过来的,所以修改了x的值,但test函数里的x并没有改变。
如果想将参数的结果带回来,需要传入参数的应用“&”。
团队中,自己定义的数据结构如果要让人很方便的使用,自己就必须进行函数封装,方便调用。避免出错。
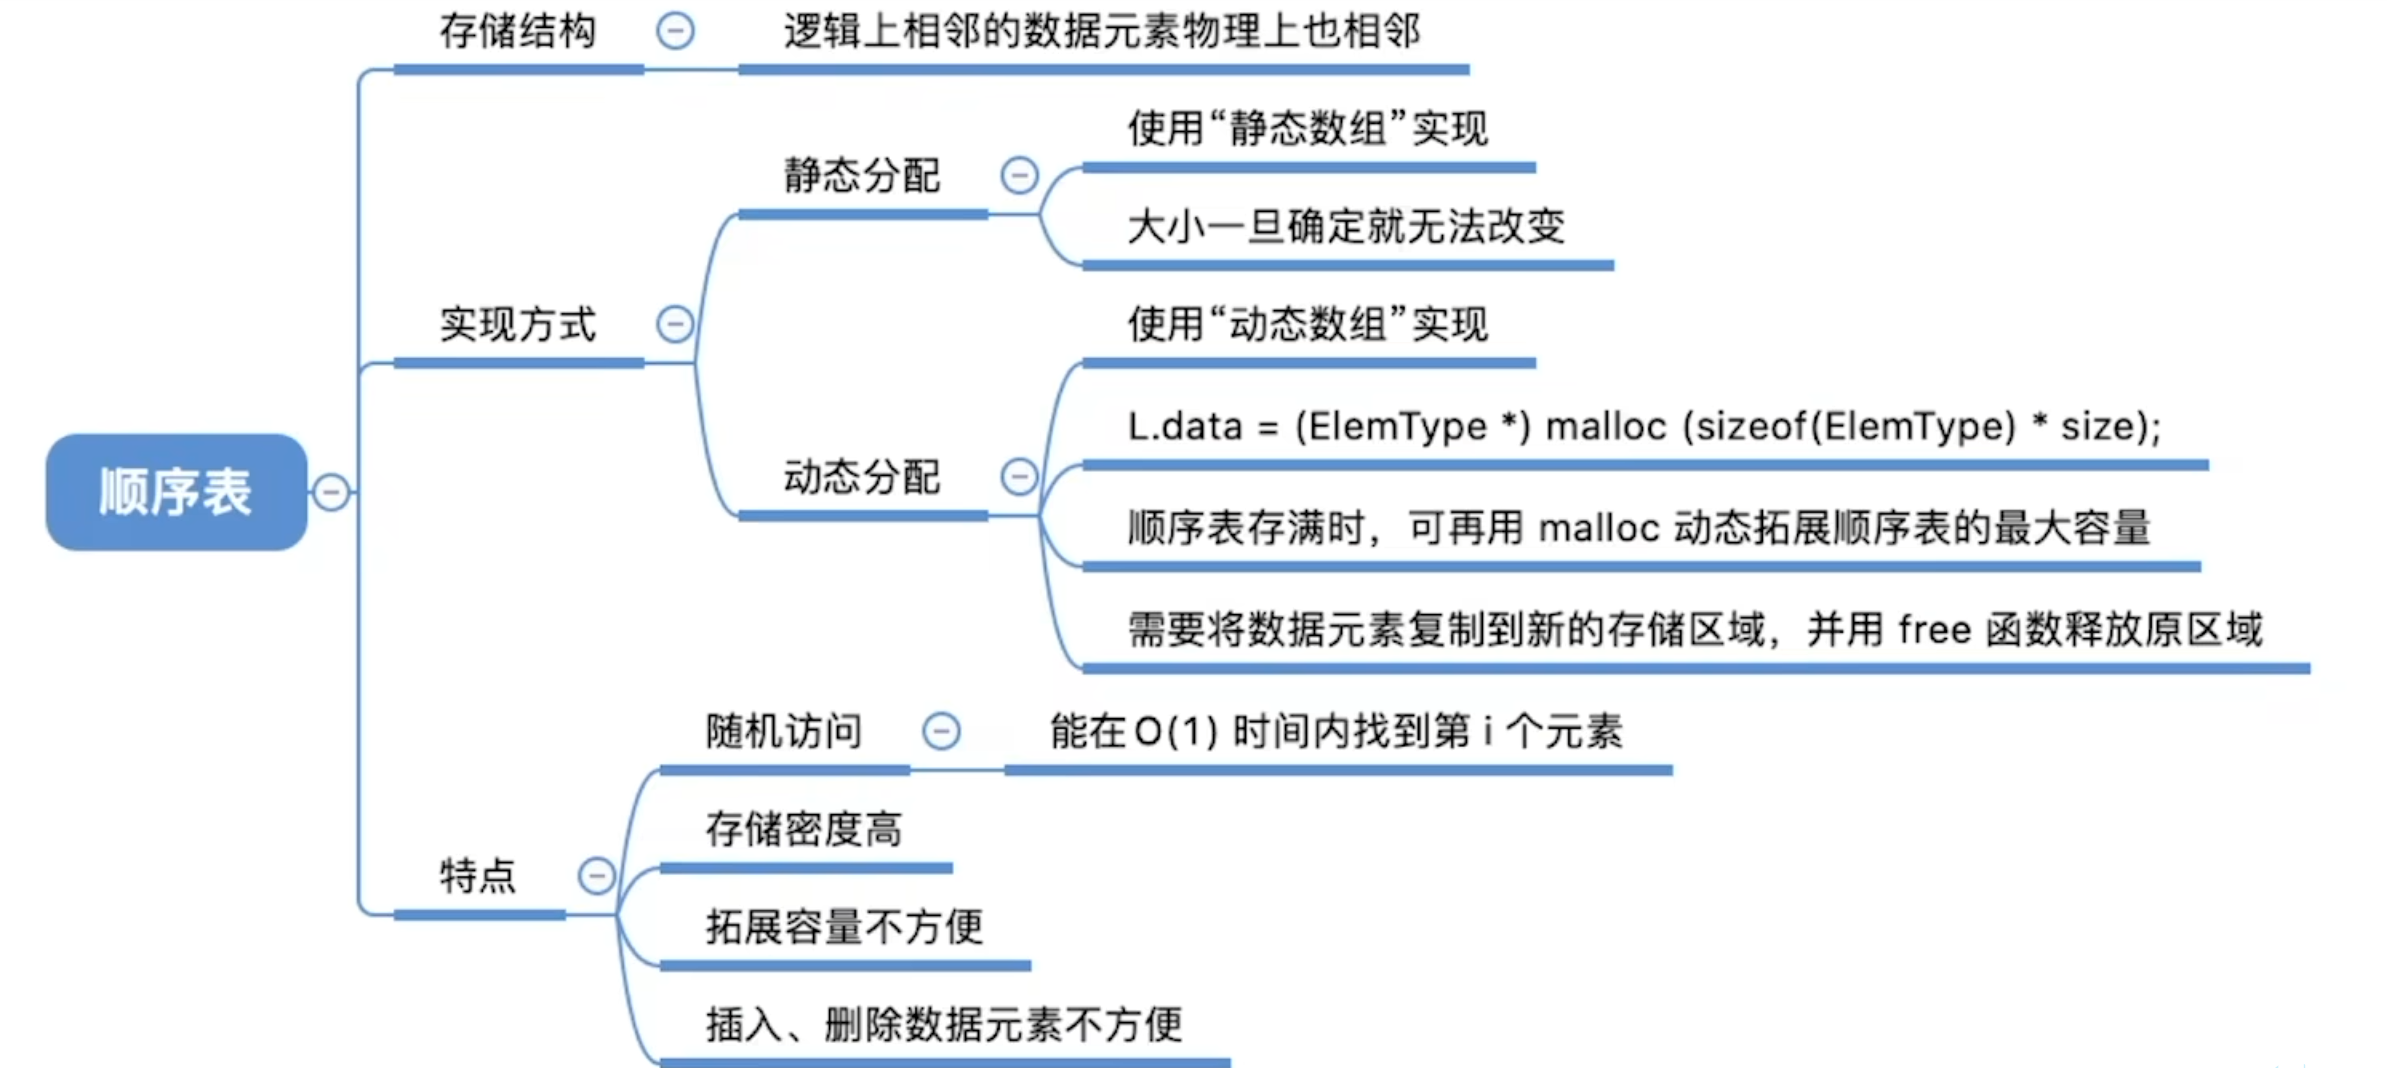
3.1、顺序表
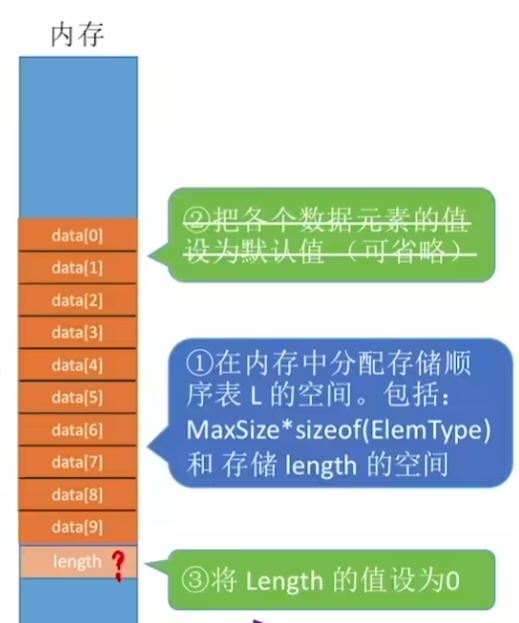
顺序表的实现 -- 静态分配
1
2
3
4
5
6 #define maxsize 10
typedef struct
{
elemtype data[maxsize];
int length;
}SqList;
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
#include <stdio.h>
#define maxsize 10
typedef struct
{int data[maxsize];
int length;
}sqlist;
void Initlist (sqlist &L)
{
L.length = 0 ;
}
int getelem (sqlist &L, int i)
{
if (i < 1 > || i>L.length)
return -1 ;
return L.data[i - 1 ];
}
int main ()
{
sqlist L;
Initlist(L);
for (int i = 0 ; i < maxsize; i++)
{
int b = getelem(L,i);
printf ("%d\n" ,b);
}
return 0 ;
}
这种分配方式的缺点是:大小无法更改。
就只能采用动态分配的方式。
1
2
3
4
5
6
7
8 #define InitSize 5
typedef struct
{
elemtype *data;
int MaxSize;
int length;
}SqList;
用c实现
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39 #include <stdio.h>
#include <malloc.h>
#define Initsize 100
typedef struct
{int *data;
int maxsize;
int length;
}sqlist;
void Initlist (sqlist &L)
{
L.data = (int *)malloc (Initsize * sizeof (int ));
L.maxsize = Initsize;
L.length = 0 ;
}
void Increasize (sqlist &L, int inc)
{
int *newdata;
if (inc <= 0 ) return ;
newdata = (int *)malloc ((L.maxsize + inc) * sizeof (int ));
for (int i = 0 ; i < L.length; ++i)
{
newdata[ i ] = L.data[ i ];
}
L.data+=inc;
free (L.data);
}
int main ()
{
sqlist L;
Initlist (L)
Increasize (L,5 );
return 0 ;
}
用c++实现
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
#include <iostream>
using namespace std;
#define InitSize 10
typedef struct {
int *data;
int maxsize;
int length;
}sqlist ;
int initlist (sqlist &L)
new int [InitSize];
if (L.data == NULL )
{
return -1 ;
}
L.maxsize = InitSize;
L.length = 0 ;
return 0 ;
}
int addlist ( sqlist &L , int x )
if ( L.length >= L.maxsize )
{
int * newdata = new int [ L.maxsize + x ];
for ( int i = 0 ; i < L.length ; i++ )
{
newdata[ i ] = L.data[ i ];
}
delete [] L.data;
L.data = newdata;
L.maxsize += x;
}
return 0 ;
}
void adddate ( sqlist& L , int i )
if (L.length >= L.maxsize)
{
return ;
}
L.data[L.length] = i;
L.length++;
}
int getelement ( sqlist& L , int i )
if ( i < 1 || i > L.length )
{
return -1 ;
}
return L.data[i - 1 ];
}
int main ()
initlist ( L );
for (int i = 0 ; i < 10 ; i++)
{
adddate ( L , i);
}
addlist ( L , 1 );
adddate ( L , 10 );
int k = -1 ;
for (int i = 0 ; i < L.length ; i++)
{
k = getelement ( L , i + 1 );
cout << k << endl;
}
while (1 );
}
顺序表的特点
1、随机访问,时间复杂度为O(1),即通过下标直接访问,效率高。
2、存储密度高,每个节点只存储数据元素。
3、扩展容量不方便(采用动态分配方式实现,时间复杂度较高)。
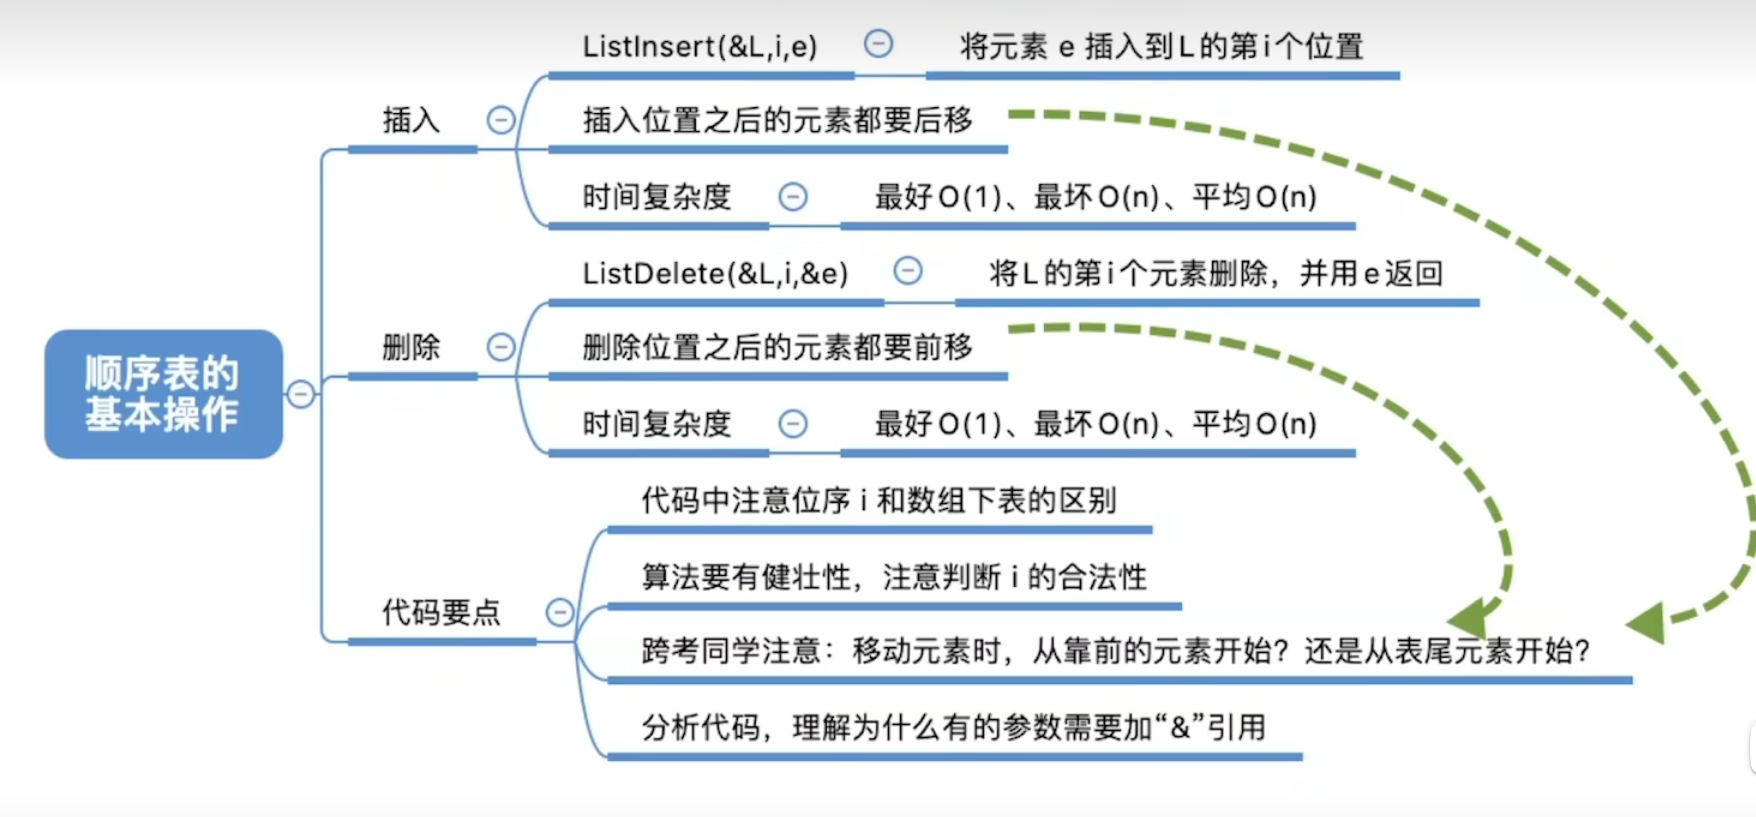
4、插入、删除操作不方便,需要移动大量的元素。
3-1-2、顺序表的插入
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35 #define Maxsize 10
typedef struct {int length;
}SqList;
void Initlist (SqList &L)
{
sql.length = 0 ;
}
bool ListInsert (SqList &L, int i, int e)
{
if (L.length == Maxsize) return false ;
if (i < 1 || i > L.length + 1 ) return false ;
for (int j = L.length; j >= i; --j)
L.data[j] = L.data[j - 1 ];
L.data[i - 1 ] = e;
L.length++;
return true ;
}
int main ()
{
SqList L;
Initlist(L);
bool ret = ListInsert(L, 1 , 10 );
if (ret == true )
return 0 ;
else
return -1 ;
}
顺序表要求插入的时候不能跳跃。
时间复杂度情况
最好情况: 插入位置在表尾,时间复杂度为O(1)
最坏情况: 插入位置在表头,时间复杂度为O(n)
平均情况: 插入位置在表中间,时间复杂度为O(n)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
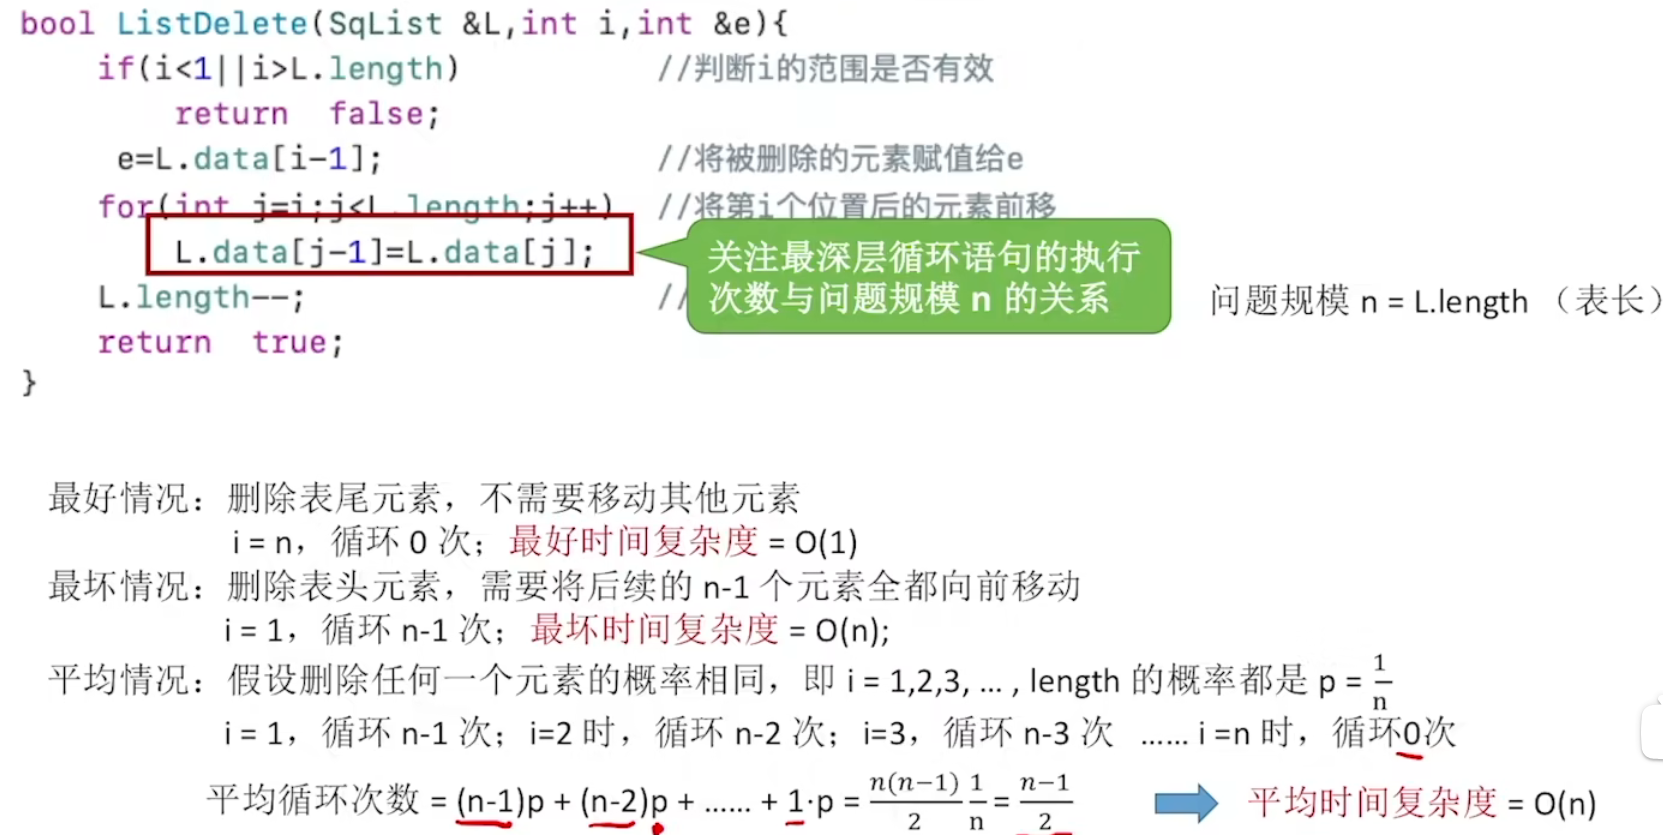
bool ListDelete (SqList &L, int i, int &e)
{
if (L.length == 0 ) return false ;
if (i < 1 || i > L.length) return false ;
e = L.data[i - 1 ];
for (int j = i; j <= L.length - 1 ; ++j)
L.data[j - 1 ] = L.data[j];
L.length--;
return true ;
}
int main ()
{
SqList L;
Initlist(L);
int e=-1 ;
if (ListDelete(L, 1 , e) == true )
{
cout << "删除的元素为:" <<e;
return 0 ;
}
else
{
return -1 ;
}
}
函数的传参,需要确定是否需要将参数返回。
不传函数地址或这不取地址,择会重新在内存中复制一份数据。
取地址决定着数据是复制一份还是延用一份。
3-1-3、顺序表的查找
顺序表的按位查找
getElem(SqList L, int i) // 按位查找操作。获取表L中第i个元素的值。
静态:
1
2
3
4
5
6
7
8
9
10 #define Maxsize 10
typedef struct {int length;
}SqList;
Elemtype getElem (SqList L, int i)
{
return L.data[i - 1 ];
}
动态:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 #define InitSize 10
typedef struct {int maxsize;
int length;
}SqList;
Elemtype getElem (SqList L, int i)
{
if (i < 1 || i > L.length)
{
return -1 ;
}
return L.data[i - 1 ];
}
对于malloc得到的内存空间。可以采用数组的方式来进行访问。访问方法和访问普通数组一样。
时间复杂度为O(1)。顺序表随机存取。
顺序表按照值查找:
LocateElem(SqList L, Elemtype e) // 按值查找操作。获取表L中第1个值为e的元素位置。
1
2
3
4
5
6
7
8
9
10
11
12
13
14 #define InitSize 10
typedef struct {int maxsize;
int length;
}SqList;
int LocateElem (SqList L, Elemtype e)
{
for (int i = 0 ; i < L.length; ++i)
if (L.data[i] == e)
return i + 1 ;
return 0 ;
}
基本数据类型:int float double char 都可以用==进行比较。
时间复杂度:
最坏情况:O(n)
最好情况:O(1)
平均情况:O(n)
3-2、链表
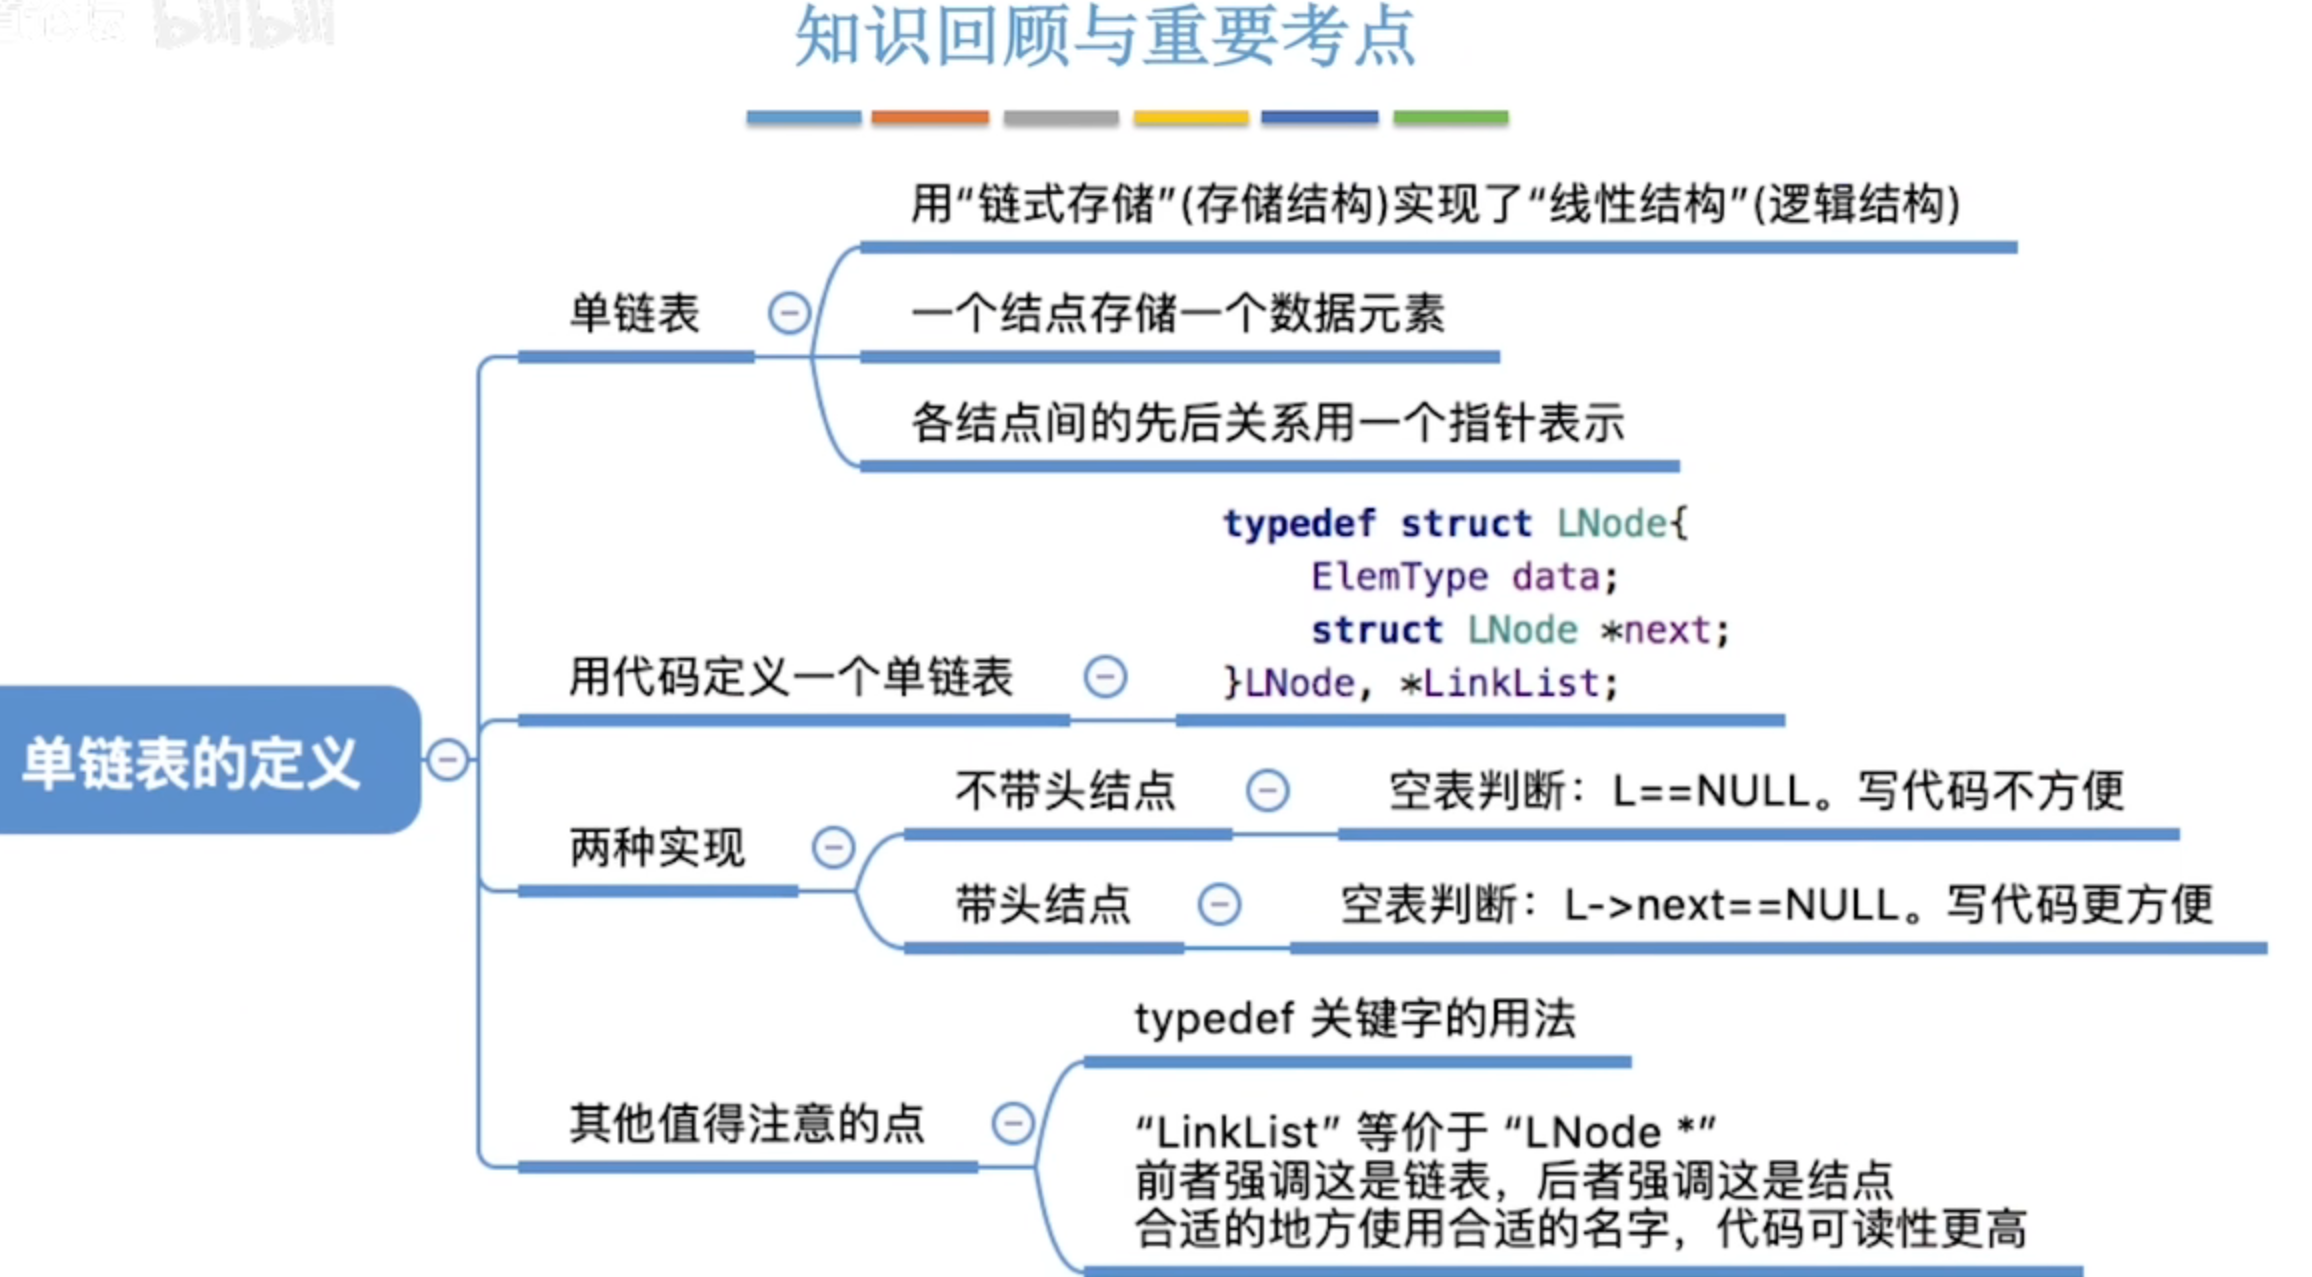
3-2-1、单链表的定义
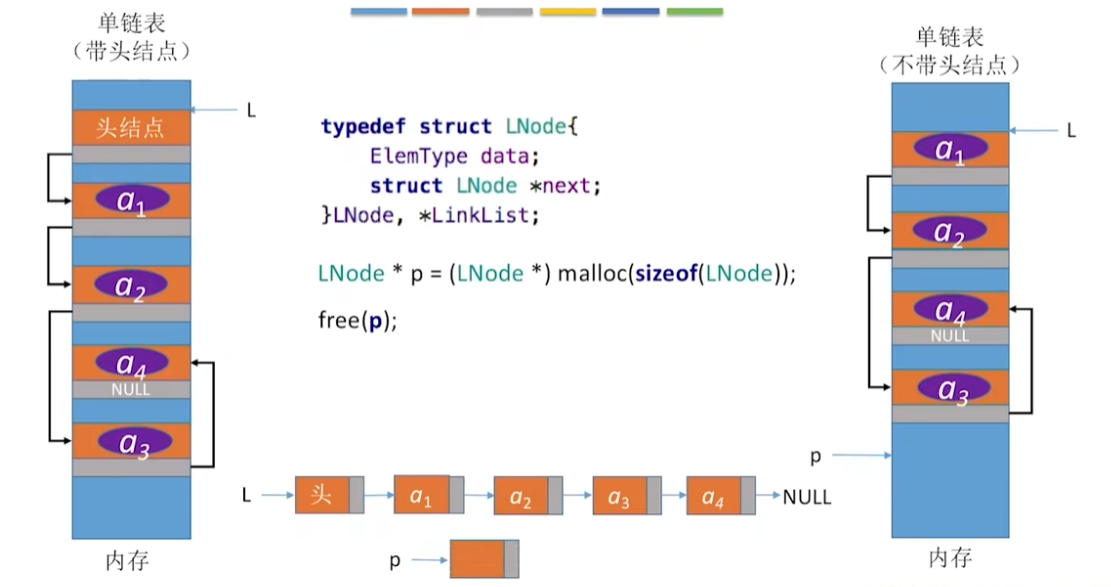
顺序表采用顺序储存,单链表采用链式储存。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
typedef struct Node {struct Node *next ;GetElem (LinkList L, int i)
{
int j = 1 ;
Node *p = L->next;
if (i < 1 ) return NULL ;
if (i == 1 ) return L;
while (p && j < i)
{
p = p->next;
++j;
}
return p;
}
Node *Linklist;
Linklist p;
强调这是一个单链表 Linklist
强调这是一个节点 Node *
不带头节点的单链表初始化方法:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
typedef struct Node {struct Node *next ;bool InitList (LinkList &L)
{
L = NULL ;
return true ;
}
void main ()
{
LinkList L ;
InitList(L);
}
bool ListEmpty (LinkList L)
{
return (L == NULL );
}
带头节点的单链表初始化方法:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
typedef struct Node {struct Node *next ;bool InitList (LinkList &L)
{
L = (Node *)malloc (sizeof (Node));
if (!L) return false ;
L->next = NULL ;
return true ;
}
void main ()
{
LinkList L;
InitList(L);
}
bool ListEmpty (LinkList L)
{
return (L->next == NULL );
}
3-2-2、单链表的插入和删除
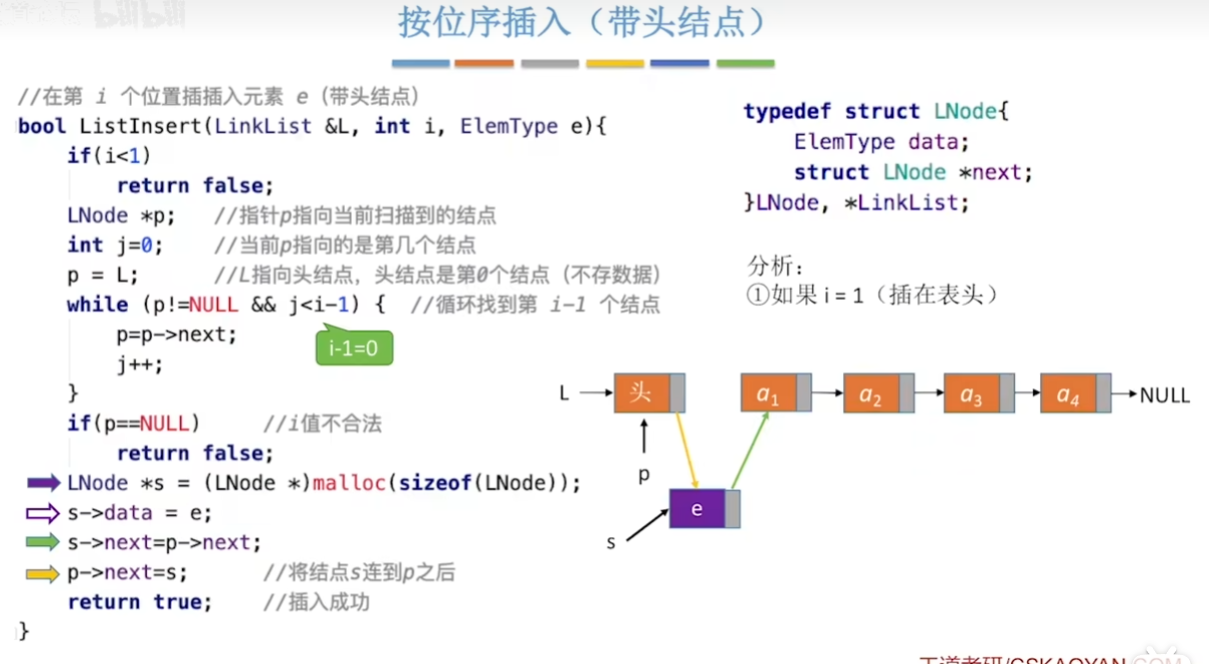
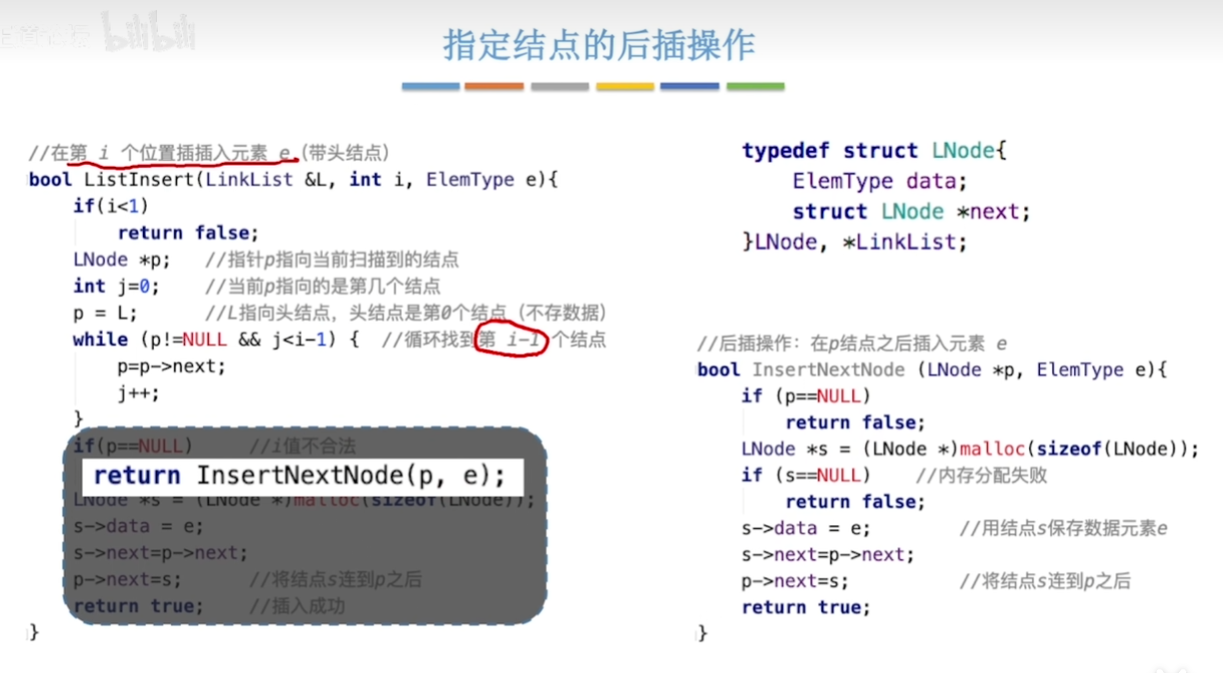
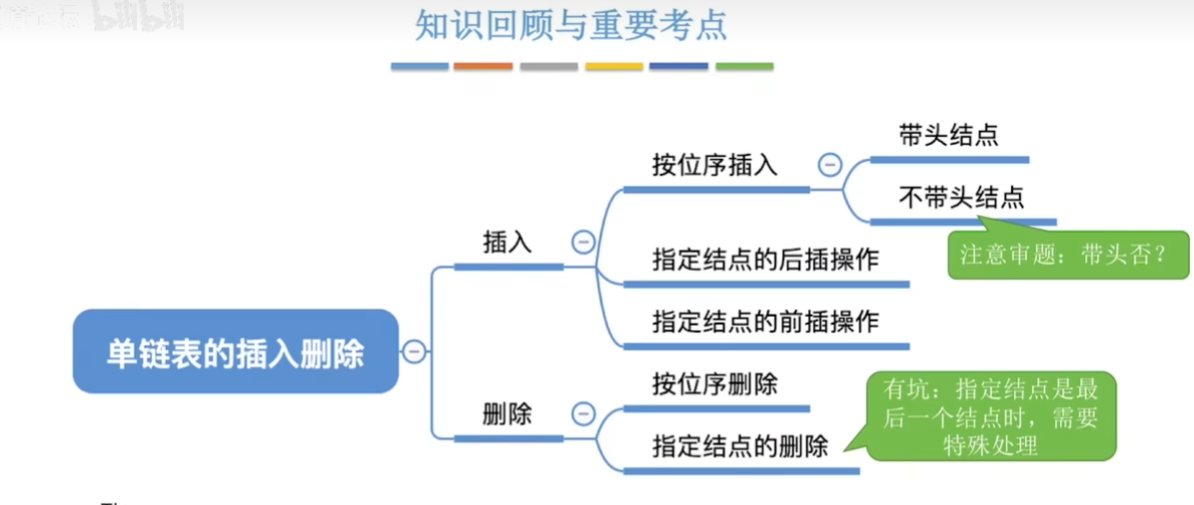
不带头节点(按位序插入)
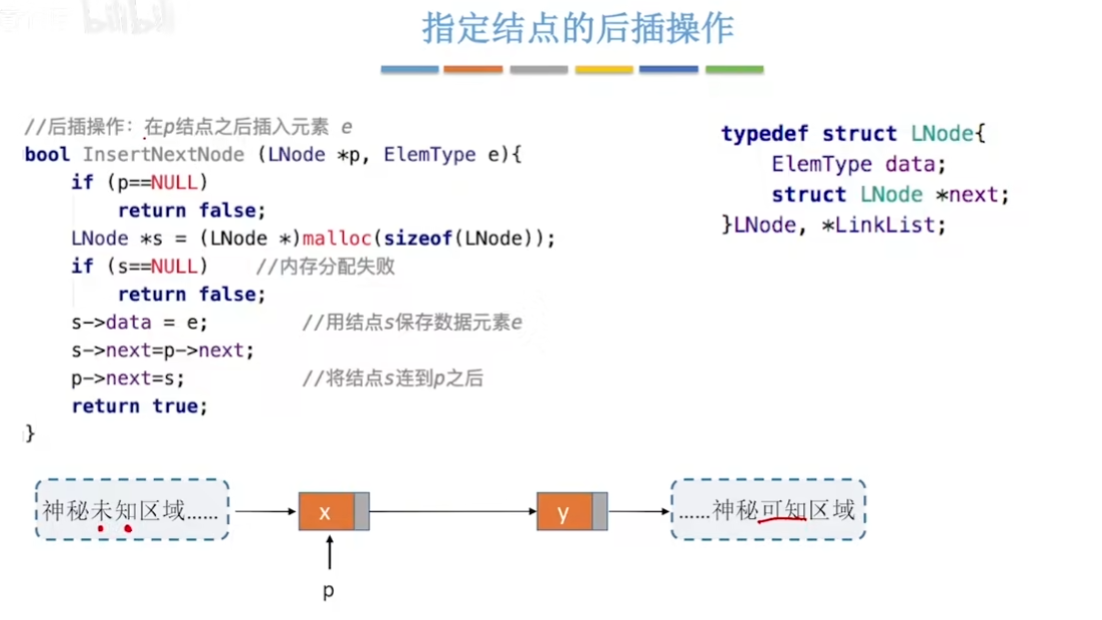
指定的结点后插入操作
与后面插入操作相比
1
2
3
4
5
bool InsertElem (LinkList L, Node *p,ElemTyep e)
然后遍历插入。
时间复杂度:O (1 )
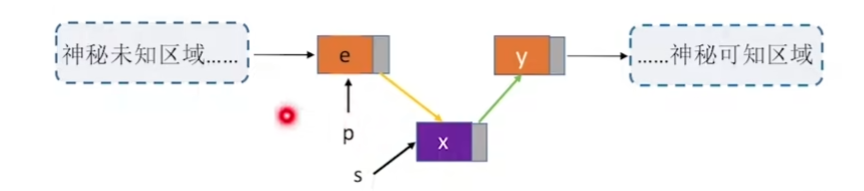
指定节点的前插操作 - 2 (节点没办法跑路。但是数据可以跑路)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
bool InsertPriorNode (Lnode *p, Elemtype e)
{
if (p == NULL )
{
return false ;
}
Node *s = (Node *)malloc (sizeof (Node));
if (!s)
{
return false ;
}
s-next = p->next;
p->next = s;
s->data = p->data;
p->data = e;
return true ;
}
时间复杂度:O(1)
直接传节点方式--原理和带跑数据一样
1
2
3
4
5
6
7
8
9
10
11
12
13
bool InsertPriorNode (Lnode *p, Node *s)
{
if (p == NULL || s == NULL )
{
return false ;
}
s->next = p->next;
p->next = s;
Elemtype temp = s->data;
s->data = p->data;
p->data = temp;
return true ;
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
typedef struct Node {struct Node *next ;bool ListDelete (LinkList &L, int i,Elemtype &e)
{
if ( i < 1 )
{
return false ;
}
Node *p ;
int j = 0 ;
p = L;
while (p! = NULL && j < i-1 )
{
p = p->next;
++j;
}
if (p ==NULL )
return false ;
if (p->next == NULL )
return false ;
Node *q = p->next;
e = q->data;
p->next = q->next;
free (q);
return true ;
}
第二个办法,和带着数据跑插入一样
这次是往要删除的后一个节点的数据赋值到前一个节点,然后删除后一个节点,这样数据就跑到前一个节点了。
1
2
3
4
5
6
7
8
9
10
11
12
13
bool ListDelete (node *p)
{
if (p == NULL || p->next == NULL )
{
return false ;
}
Node *q = p->next;
p->data = q->data;
p->next = q->next;
free (q);
return true ;
}
3-2-3、单链表的查找
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
Node *GetElem (LinkList L, int i)
{
if (i < 0 )
{
return NULL ;
}
Node *p;
int j=0 ;
p=L;
while (p != NULL && j < i)
{
p = p->next;
++j;
}
return p;
}
平均时间复杂度:O(n)
2、按值查找
1
2
3
4
5
6
7
8
9
10
11
12
13
Node *LocateElem (LinkList L, Elemtype e)
{
Node *p;
p=L->next;
while (p != NULL && p->data != e)
{
p = p->next;
}
return p;
}
3-2-4、单链表的建立
3-2-4-1、尾插法
方法:创立一个头节点。设置一个指针,永远指向尾节点。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
bool InsertNewElem (Node *p, Elemtype e)
{
if (p == NULL )
{
return false ;
}
Node *s = (Node *)malloc (sizeof (Node));
s->data = e;
s->next = p->next;
p->next = s;
return true ;
}
尾插法建立单链表:
初始化链表
设置变量Length记录链表长度
while 循环{
每次取一个数据e
LIstInsert(L, Length++, e);插入尾部
length++
}
3-2-4-2、头插法
方法:对头节点进行后插操作。(元素逆序)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
Linklist List_Headinsert (LinkList &L)
{
LNode *s;
int x;
L = (Node *)malloc (sizeof (Node));
L->next = NULL ;
while (scanf ("%d" , &x) != EOF)
{
s = (Node *)malloc (sizeof (Node));
s->data = x;
s->next = L->next;
L->next = s;
}
return L;
}
3-2-5、双链表
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
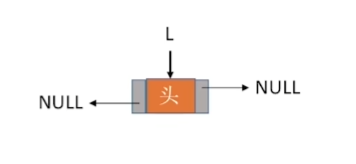
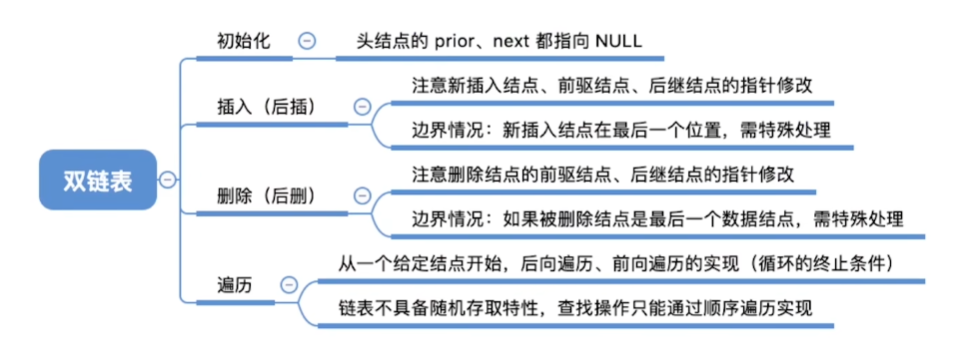
typedef struct DNode {struct DNode *prior , *next ;bool InitList_DL (DLinkList &L)
{
L = (DNode *)malloc (sizeof (DNode));
if (!L)
return false ;
L->prior = NULL ;
L->next = NULL ;
return true ;
}
bool Empty_DL (DLinkList L)
{
if (L->next == NULL )
return true ;
return false ;
}
void main ()
{
DLinkList L;
InitList_DL(L);
}
3-2-5-1、双链表的插入
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
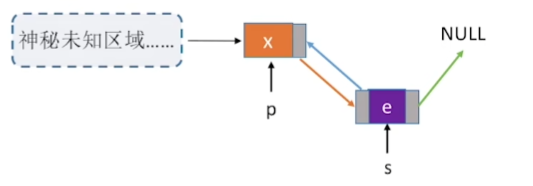
bool ListInsert_DL (DNode *p, DNode *s)
{
if (p == NULL || s == NULL )
return false ;
s->next = p->next;
if (p->next != NULL )
p->next->prior = s;
s->prior = p;
p->next = s;
return true ;
}
有点绕,看图理解
3-2-5-2、双链表的删除
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
bool Delete_DL (DNode *p)
{
if (p == NULL )
return false ;
DNode *q = p->next;
if (q == NULL )
return false ;
p->next = q->next;
if (q->next != NULL )
q->next->prior = p;
free (q);
return true ;
}
1
2
3
4
5
6
7
8
9
10
11
12
void DestroyList_DL (DLinkList &L)
{
DNode *p, *q;
p = L->next;
while (p != NULL )
{
q = p->next;
free (p);
p = q;
}
L->next = NULL ;
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
while (p != NULL )
{
p = p->next;
}
while (p != NULL )
{
p = p->prior;
}
while (p->prior != NULL )
{
p = p->prior;
}
3-2-6、循环链表
循环链表有两种,循环单链表和循环双链表。
循环单链表常用操作
尾部节点的next指向头节点
1
2
3
4
5
6
7
bool Empty_CL (LinkList L)
{
if (L->next == L)
return true ;
return false ;
}
1
2
3
4
5
6
7
bool Last_CL (LinkList L, LinkList p)
{
if (p->next == L)
return true ;
return false ;
}
循环双链表操作
1
2
3
4
5
6
7
8
9
10
bool InitList_CL (LinkList &L)
{
L = (Node *)malloc (sizeof (Node));
if (!L)
return false ;
L->next = L;
L->prior = L;
return true ;
}
1
2
3
4
5
6
bool Empty_CL (LinkList L)
{
if (L->next == L)
return true ;
return false ;
}
1
2
3
4
5
6
7
8
9
10
bool ListInsert_CL (Dnode *p, Dnode *s)
{
if (p == NULL || s == NULL )
return false ;
s->next = p->next;
p->next->prior = s;
s->prior = p;
p->next = s;
return true ;
}
1
2
3
4
5
6
7
8
9
10
bool Delete_CL (Dnode *p)
{
if (p == NULL )
return false ;
Dnode *q = p->next;
p->next = q->next;
q->next->prior = p;
free (q);
return true ;
}
3-2-7、静态链表
1
2
3
4
5
6
7
8
9
10
11
12
#define MAXSIZE 100
typedef int Status;
typedef int SElemType;
typedef struct
{int cur;
}SLinkList[MAXSIZE];
4、栈
栈:只允许在一端进行插入和删除操作的线性表,后进先出LIFO(Last In First Out)
术语:栈顶top和栈底base,空栈:top == base
基本操作:
1、初始化:分配栈空间
2、销毁:释放栈空间
3、入栈:将元素压入栈顶
4、出栈:将元素从栈顶弹出
5、读栈顶:读栈顶元素
6、判空:判断栈是否为空
4-1、顺序栈
代码中声明结构体,或者变量,就是开辟内存空间
1
2
3
4
5
6 #define MAXSIZE 100
typedef struct
{int top;
}SqStack;
1
2
3
4
void InitStack_Sq (SqStack &S)
{
S.top = -1 ;
}
1
2
3
4
5
6
bool Empty_Sq (SqStack S)
{
if (S.top == -1 )
return true ;
return false ;
}
1
2
3
4
5
6
bool Full_Sq (SqStack S)
{
if (S.top == MAXSIZE - 1 )
return true ;
return false ;
}
1
2
3
4
5
6
7
bool Push_Sq (SqStack &S, SElemType e)
{
if (S.top == MAXSIZE - 1 )
return false ;
S.data[++S.top] = e;
return true ;
}
1
2
3
4
5
6
7
bool Pop_Sq (SqStack &S, SElemType &e)
{
if (S.top == -1 )
return false ;
e = S.data[S.top--];
return true ;
}
1
2
3
4
5
6
7
bool GetTop_Sq (SqStack S, SElemType &e)
{
if (S.top == -1 )
return false ;
e = S.data[S.top];
return true ;
}
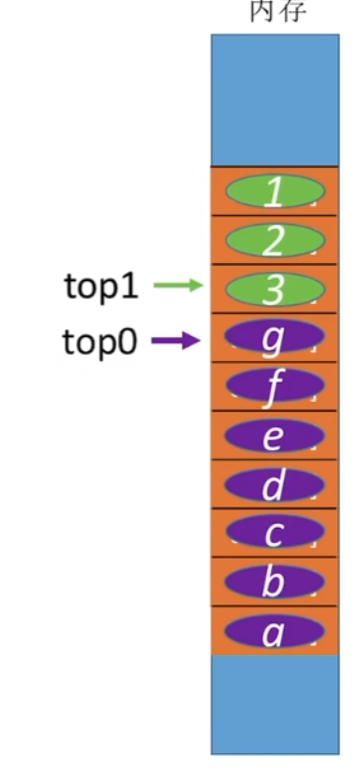
4-1-1、共享栈
1
2
3
4
5
6
typedef struct
{int top0;
int top1;
}SqQueue;
1
2
3
4
5
void InitStack_Sq (SqQueue &Q)
{
Q.top0 = -1 ;
Q.top1 = MAXSIZE;
}
内存增长方向相反
4-2、链栈
使用链表的一段进行插入,或者删除操作,实现栈操作。
5、队列
5-1、顺序队列
1
2
3
4
5
6
7 #define MAXSIZE 100
typedef struct
{int front;
int rear;
}SqQueue;
1
2
3
4
5
6
bool Empty_Sq (SqQueue Q)
{
if (Q.front == Q.rear)
return true ;
return false ;
}
1
2
3
4
5
6
7
8
bool EnQueue_Sq (SqQueue &Q, SElemType e)
{
if ((Q.rear + 1 ) % MAXSIZE == Q.front)
return false ;
Q.data[Q.rear] = e;
Q.rear = (Q.rear + 1 ) % MAXSIZE;
return true ;
}
利用取余运算,实现循环队列。逻辑上实现闭环
1
2
3
4
5
6
7
8
9
bool DeQueue_Sq (SqQueue &Q, SElemType &e)
{
if (Q.front == Q.rear)
return false ;
e = Q.data[Q.front];
Q.front = (Q.front + 1 ) % MAXSIZE;
return true ;
}
1
2
3
4
5
6
7
8
9 #define MAXSIZE 100
typedef struct
{int front;
int rear;
int flag;
}SqQueue;
5-2、链队列
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
tyepdef struct QNode
{struct QNode *next ;typedef struct
{bool InitQueue (LinkQueue *Q)
{
Q->front = Q->rear = (QueuePtr)malloc (sizeof (QNode));
if (!Q->front)
return false ;
Q->front->next = NULL ;
return true ;
}
bool IsEmpty ()
{
if (Q->front == Q->rear)
return true ;
return false ;
}
void EnQueue (LinkQueue *Q, SElemType e)
{
QueuePtr s = (QueuePtr)malloc (sizeof (QNode));
if (!s)
return ;
s->data = e;
s->next = NULL ;
Q->rear->next = s;
Q->rear = s;
return ;
}
bool DeQueue (LinkQueue *Q, SElemType &e)
{
if (Q->front == Q->rear)
return false ;
QueuePtr *p = Q->front->next;
e = p->data;
Q->front->next = p->next;
if (Q->rear == p)
Q->rear = Q->front;
free (p);
return true ;
}
void main ()
{
LinkQueue Q;
InitQueue(&Q);
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
void InitQueue (LinkQueue *Q)
{
Q->front = NULL ;
Q->rear = NULL ;
}
bool IsEmpty (LinkQueue Q)
{
if (Q.front == NULL )
return true ;
return false ;
}
void EnQueue (LinkQueue *Q, QElemType e)
{
QueuePtr s = (QueuePtr)malloc (sizeof (QNode));
if (!s)
return ;
s->data = e;
s->next = NULL ;
if (Q->front == NULL )
{
Q->front = s;
Q->rear = s;
}
else
{
Q->rear->next = s;
Q->rear = s;
}
return ;
}
bbool DeQueue (LinkQueue *Q, QElemType &e)
{
if (Q->front == NULL )
return false ;
QueuePtr p = Q->front;
e = p->data;
Q->front = p->next;
if (Q->rear == p)
{
Q->rear = NULL ;
Q->front = NULL ;
}
free (p);
return true ;
}
5-3、双端队列
有多种形式,双端队列:只允许从两端插入、两端删除的线性表。
输入受限的双端队列:只允许一端插入,两端的删除操作。
输出受限的双端队列:只允许一端删除,两端的插入操作。
6、栈在括号匹配中的应用
IDE:可视化编程环境
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32 #define MAXSIZE 100
typedef struct
{int top;
}SqStack;
bool bracketCheck (char str[],int length)
{
SqStack S;
InitStack(&S);
for (int i=0 ;i<length;i++)
{
if (str[i] == '(' || str[i] == '[' || str[i] == '{' )
Push(&S,str[i]);
else if (str[i] == ')' )
{
if (S.top == -1 )
return false ;
}
char topElem = pop(&S);
if (str[i] == ')' && topElem != '(' )
return false ;
if (str[i] == ']' && topElem != '[' )
return false ;
if (str[i] == '}' && topElem != '{' )
return false ;
}
if (S.top != -1 )
return false ;
return true ;
}
7、队列在括号匹配中的应用
表达式:由操作数、运算符和界限符组成的序列。
8、栈在递归中的应用
函数调用的特点:最后调用的函数最先返回。也就符合栈的先进后出特点。
函数调用时,需要用栈来保存现场信息。
9、队列应用
在操作系统中,进程调度算法:先来先服务、短作业优先、时间片轮转。
在树中,先序遍历、中序遍历、后序遍历。也是用队列来实现的。
10、特殊矩阵的压缩存储
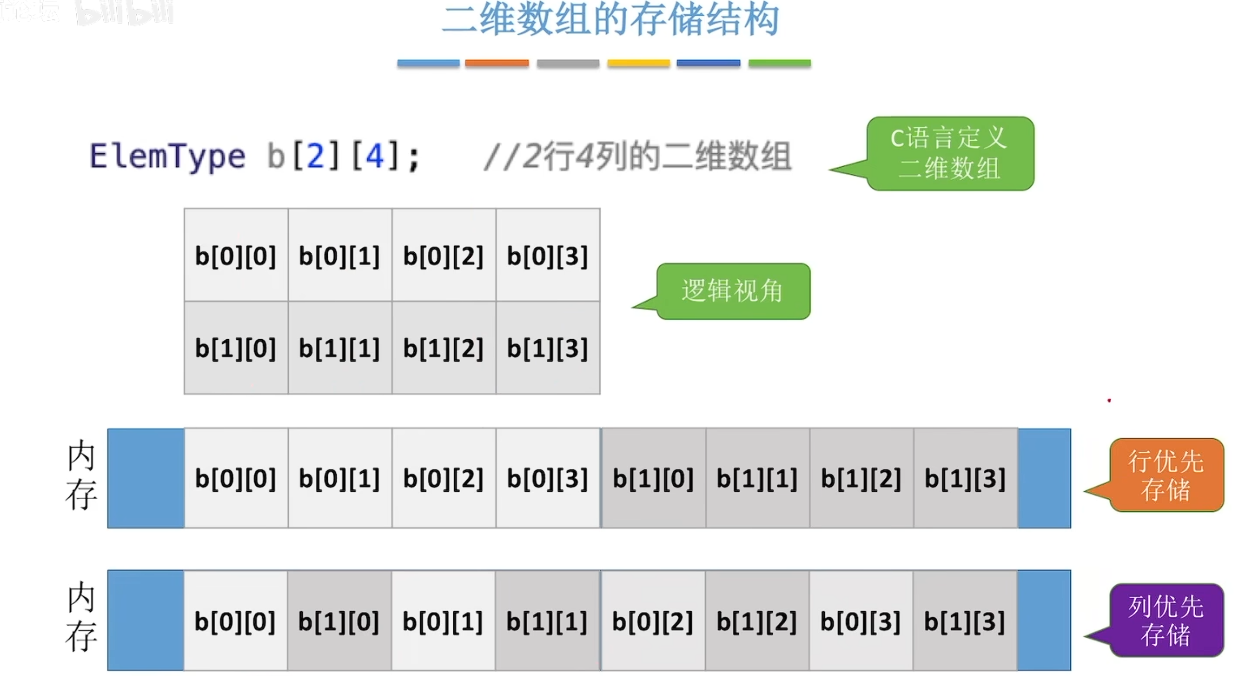
一维数组存储结构:线性储存。
二维数组存储结构:行优先存储、列优先存储。都是线性。知道行号和列号,能直接得出地址。
矩阵:使用数组存储
特殊矩阵:
1、对称矩阵:对角线元素相同。
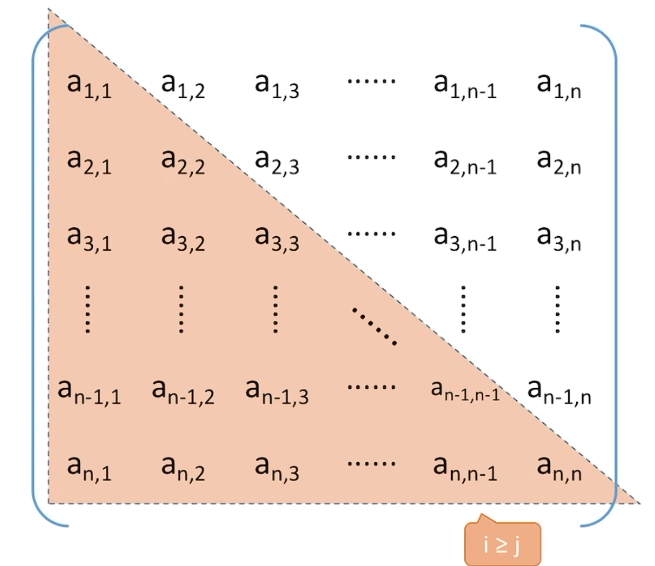
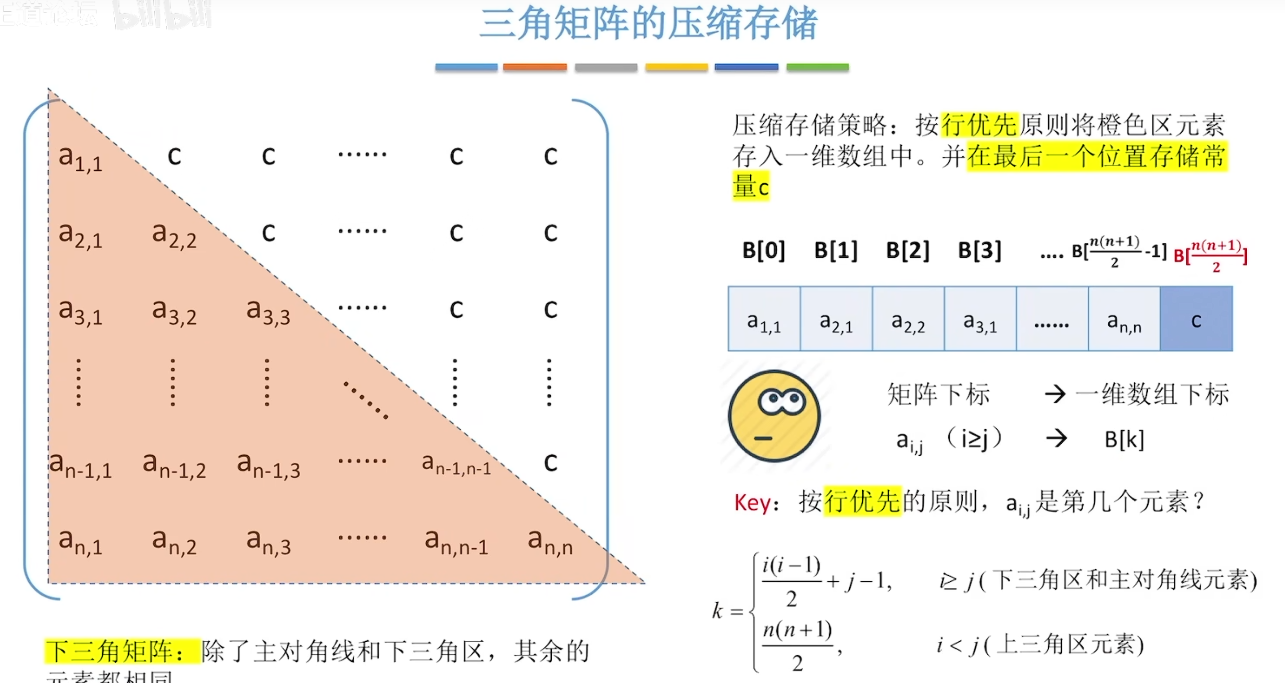
策略:只存储对角线元素+下三角元素。按行优先存储或者列优先存储。
2、三角矩阵:上三角元素和下三角元素都为0。
3、对角矩阵:主对角线元素为1,其他元素为0。同样用一维数组存储。
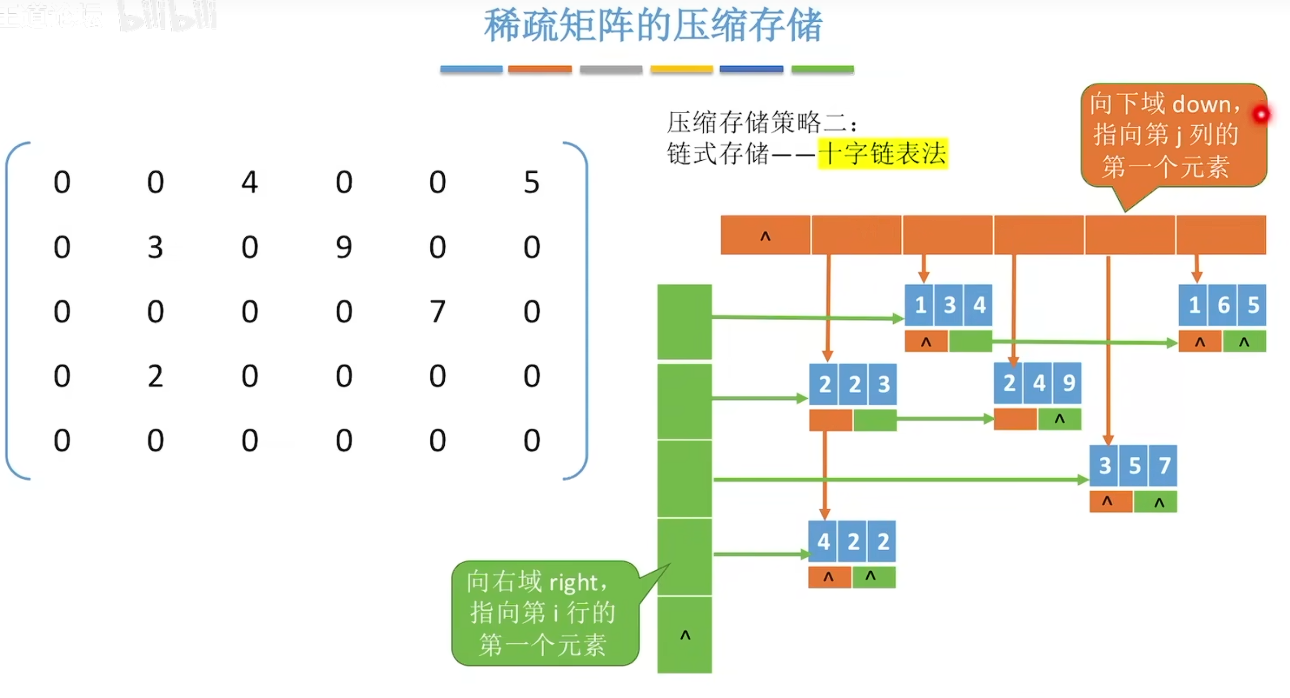
4、稀疏矩阵:元素个数远小于n*m。两种方法存储:顺序存储三元组、链式存储十字链表。
11、串
串:就是字符串,由0个或多个字符组成的有限序列。
串名:字符串的名称,是串的首地址。
串的长度:串中字符的个数。
空串:长度为0的串,空格也算字符。有空格不算空串。
子串:串中任意个连续的字符组成的串。
子串在主串中出现的位置:子串第一个字符在主串中的位置。
存储时以线性的方式存储。
主要操作:
假设有串T="",S="iphone 11 pro Max",W = "pro"
StrAssign(T,s):将串s赋值给串T。
StrEmpty(T):判断串T是否为空串。
StrLength(T):求串T的长度。
StrCopy(T,S):将串S复制给串T。
ClearSring(T):清空串T。
DestoryString(T):销毁串T。
Concat(T,S1,S2):将串S1和S2连接起来,生成新串T。
SubString(&Sub,S,i,j):求子串Sub,其值等于主串S中从第i个字符开始的子串。
Indext(S,T):返回串S中与串T相等的第一个子串的起始位置。否则返回0。
StrCompare(S,T):比较串S和串T的大小关系,逐个字符比较,直到出现大小关系为止。以ASCCII码值大小比较。每个字符的ASCCII码值大小关系。
字符集
英文和控制符:ASCCII码值。一个字符占1个字节。
中英文:Unicode码值。一个字符占3个字节。
基于同一种码值,不同编码方式,有uft-8、utf-16、utf-32。
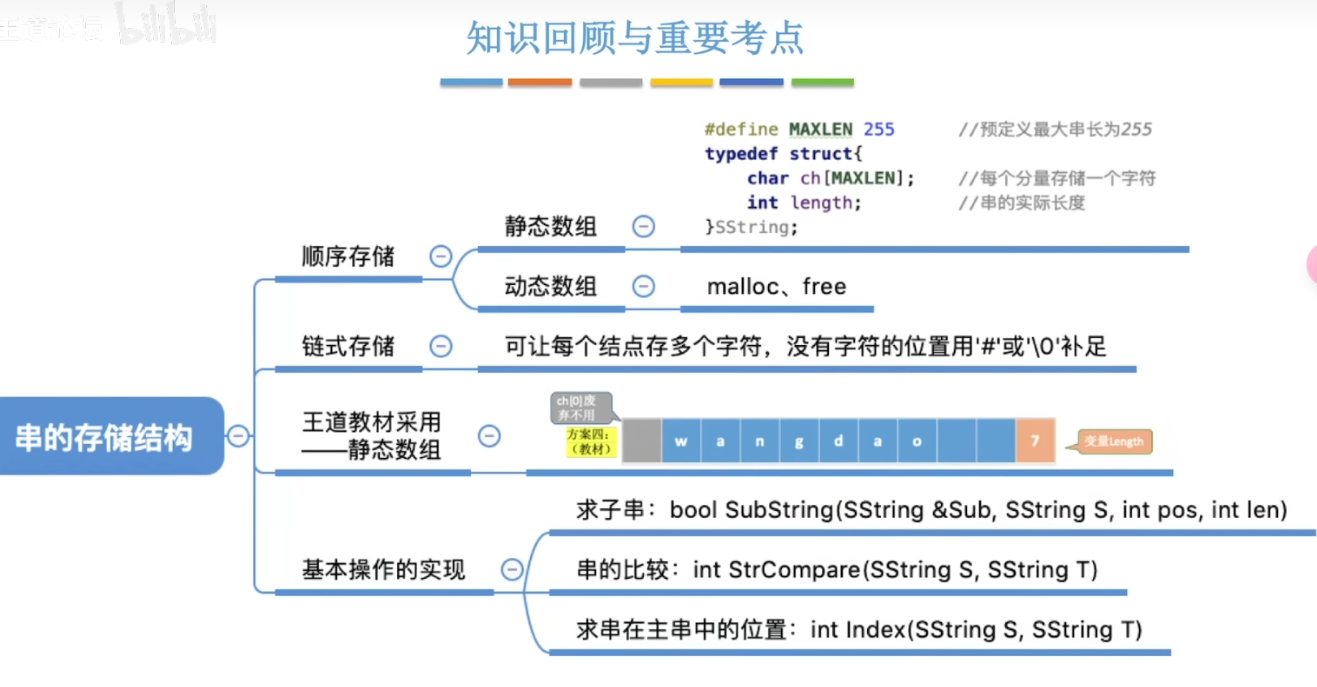
11-1、串的存储结构
1
2
3
4
5
6 #define MAXSIZE 100
typedef struct
{char data[MAXSIZE];
int length;
}SqString;
1
2
3
4
5
6
7
8
9
10 #define MAXSIZE 100
typedef struct Node
{char *ch;
int length;
}LinkNode, *LinkString;
Hstring S;
S.data = (char *)malloc (sizeof (char ) * MAXSIZE);
S.length = 0 ;
1
2
3
4
5
tyoedef struct StringNode
{char ch[i];
struct StringNode *next ;
11-2、顺序串的功能实现
Substring(&sub,S,i,j):求子串Sub,其值等于主串S中从第i个字符开始,长度为j的子串。
假设S.ch = "yanggguanchao"
S.length = 14
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18 #define MAXSIZE 100
typedef struct
{char ch[MAXSIZE];
int length;
}String;
bool Substring (String &sub,String S,int i,int j)
{
if (i+j - 1 > S.length)
return false ;
for (int k = i; k <= i+j; k++)
Sub.ch[k-i +1 ] = S.ch[k];
sub.length = j;
return true ;
}
比较串S和串T的大小关系,若S>T,逐个字符比较,直到出现大小关系为止。以ASCCII码值大小比较。
1
2
3
4
5
6
7
8
9
int StrCompare (String S,String T)
{
for (int i = 0 ; i < S.length && i < T.length; i++)
{
if (S.ch[i] != T.ch[i])
return = S.ch[i] - T.ch[i];
}
return S.length - T.length;
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
int Index (String S,String T)
{
int i = 0 ;
int n = StringLength(S);
int m = StringLength(T);
while (i <= n - m + 1 ){
Substring(Sub,S,i,m);
if (StrCompare(Sub,T) != 0 )
i++;
else
return i;
}
return 0 ;
}
11-3、串的模式匹配
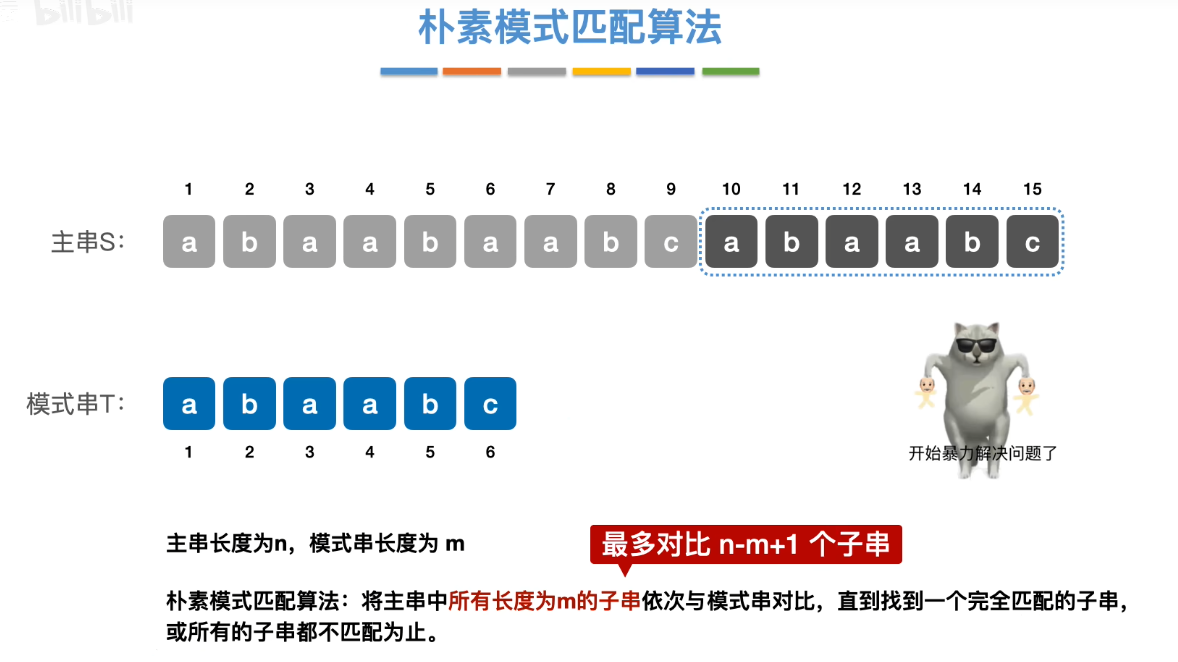
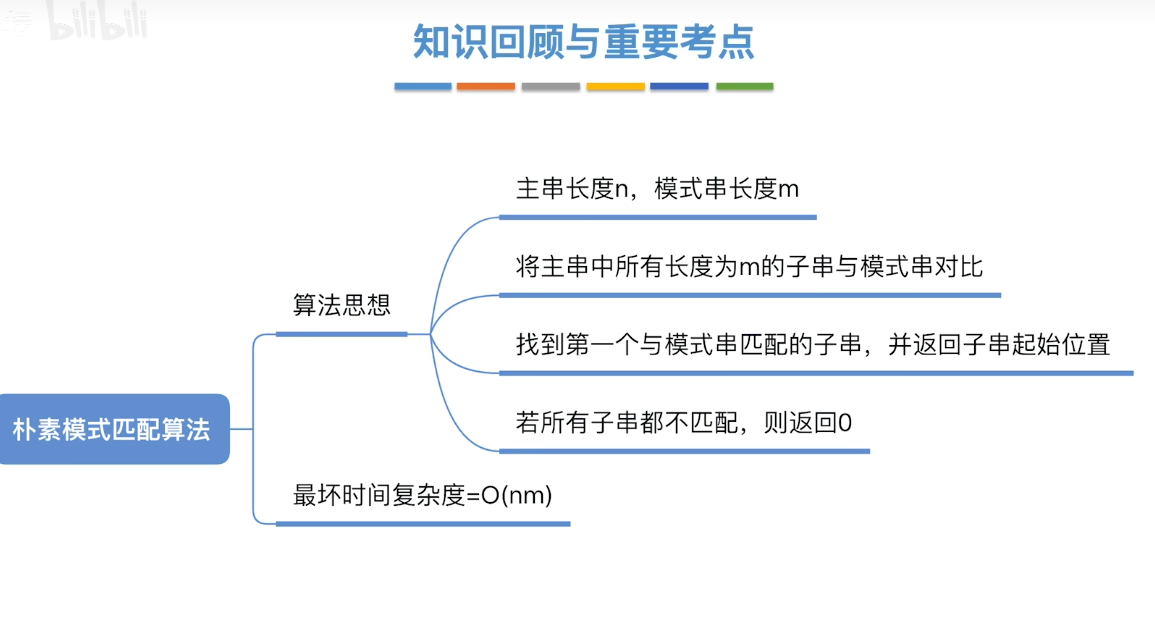
朴素模式暴力匹配算法
子串:一定或者没有在主串中
模式串:找到的不一定是你想要的
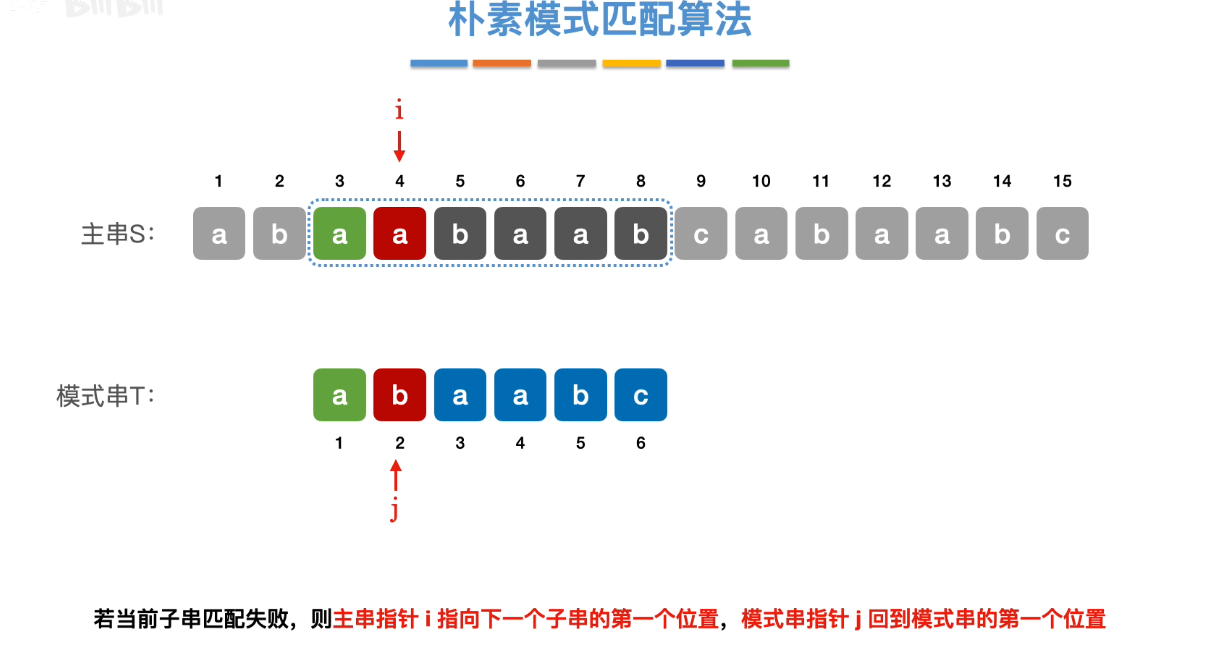
上一节的子串匹配算法,在主串中找子串。即使一个朴素模式匹配算法。
通过数组下标,进行匹配。主串指针在头处,模式串指针
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
int Index (String S,String T)
{
int i = 0 ;
int j = 0 ;
while (i <= S.length - T.length)
{
++j;
++i;
}
else
{
i=i-j+2 ;
j = 1 ;
}
if (j > T.length)
return i - T.length;
else
return 0 ;
}
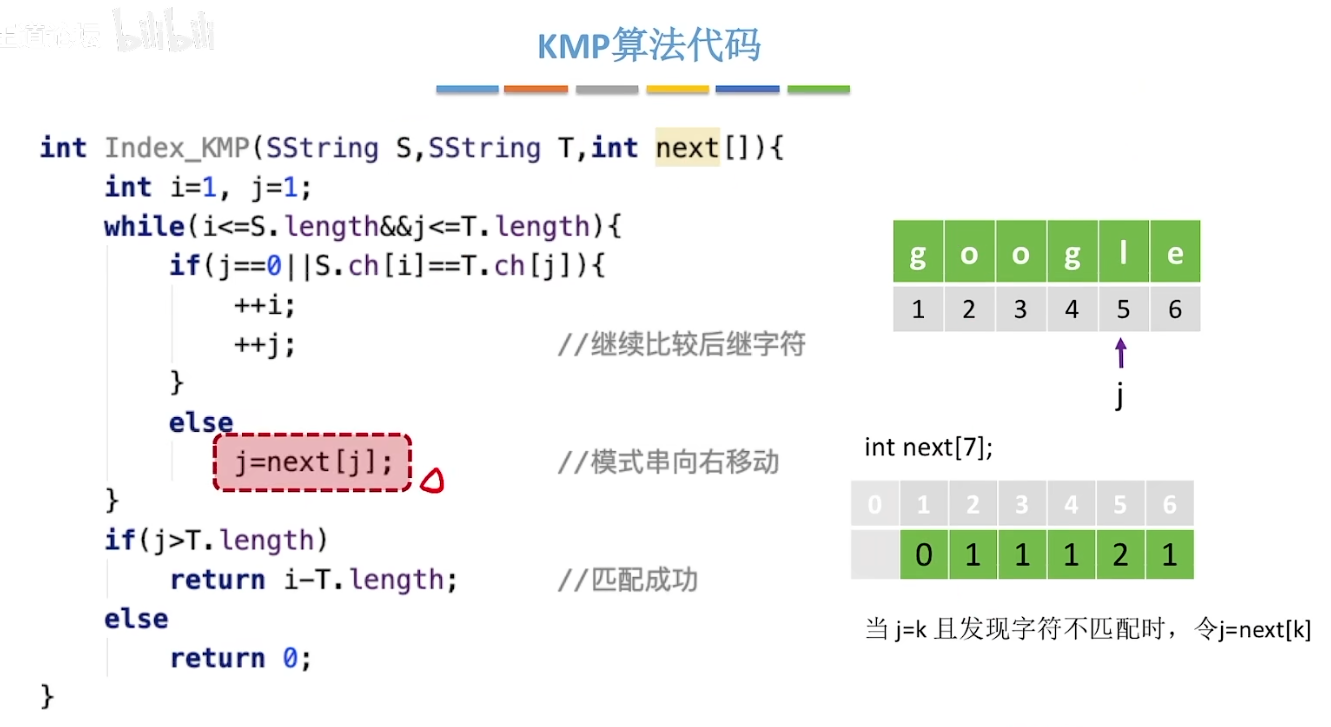
11-4、KMP算法
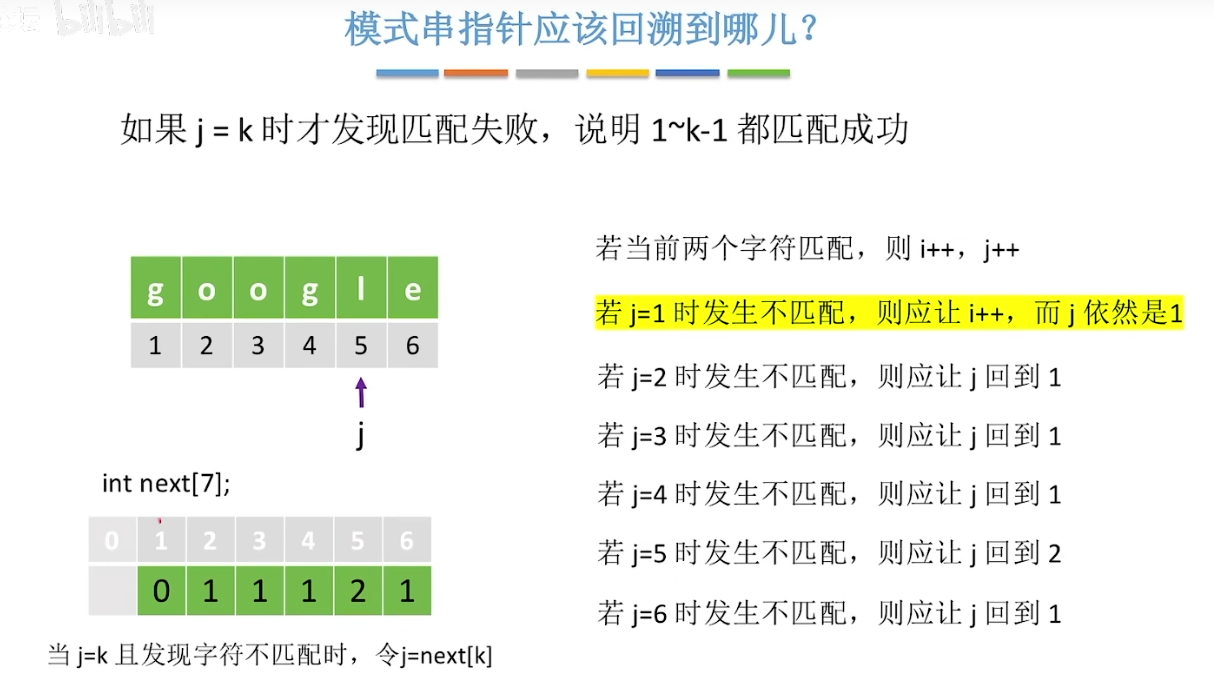
是对朴素模式匹配算法的改进。主串指针不返回,模式串指针返回
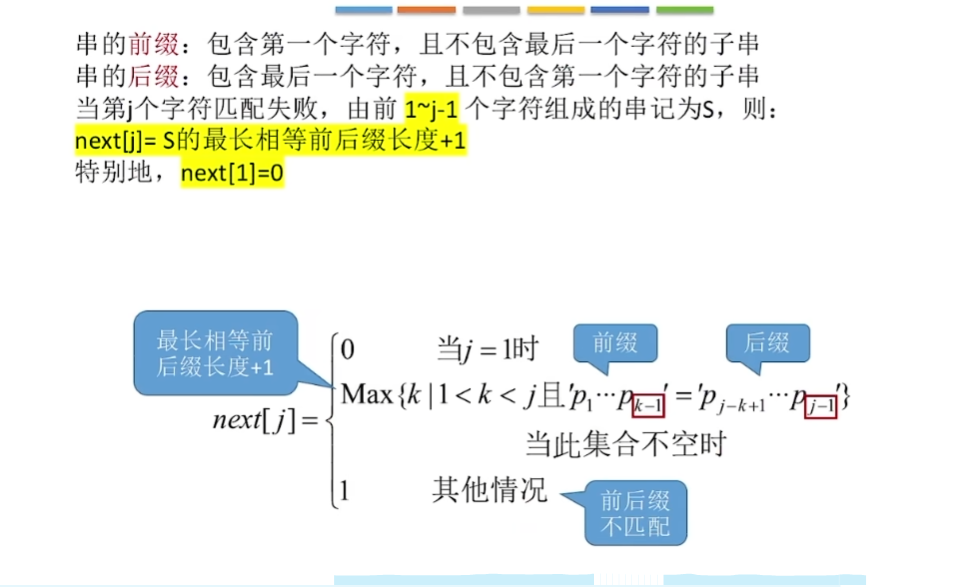
扫描过的位置放到数组中。当发生某一位不匹配,模式串指针返回该位置
求next数组
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
void getNext (String T,int next[])
{
int i = 1 ;
int j = 0 ;
next[1 ] = 0 ;
while (i < T.length)
{
if (j == 0 || T.ch[i] == T.ch[j])
{
++i;
++j;
next[i] = j;
}
else
j = next[j];
}
}
int Index_KMP (String S,String T)
{
int i = 1 ;
int j = 1 ;
get_next(T,next);
while (i <= S.length && j <= T.length)
{
if (j == 0 || S.ch[i] == T.ch[j])
{
++i;
++j;
}
else
j = next[j];
}
if (j > T.length)
return i - T.length;
else
return 0 ;
}
12、树
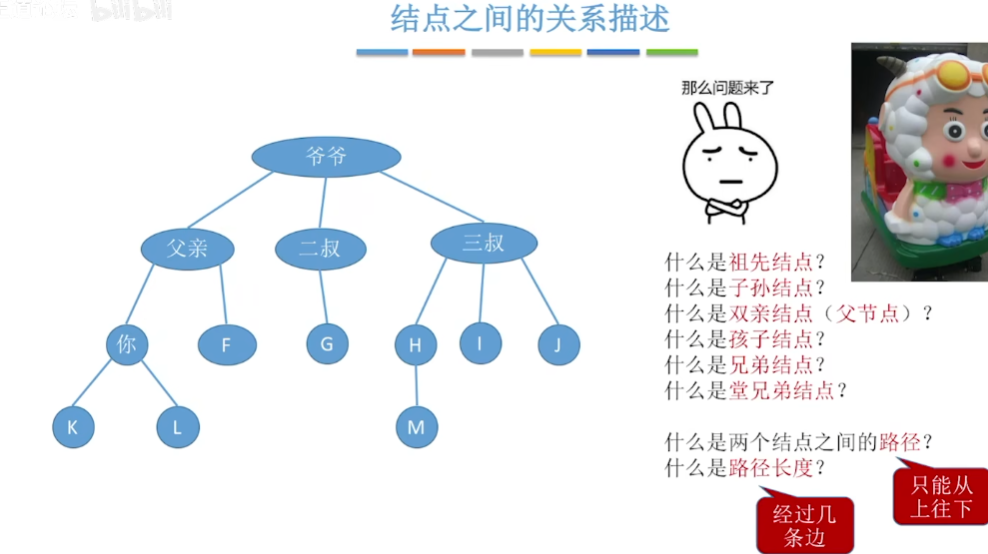
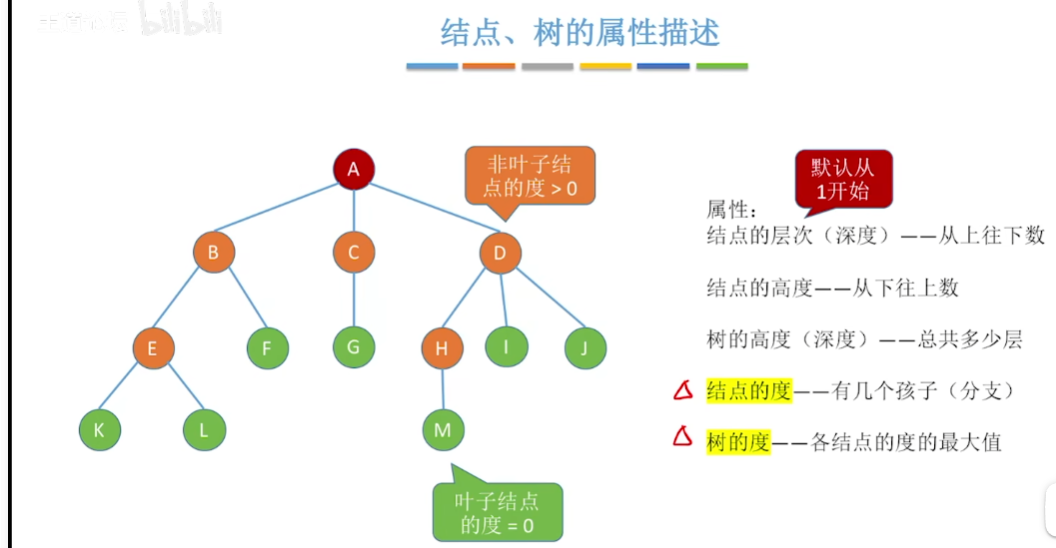
根节点:开始节点。
叶子节点:没有子节点的节点。
边:连接节点。
分支节点:有子节点的节点。
空树:没有节点的树。
非空树:
有节点的树。有且只有一个根节点。
没有后继的节点称之为“叶子节点”
有后继的节点称之为“分支节点”
树:由n(n>=0)个节点组成的有限集合。n=0时,称为空树。任意一个非空树m,有且仅有一个根节点。任何一个节点都有仅且只有一个父节点。
树形结构应用
文件系统
国家省市县区镇村
有序树:从逻辑上看,树中结点的各个子树从左到右是有次序的,不能互换。
无序树:从逻辑上看,树中结点的各个子树从左到右是无次序的,可以互换。
12-1、二叉树
定义
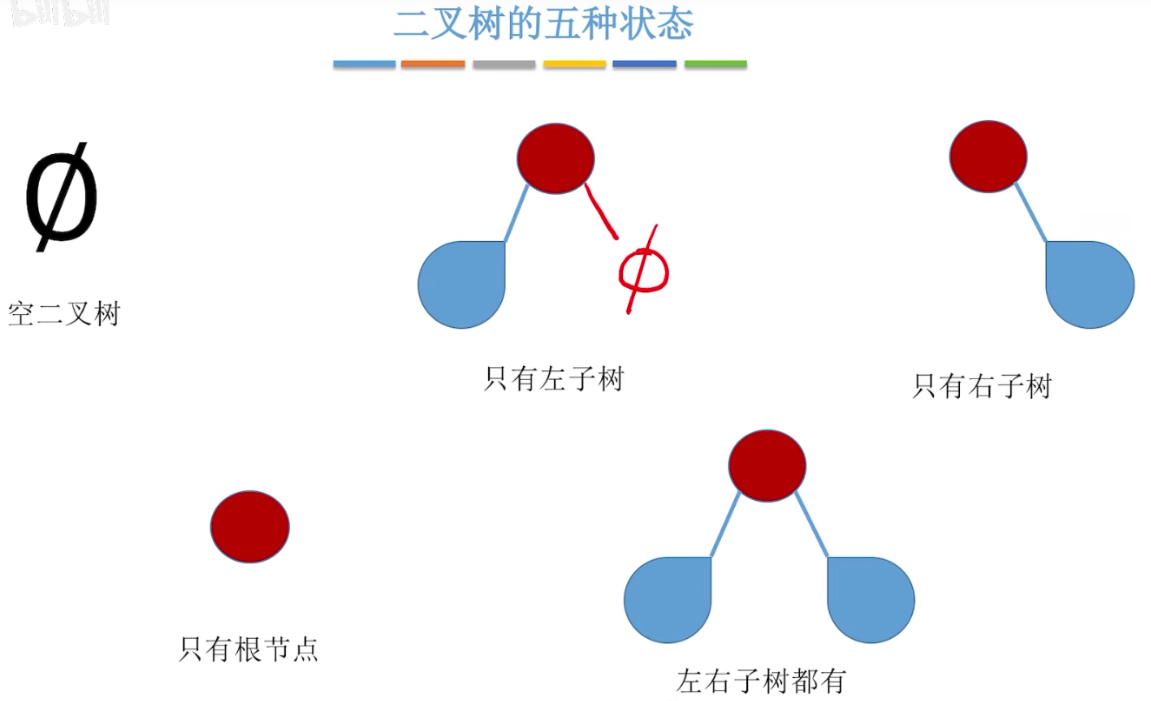
二叉树:每个节点最多有两个子树的树结构。
二叉树的性质
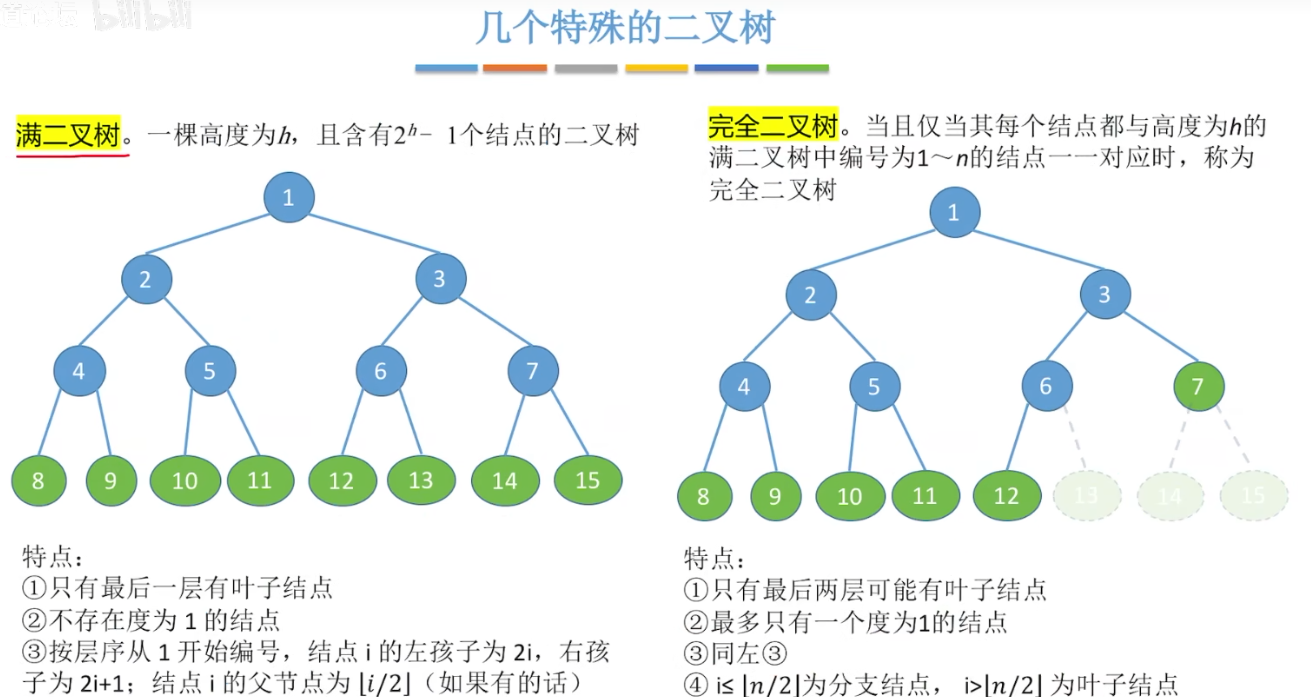
1、 二叉树的深度为k,则最多有2^k-1个结点。
2、左右树不能互换。有序树。
几种特殊的二叉树:
12-2、二叉树的存储结构
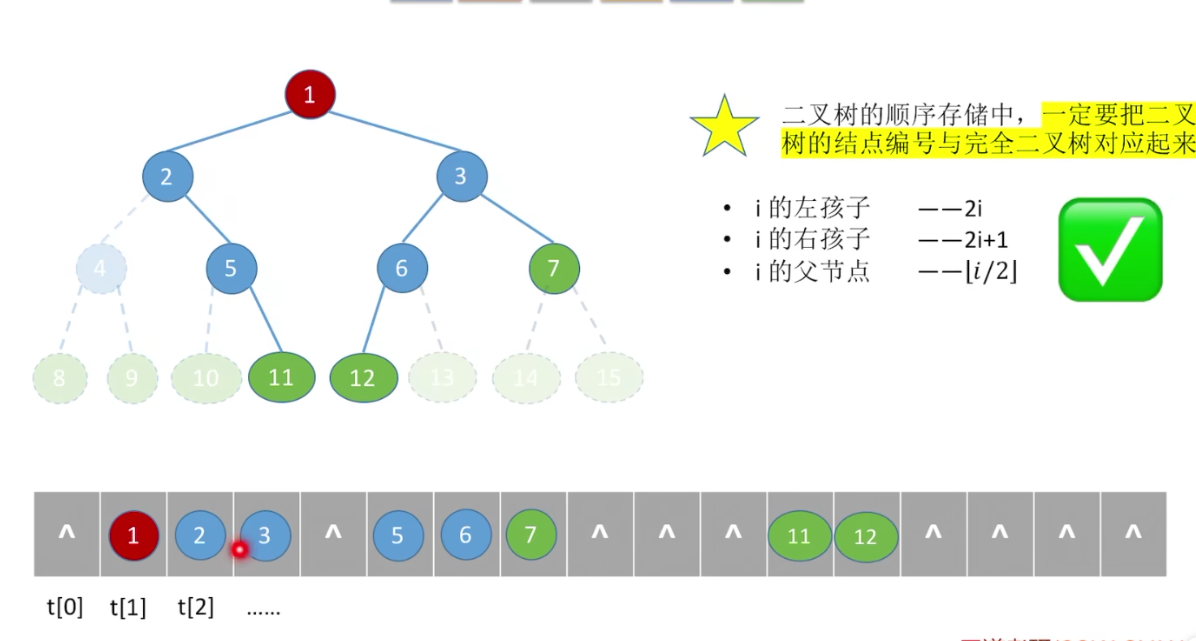
顺序存储结构:用一维数组存储二叉树。(能快速访问,但是会浪费存储空间)
链式存储结构:用指针域存储二叉树。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
typedef struct {int data;
BiTNode *lchild, *rchild;
}BiTNode, *BiTree;
int main ()
{
BiTree root;
root = (BiTNode *)malloc (sizeof (BiTNode));
root->data = 1 ;
root->lchild = NULL ;
root->rchild = NULL ;
BiTNode *left = (BiTNode *)malloc (sizeof (BiTNode));
left->data = 2 ;
left->lchild = NULL ;
left->rchild = NULL ;
root->lchild = left;
}
在实际过程中,如果二叉树查找父节点很费时间,可以设置一个指针域,指向父节点。
1
2
3
4
5
6
7
struct BiTNode
{
ElemType data ;
12-3、二叉树的遍历
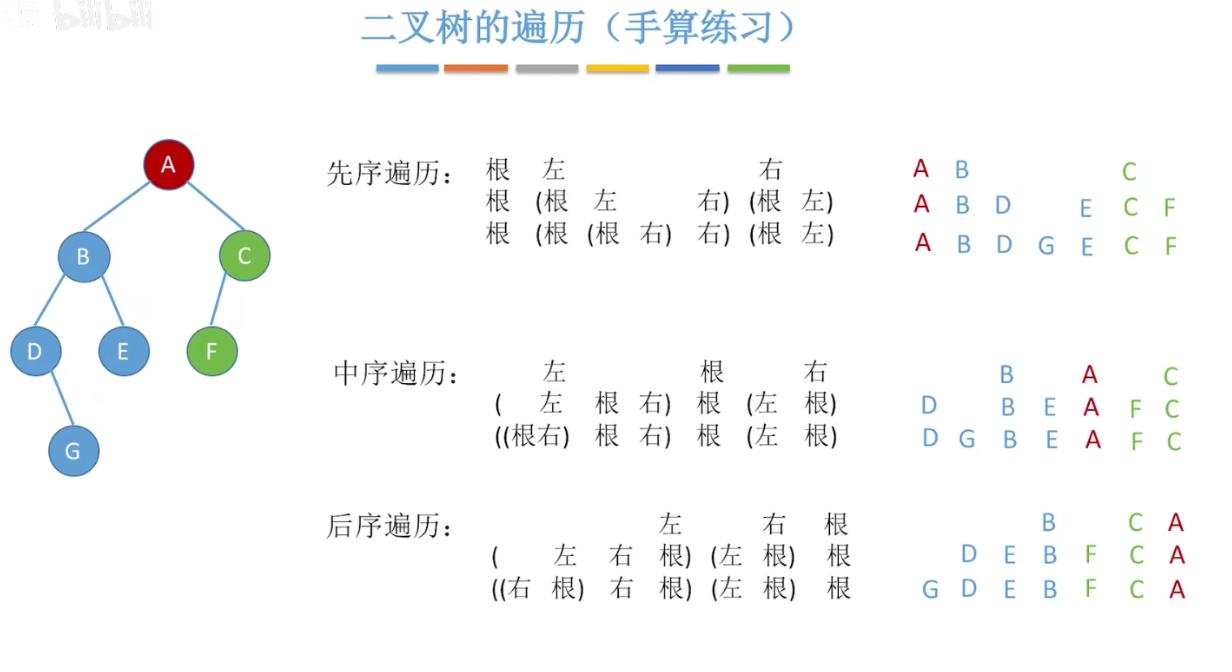
先序遍历:
1、若二叉树为空,则返回空操作;
2、若二叉树非空:
(1)访问根节点;
(2)先序遍历左子树;
(3)先序遍历右子树。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
typedef struct BiTNode {struct BiTNode *lchild , *rchild ;void PreOrder (BiTree T)
{
if (T != NULL )
{
visit(T);
PreOrder(T->lchild);
PreOrder(T->rchild);
}
}
中序遍历:
1、若二叉树为空,则返回空操作;
2、若二叉树非空:
(1)中序遍历左子树;
(2)访问根节点;
(3)中序遍历右子树。
1
2
3
4
5
6
7
8
9
void InOrder (BiTree T)
{
if (T != NULL )
{
InOrder(T->lchild);
visit(T);
InOrder(T->rchild);
}
}
后序遍历:
1、若二叉树为空,则返回空操作;
2、若二叉树非空:
(1)后序遍历左子树;
(2)后序遍历右子树;
(3)访问根节点。
1
2
3
4
5
6
7
8
9
viod PostOrder (BiTree T)
{
if (T != NULL )
{
PostOrder(T->lchild);
PostOrder(T->rchild);
visit(T);
}
}
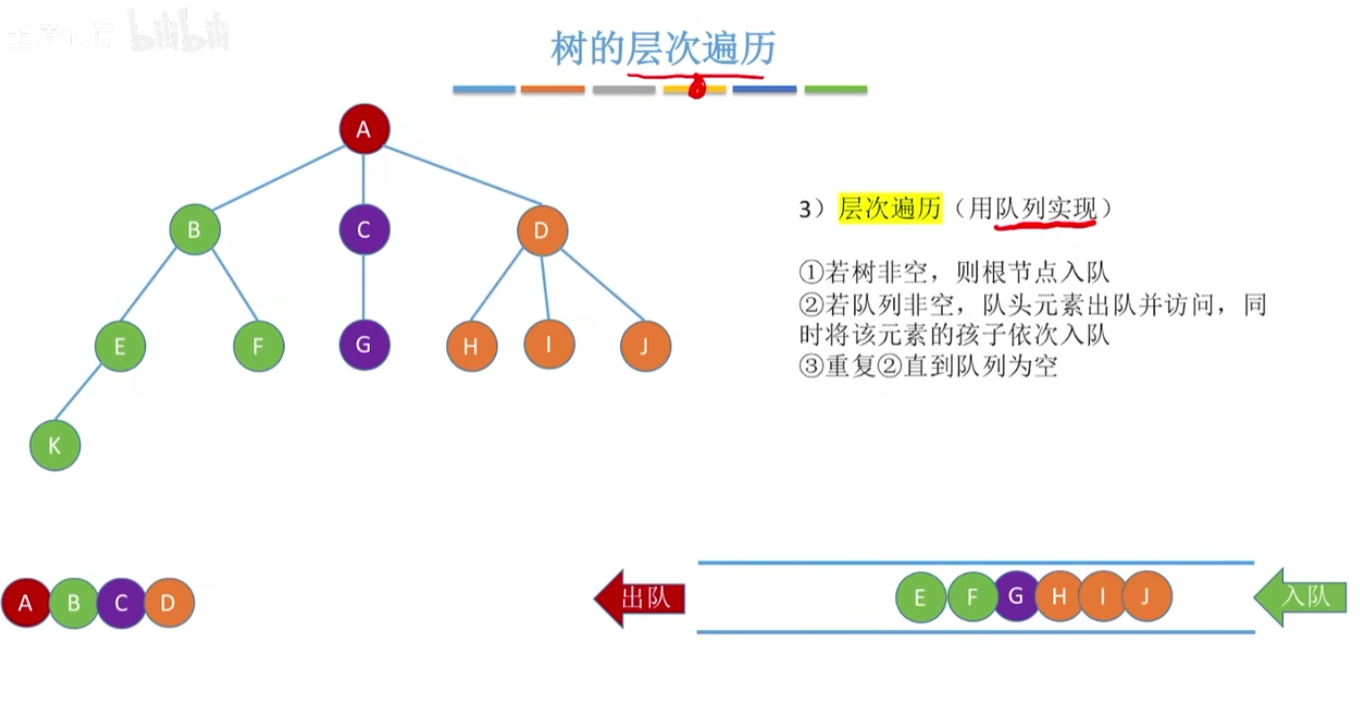
12-4、二叉树的层序遍历
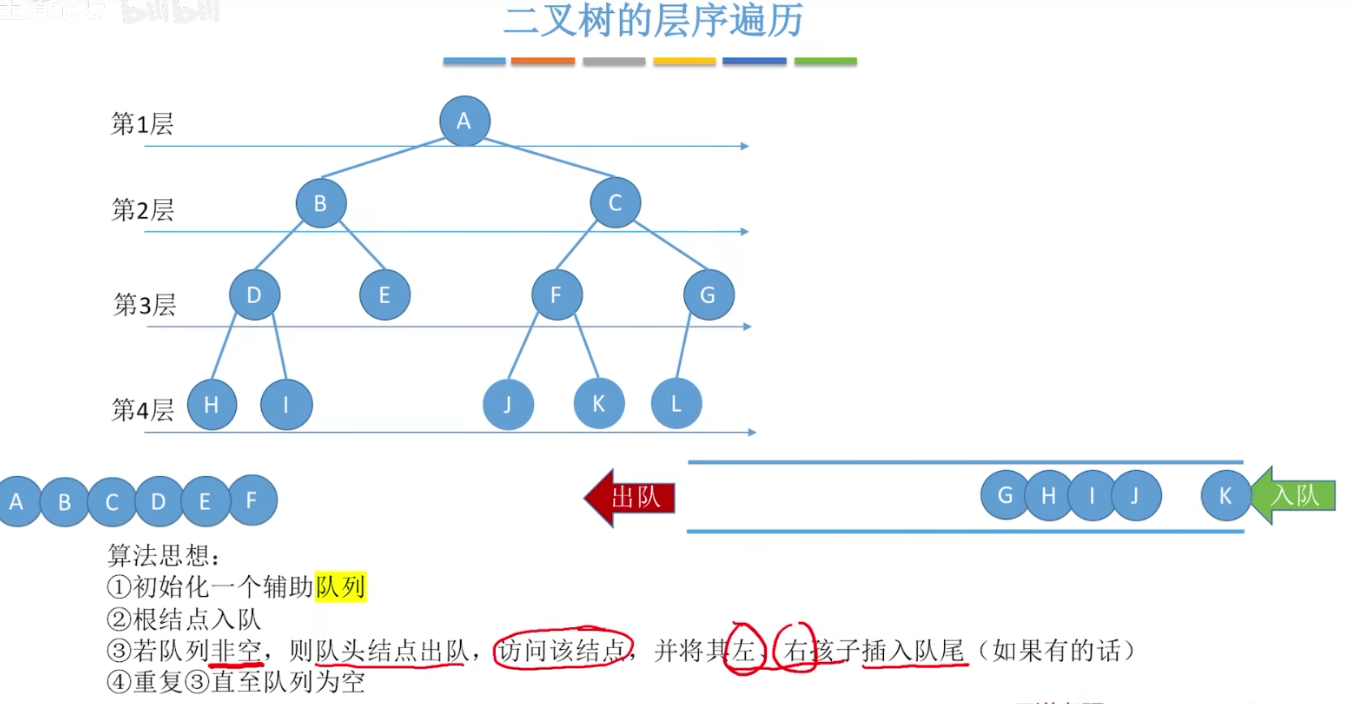
算法描述
1、创建一个队列Q,并将根节点入队;
2、根节点入队后
3、若队列非空,则队头元素出队,访问该节点;并判断该节点的左右孩子是否为空,若非空,则将该节点入队;
4、循环3,直到队列为空。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 #include <stdio.h>
void LevelOrder (BiTree T)
{
LinkQueue Q;
InitQueue(&Q);
BiTree p;
EnQueue(&Q, T);
while (!QueueEmpty(Q))
{
DeQueue(&Q, &p);
visit(p);
if (p->lchild != NULL )
EnQueue(&Q, p->lchild);
if (p->rchild != NULL )
EnQueue(&Q, p->rchild);
}
return ;
}
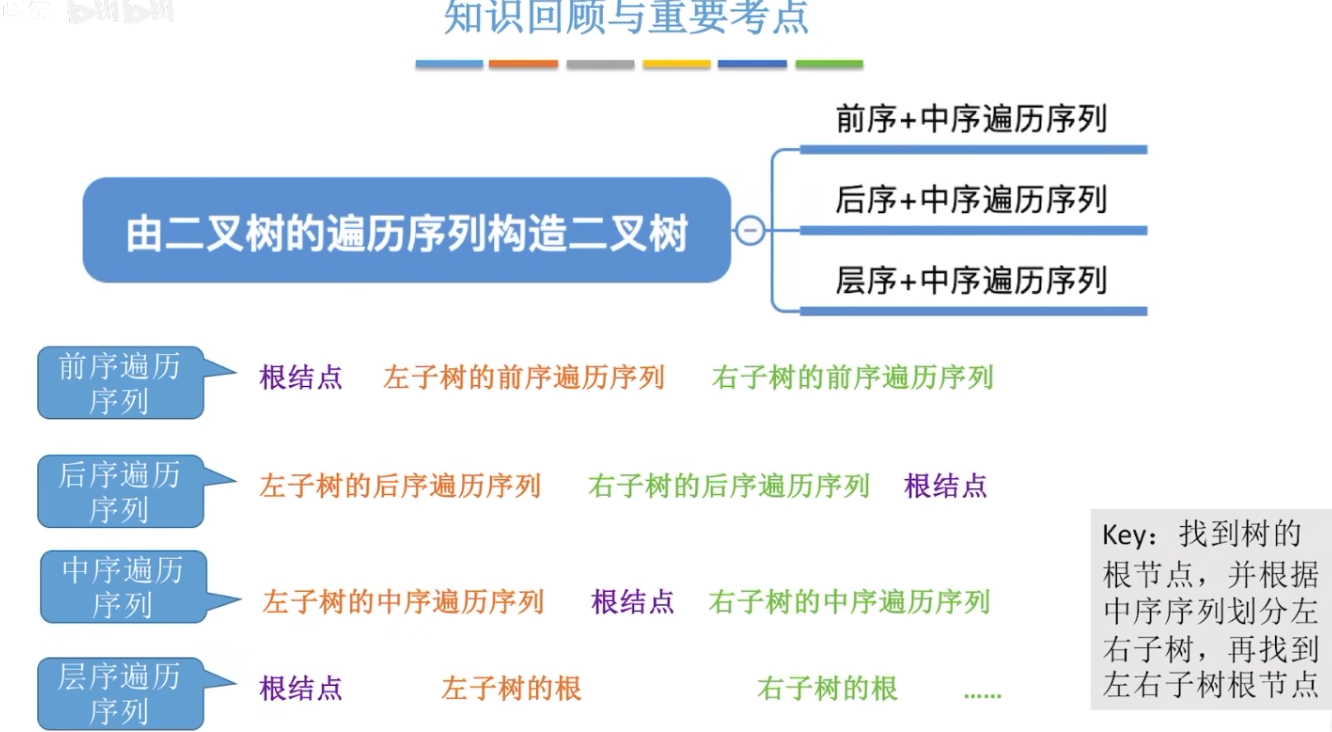
12-5、根据几种遍历序列重建二叉树
中序遍历序列和其他三种方式任意结合一种,都可以唯一确定一棵二叉树。
但是不用中序遍历,其他两种结合无法确定一棵二叉树。
12-6、线索二叉树
1
2
3
4
5
6
7
8
typede struct BiTNode {struct BiTNode *lchild , *rchild ;int ltag, rtag;
}BiTNode, *BiTree;
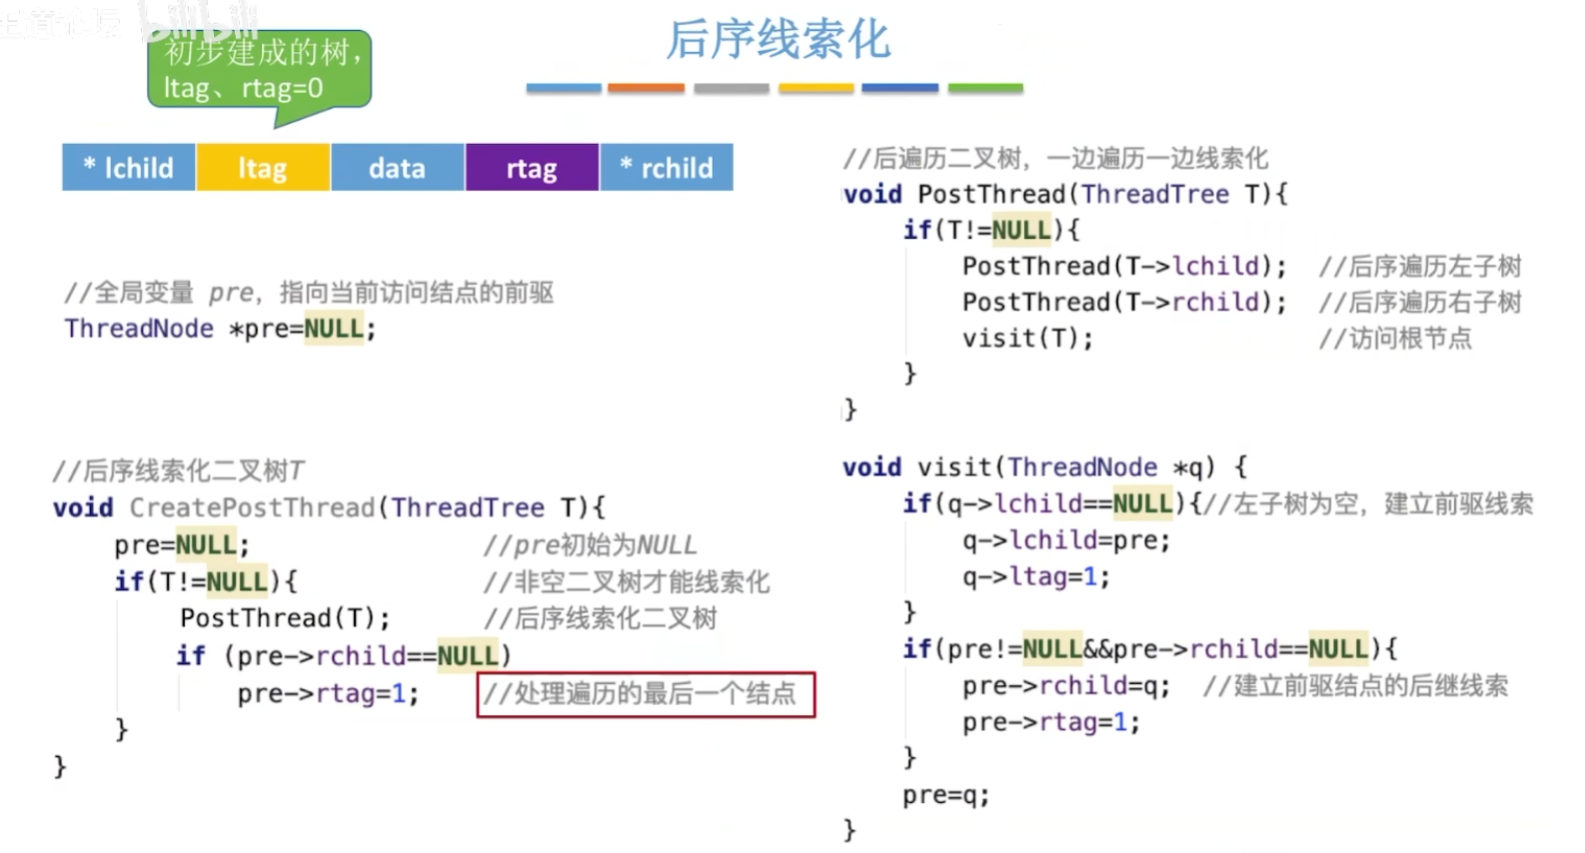
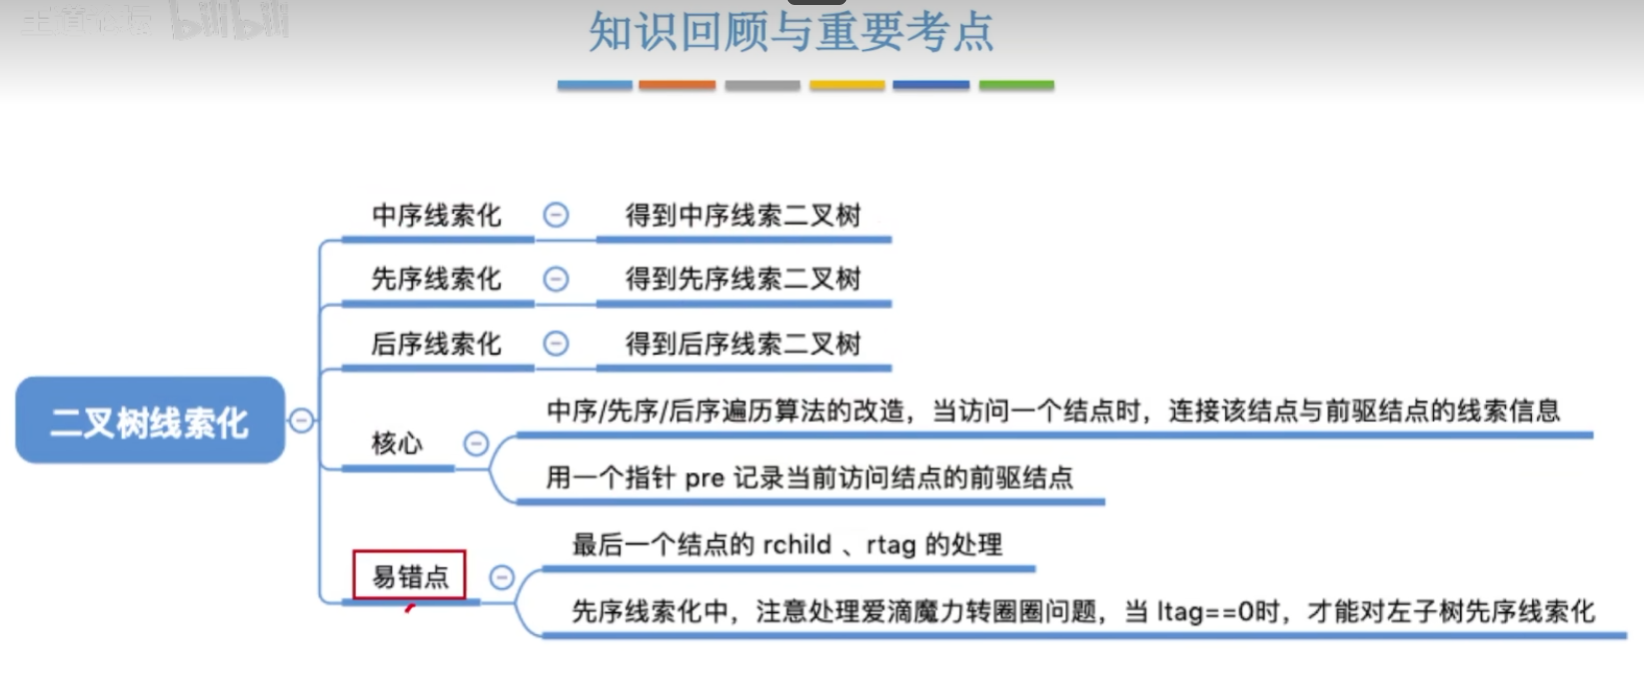
12-7、二叉树线索化,对visit函数进行实现
中序线索化完整代码如下:
先序线索化代码:
后续线索化代码:
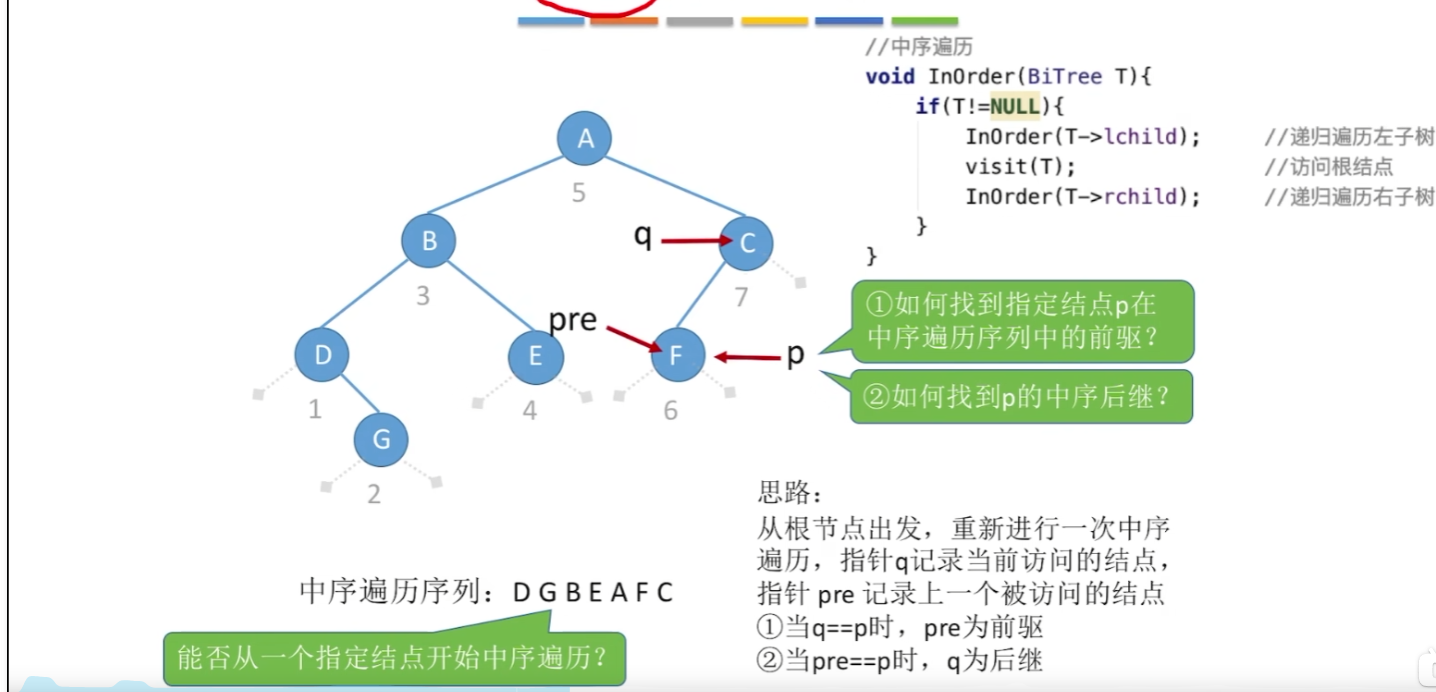
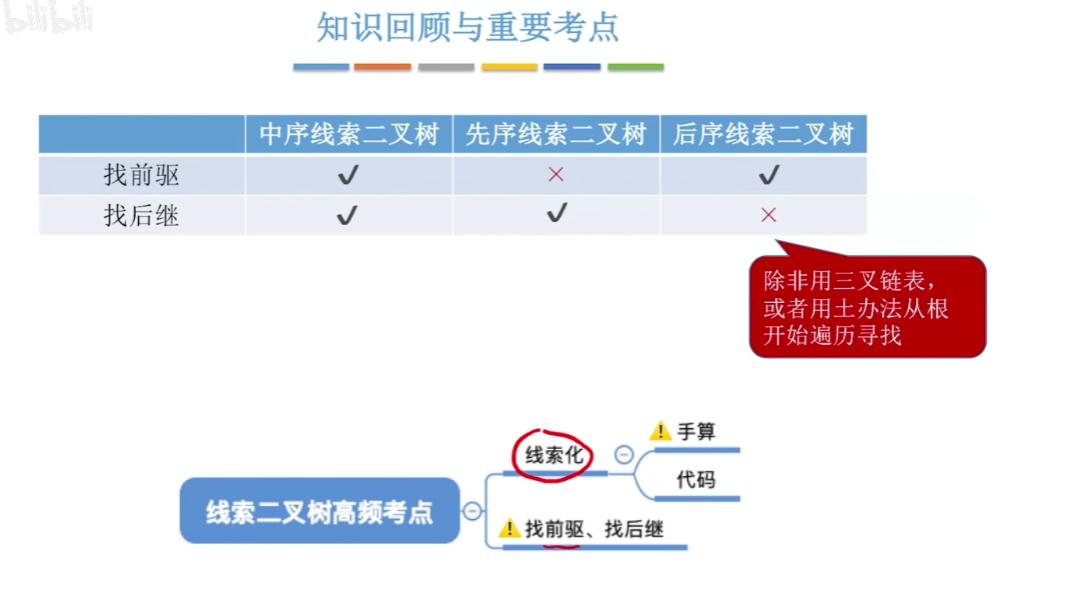
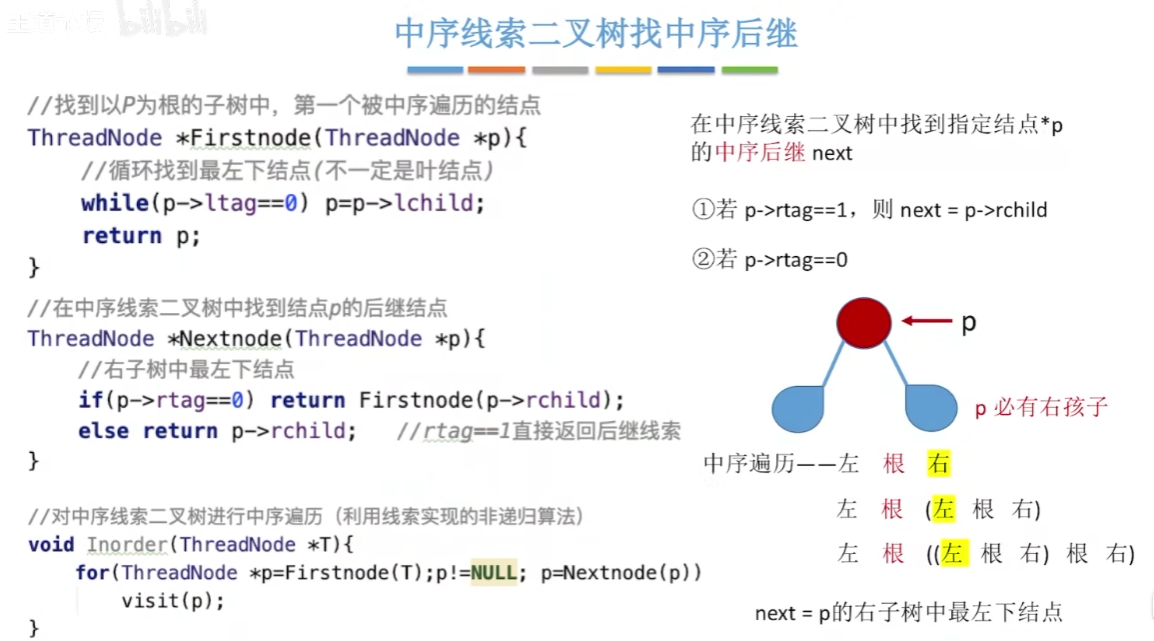
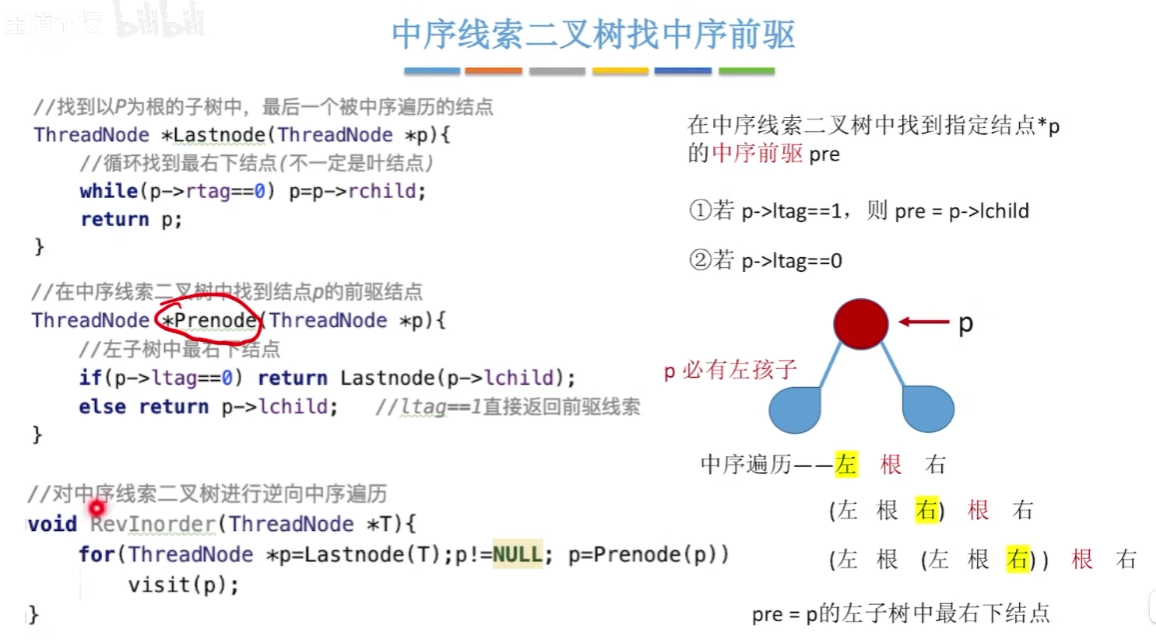
12-8、二叉树中序找后继和前驱
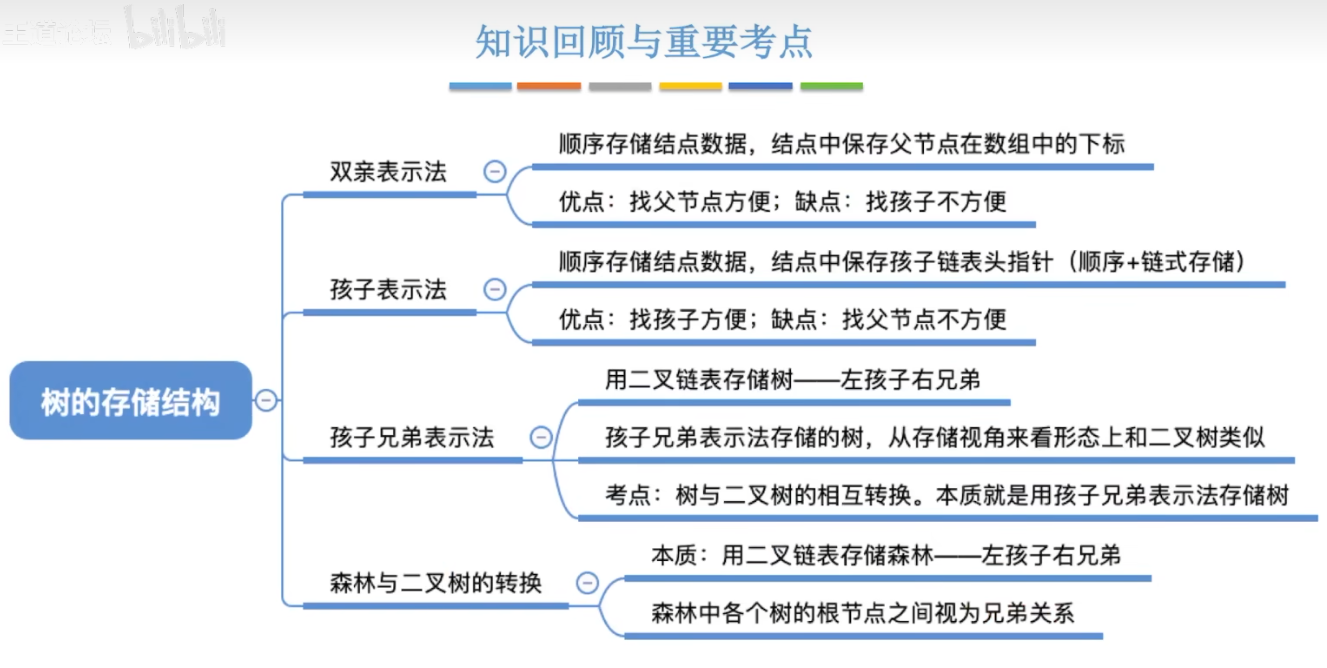
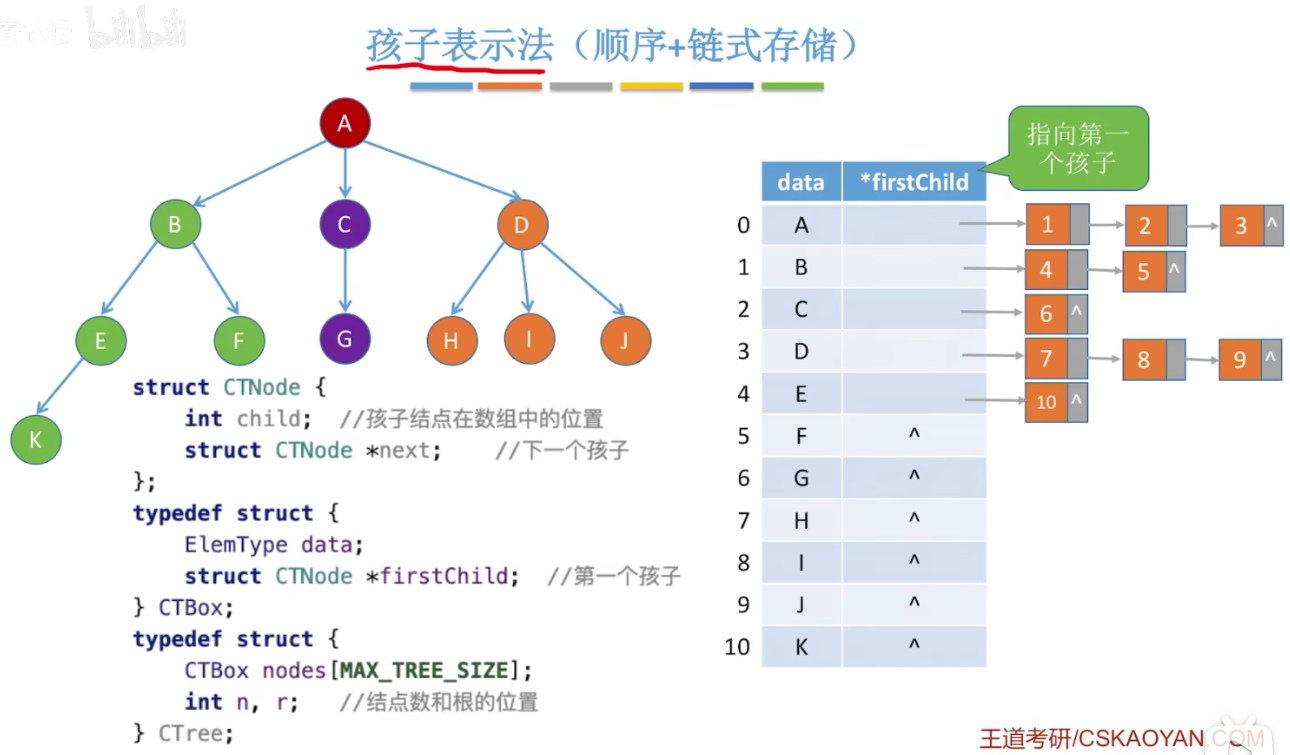
12-9、树的存储
其他树:
孩子表示法:顺序+链式存储:
兄弟孩子表示法:链式存储:
12-10、树的遍历
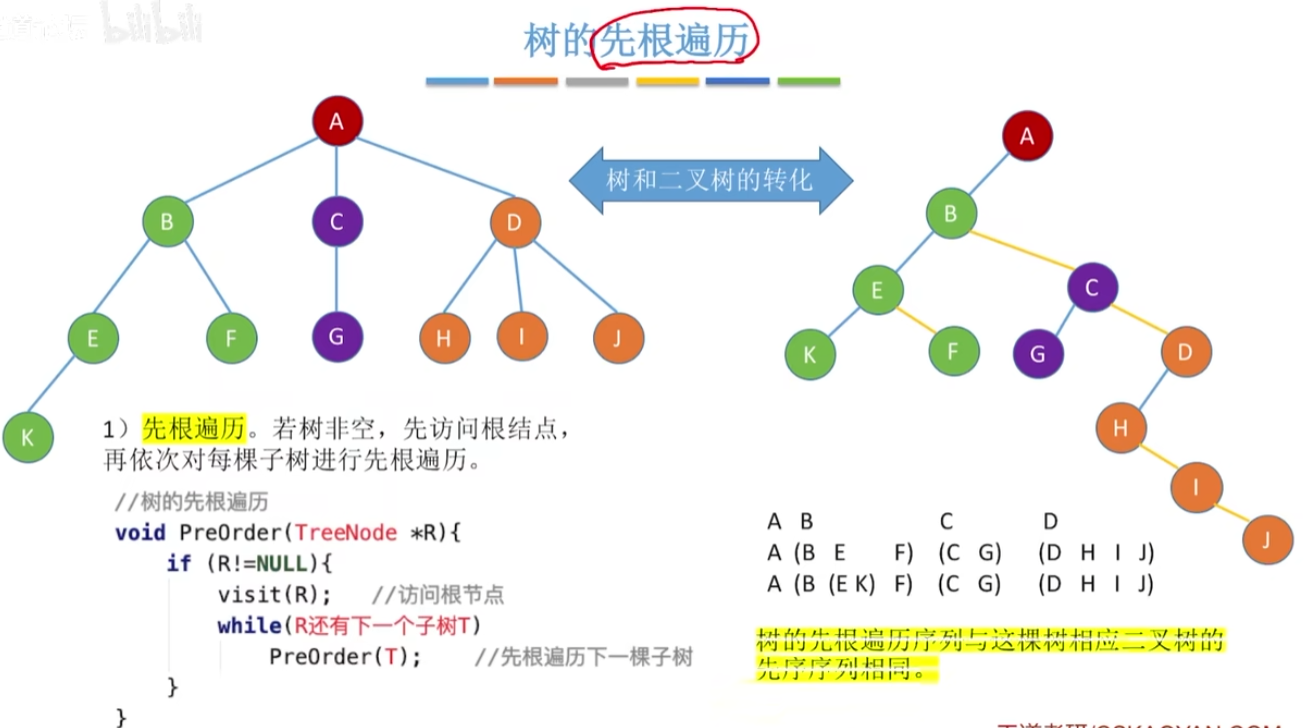
树的先根遍历,实现后达到树和二叉树的转化:
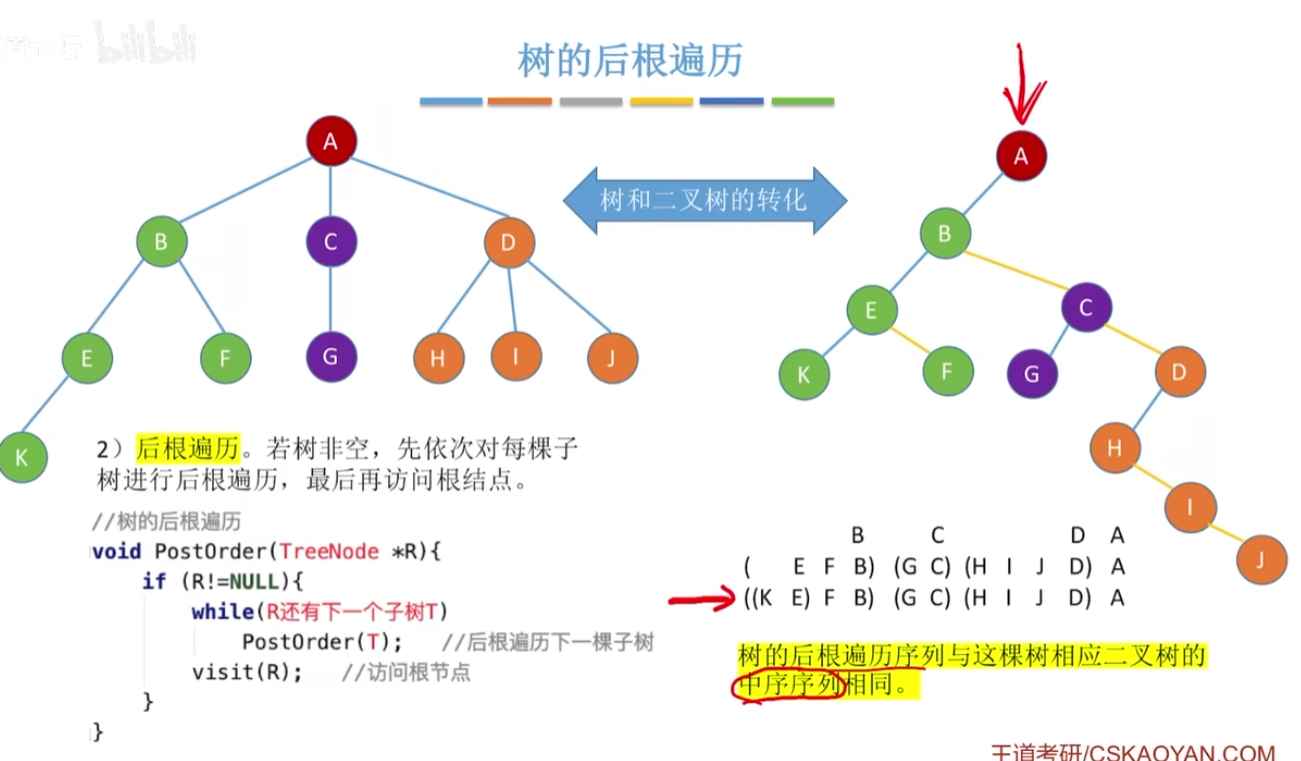
树的后续遍历,实现二叉树和树的转化:
树的层序遍历:
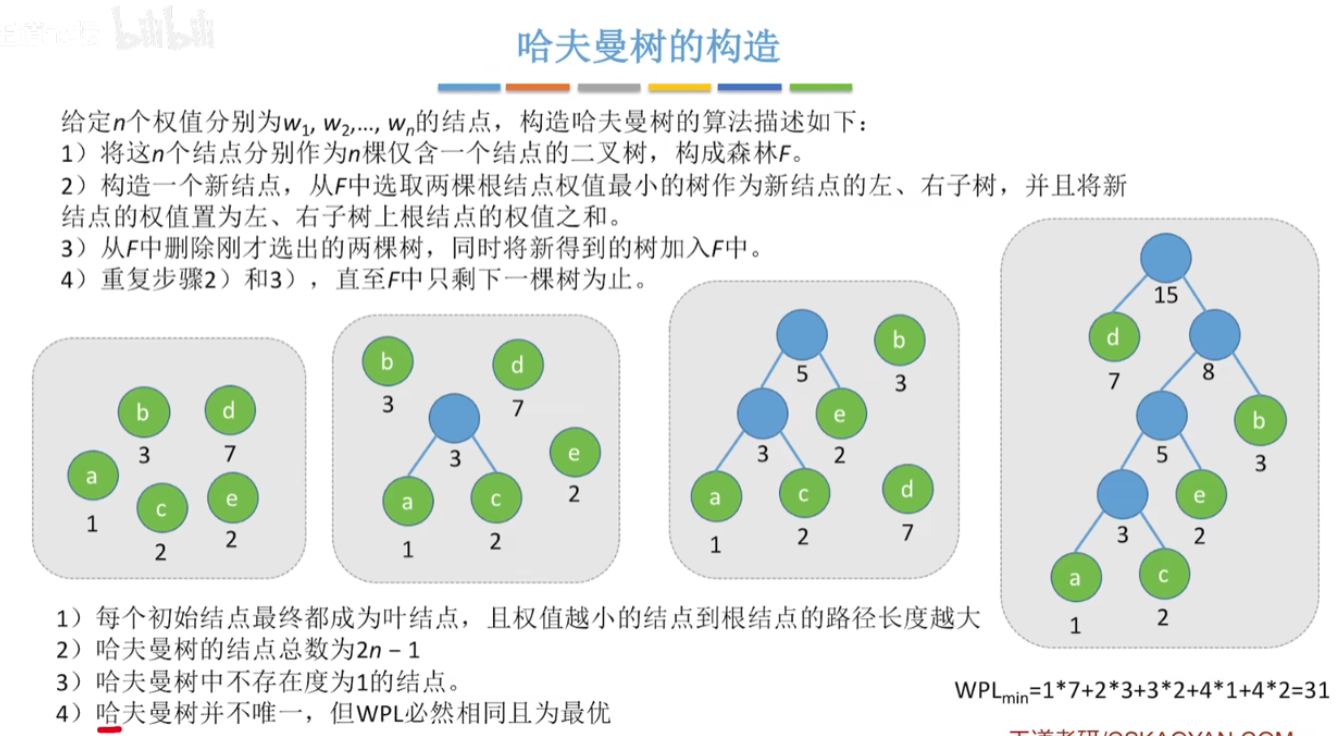
12-11、哈夫曼树
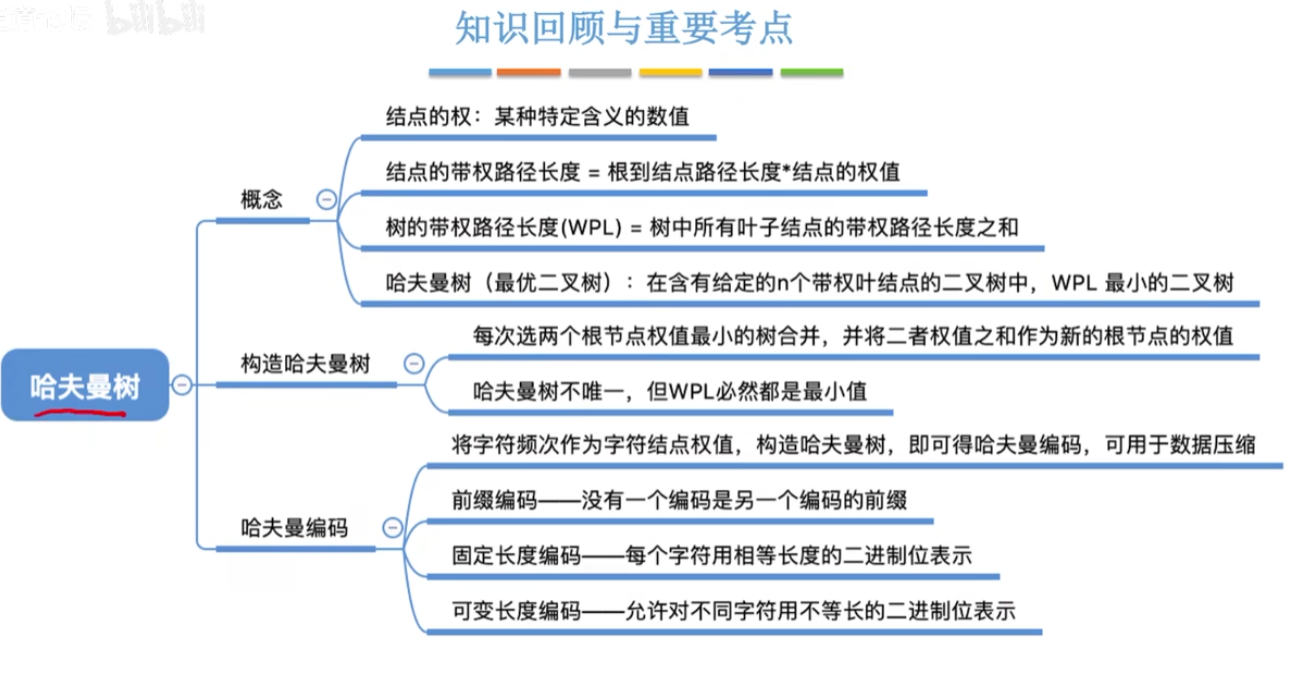
节点的权:节点上数据所表示的某种信息量。
节点的带权路径长度:从根节点到该节点的路径长度与该节点上数据的乘积。
哈夫曼树:带权路径长度最小的二叉树。也称为最优二叉树。
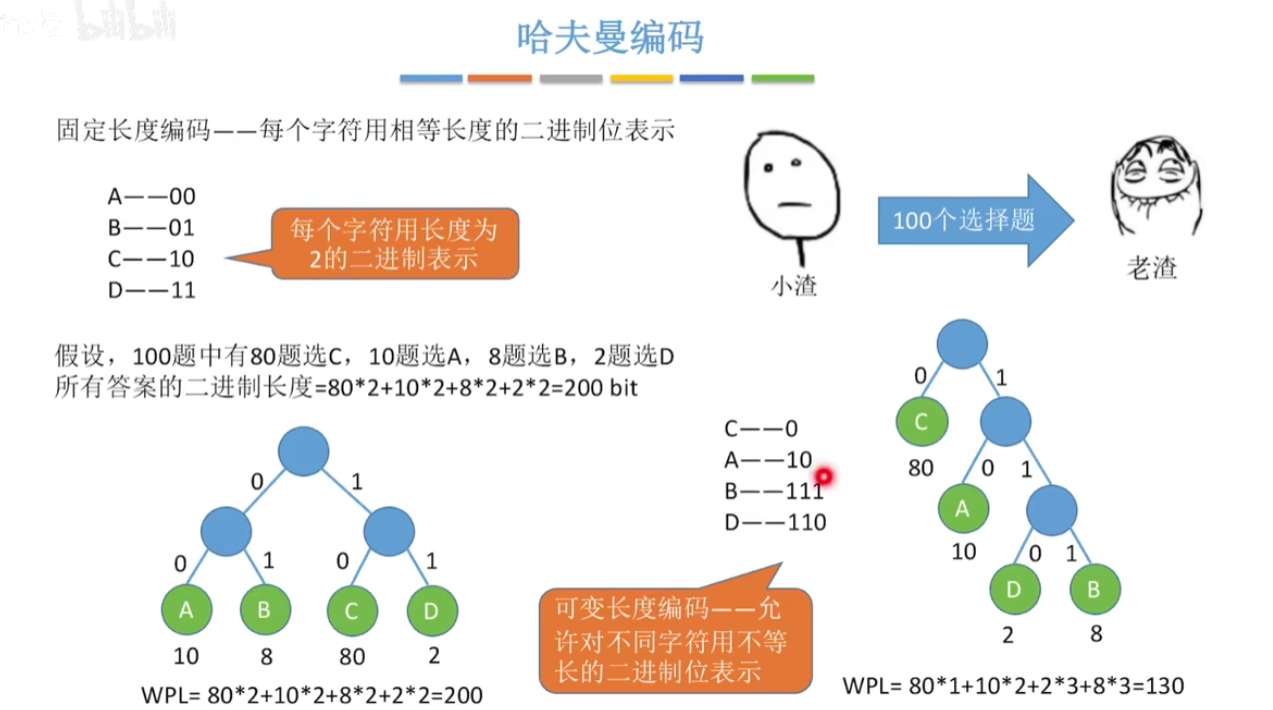
应用:哈夫曼编码。(可变长度编码)
一般的ascii码是定长编码,一个字节8位。
哈夫曼编码:将字符按照出现频率从高到低排序,然后两两合并,合并后字符频率和合并前字符频率之和就是合并后字符频率。
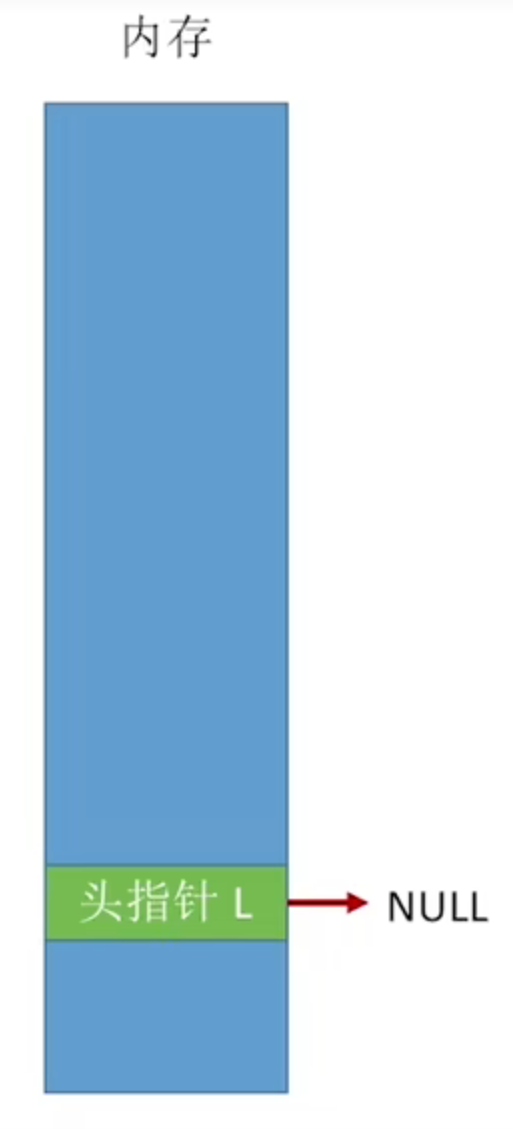
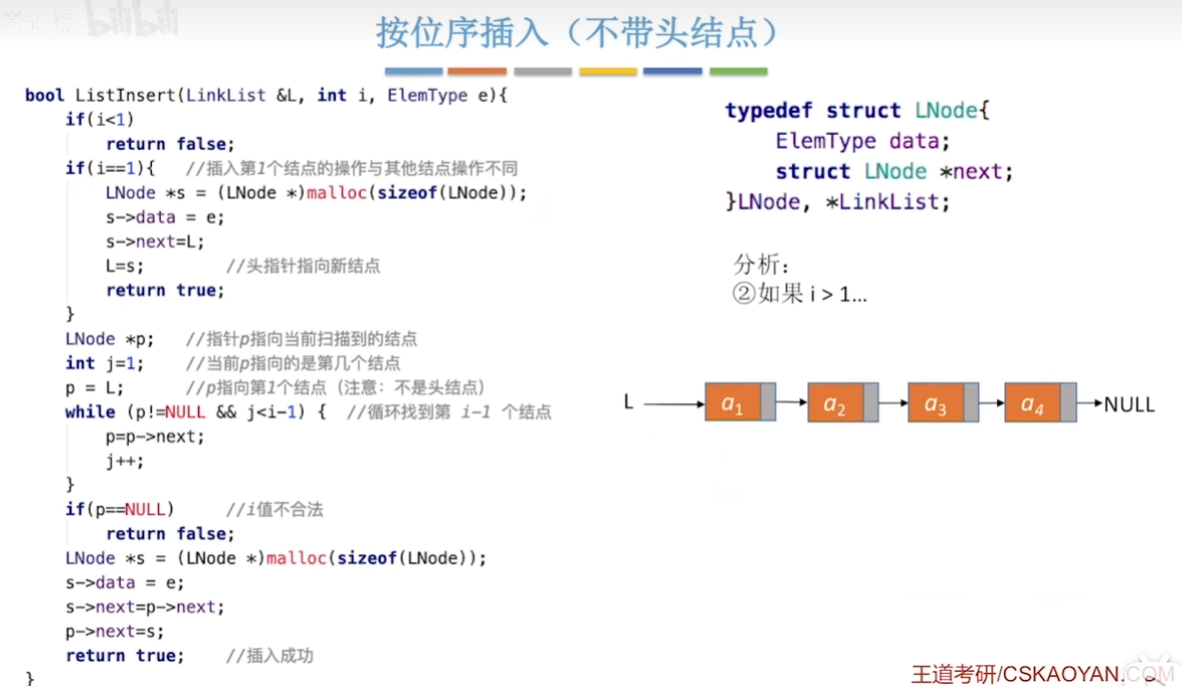
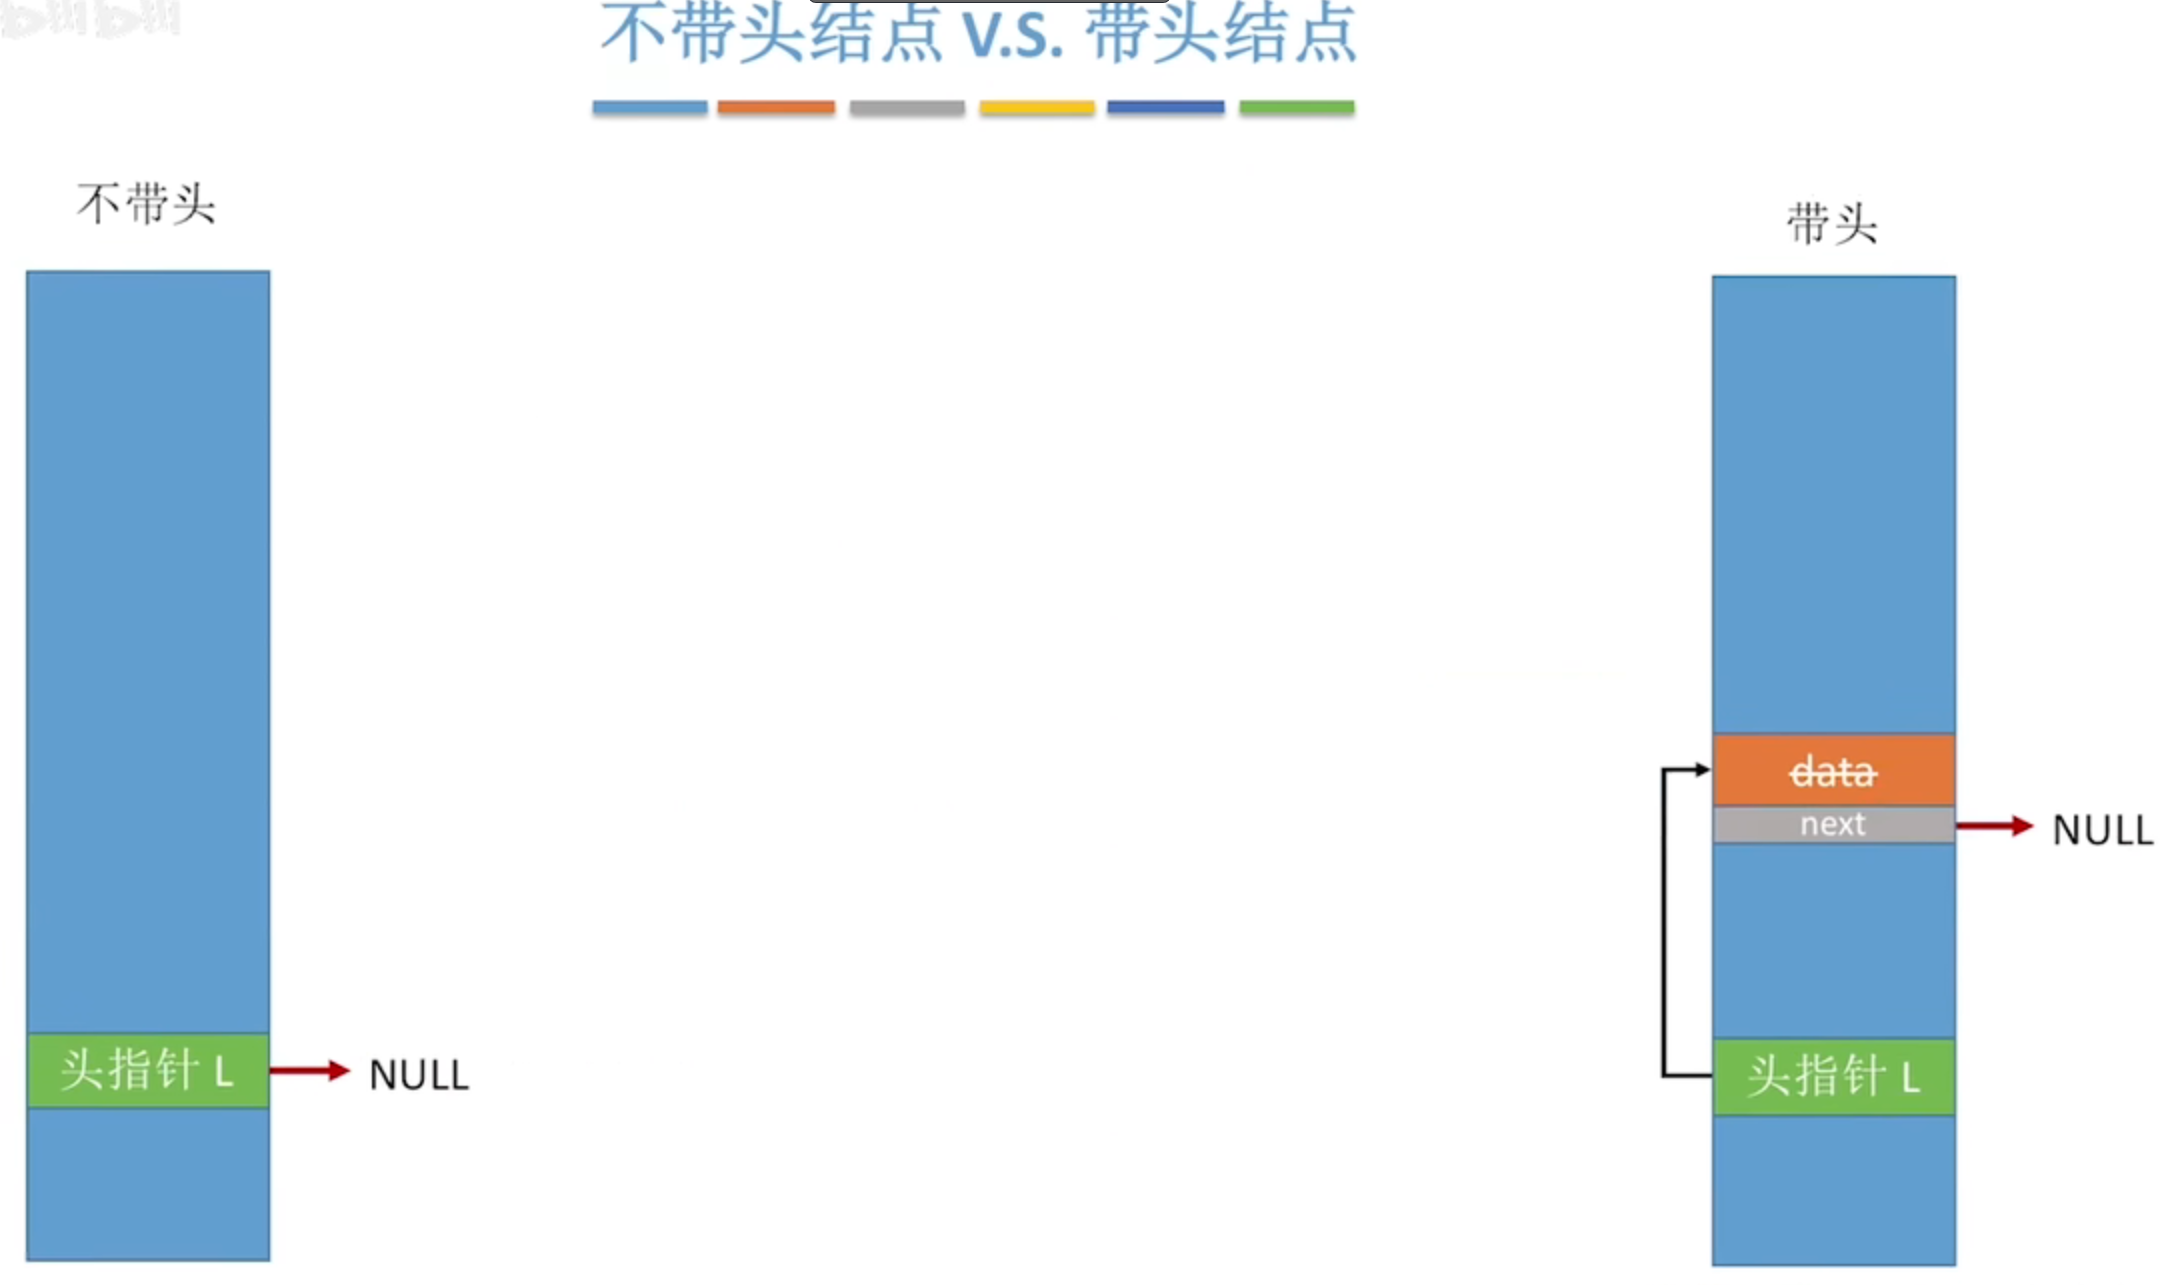 链表不带头节点,操作比较麻烦。
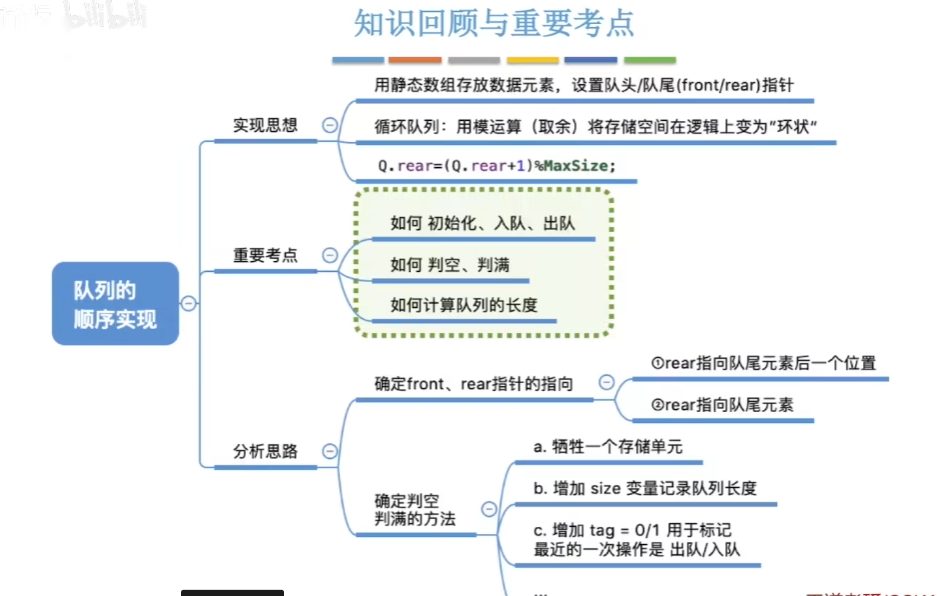 队列:只允许在一端进行插入,在另一端删除的线性表,先进先出FIFO(First In First Out)
术语:队头head和队尾tail,空队列:head == tail
基本操作:
1、初始化:分配栈空间
2、销毁:释放栈空间
3、入队:将元素压入队尾
4、出队:将元素从队首弹出
5、读队首:读队首元素
6、判空:判断栈是否为空
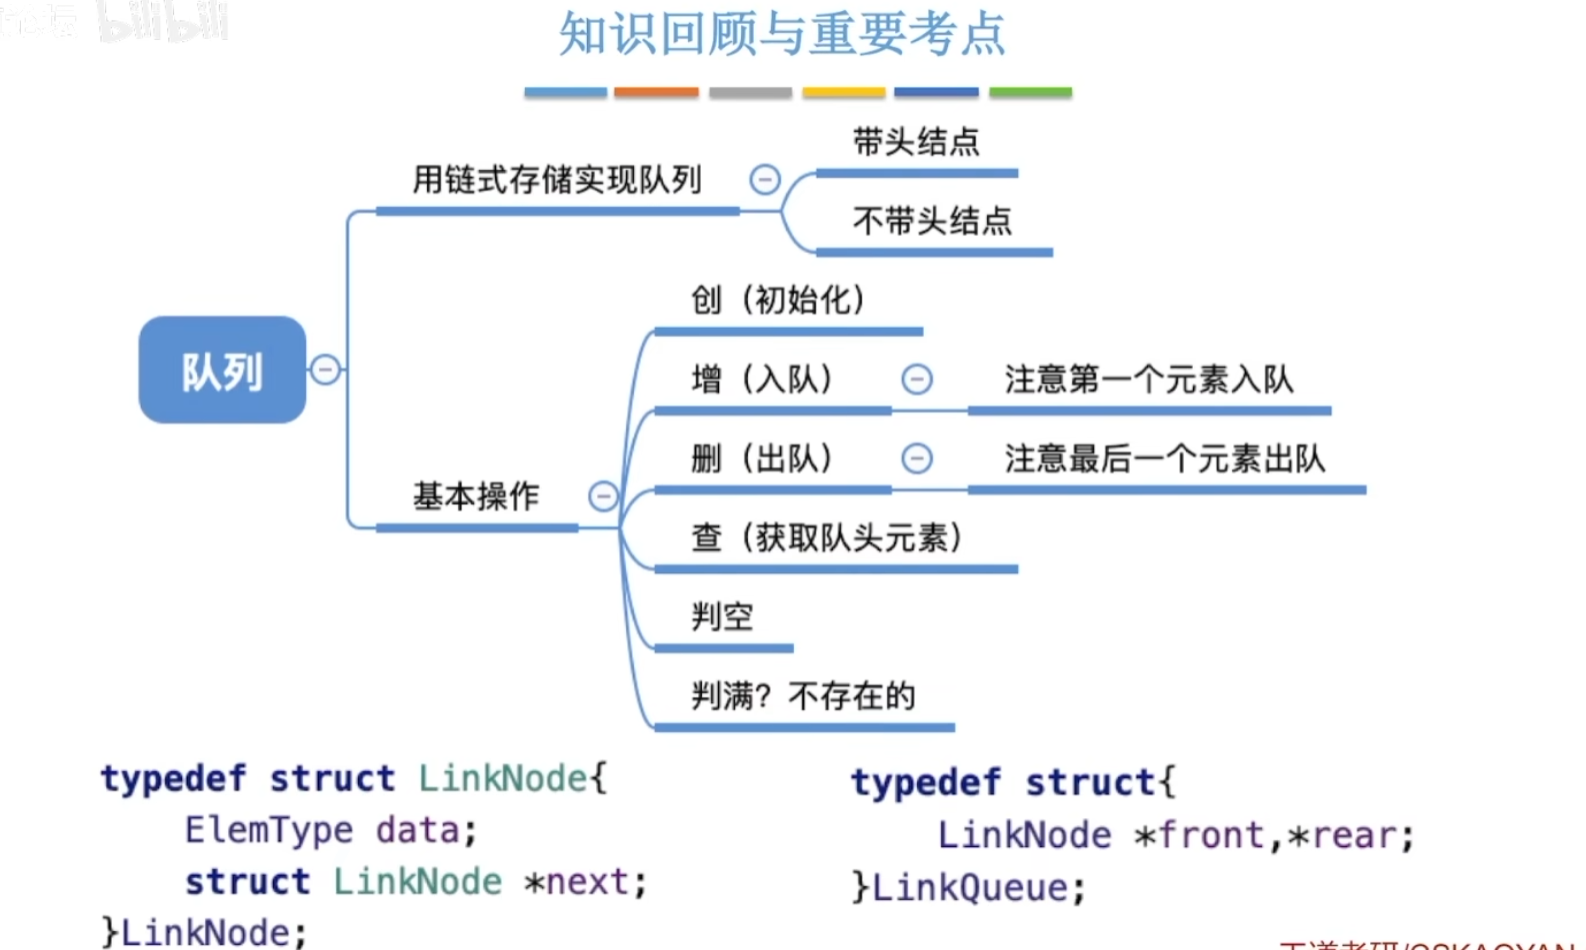 使用链表的一段进行插入,或者删除操作,实现栈操作。
回顾之前的链表,要标记一个链表,只需要保存链表的头指针就可以了。遍历,查询等,这个指针不要动。使用另一个指针,来遍历链表。
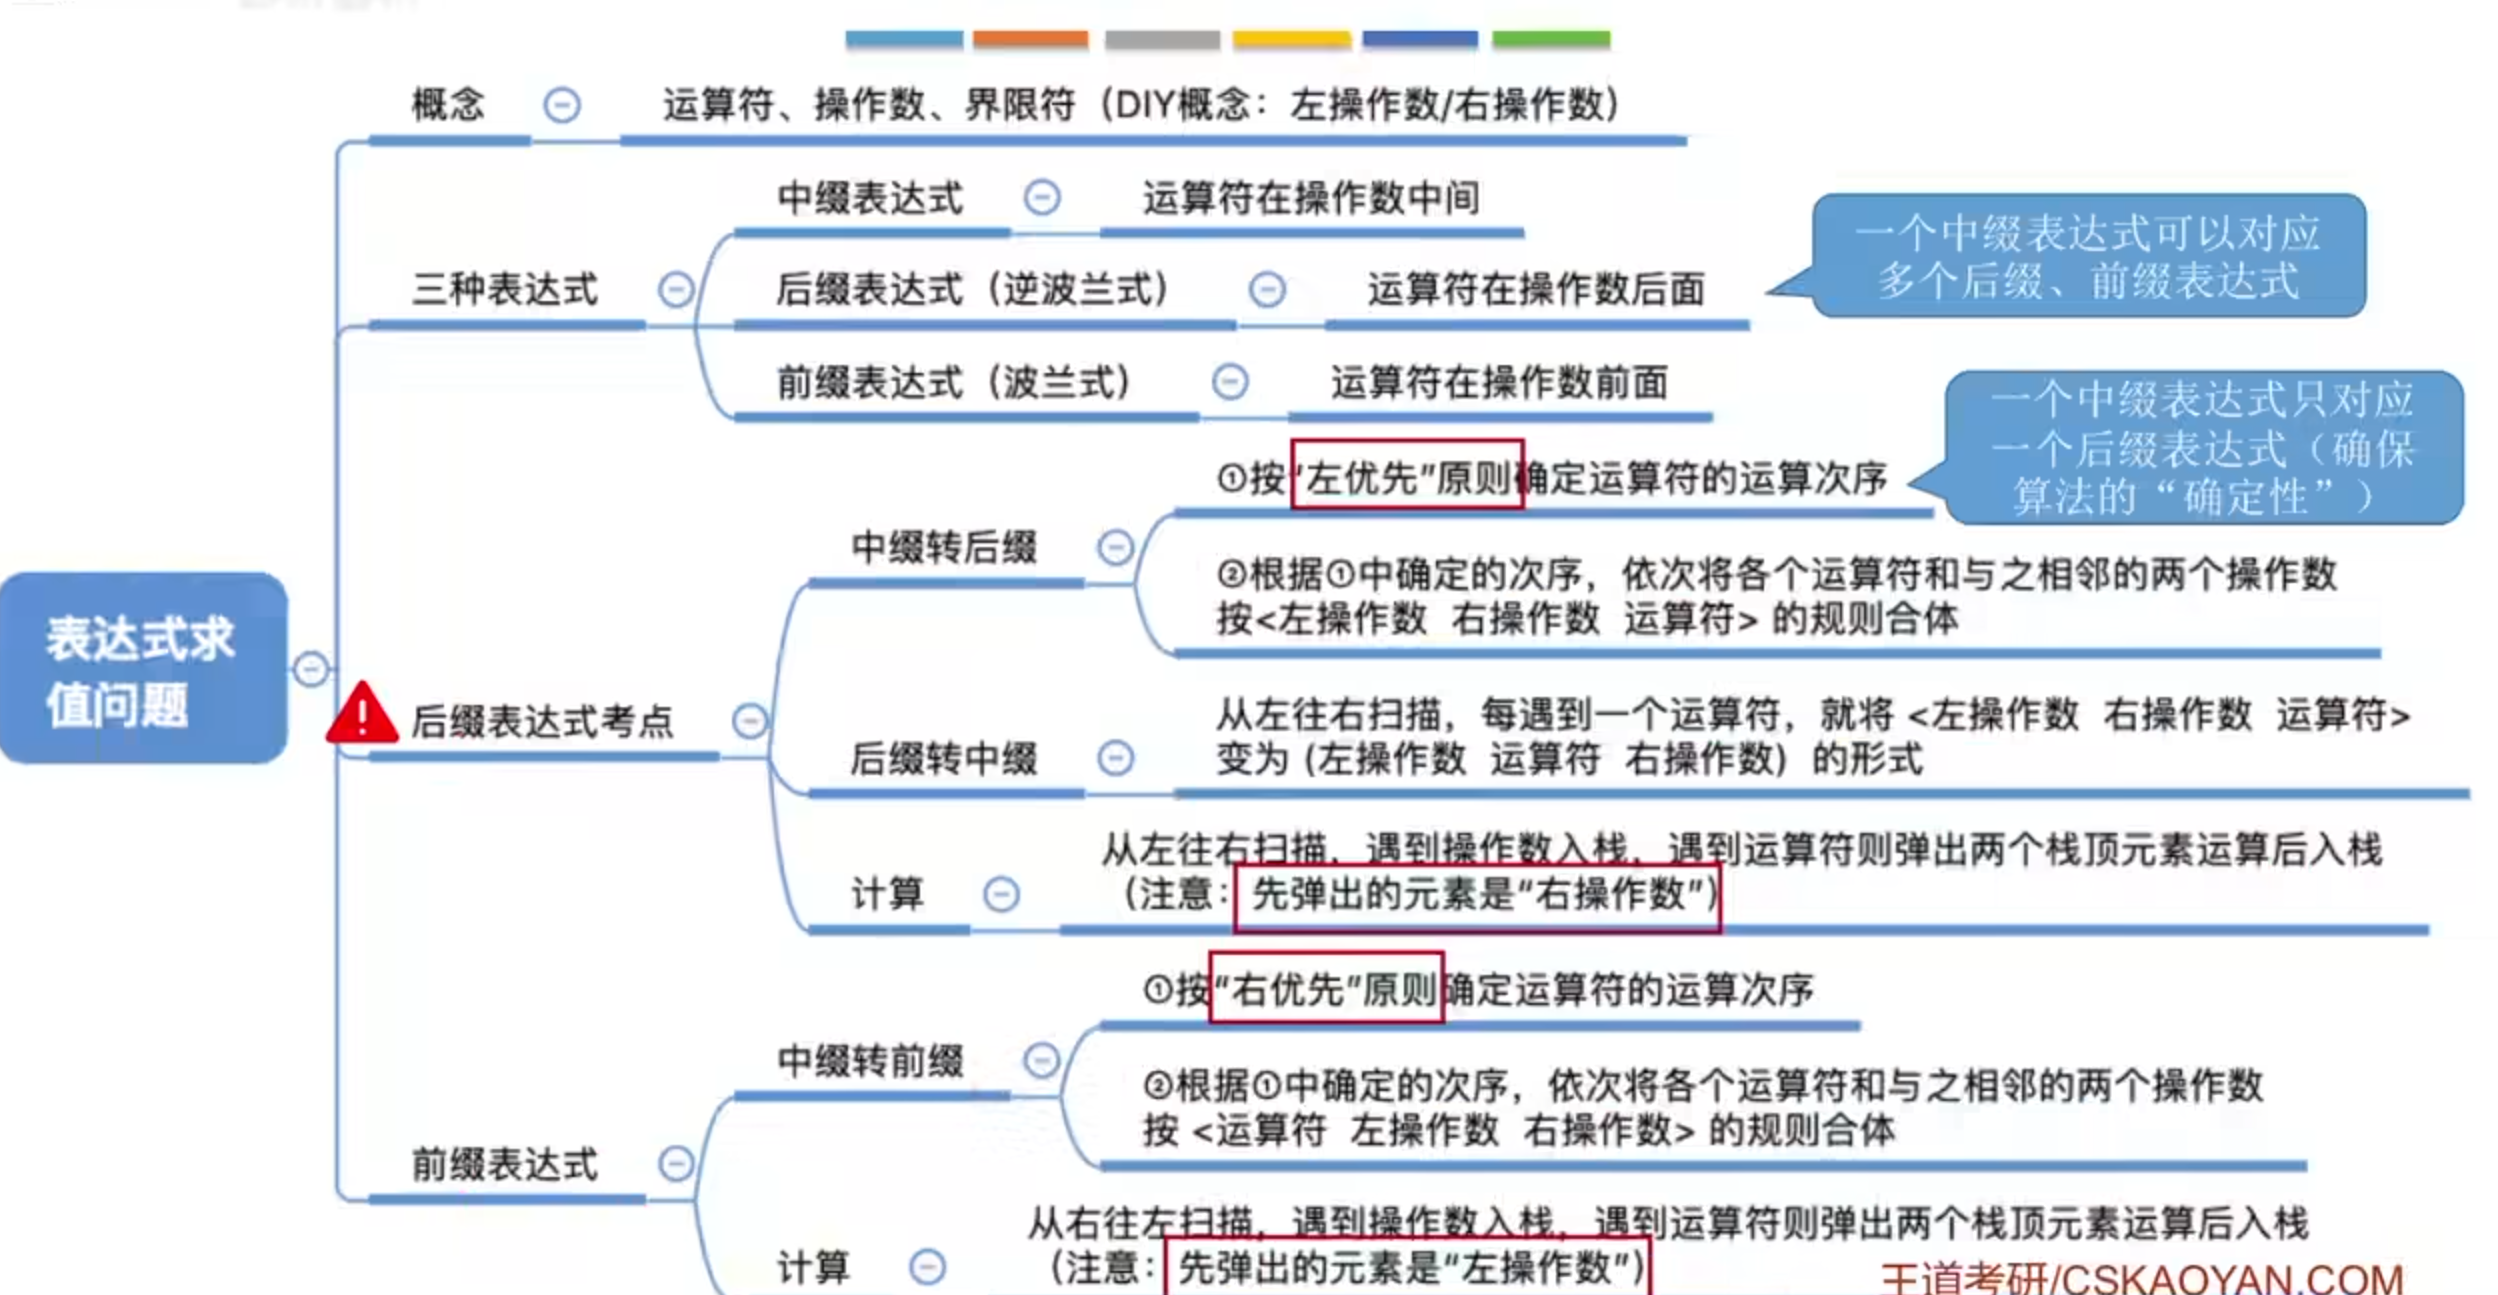
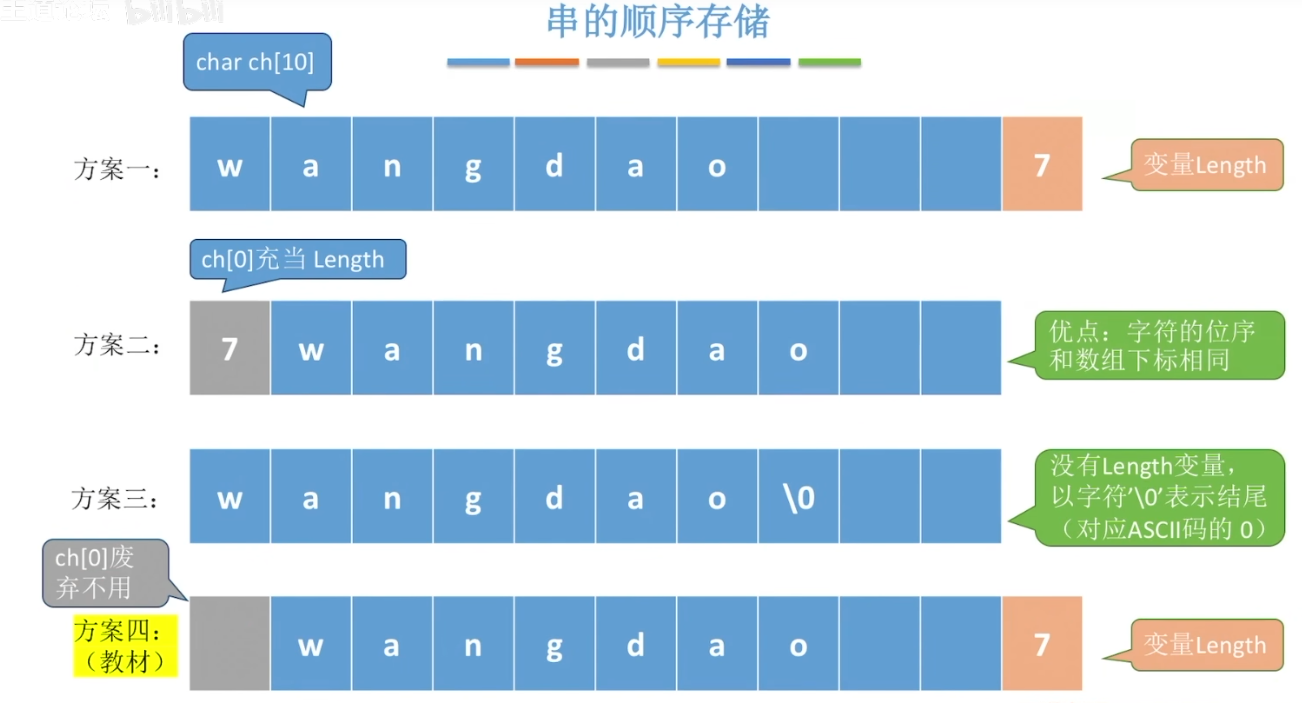 下面11-2采用第四种方法。
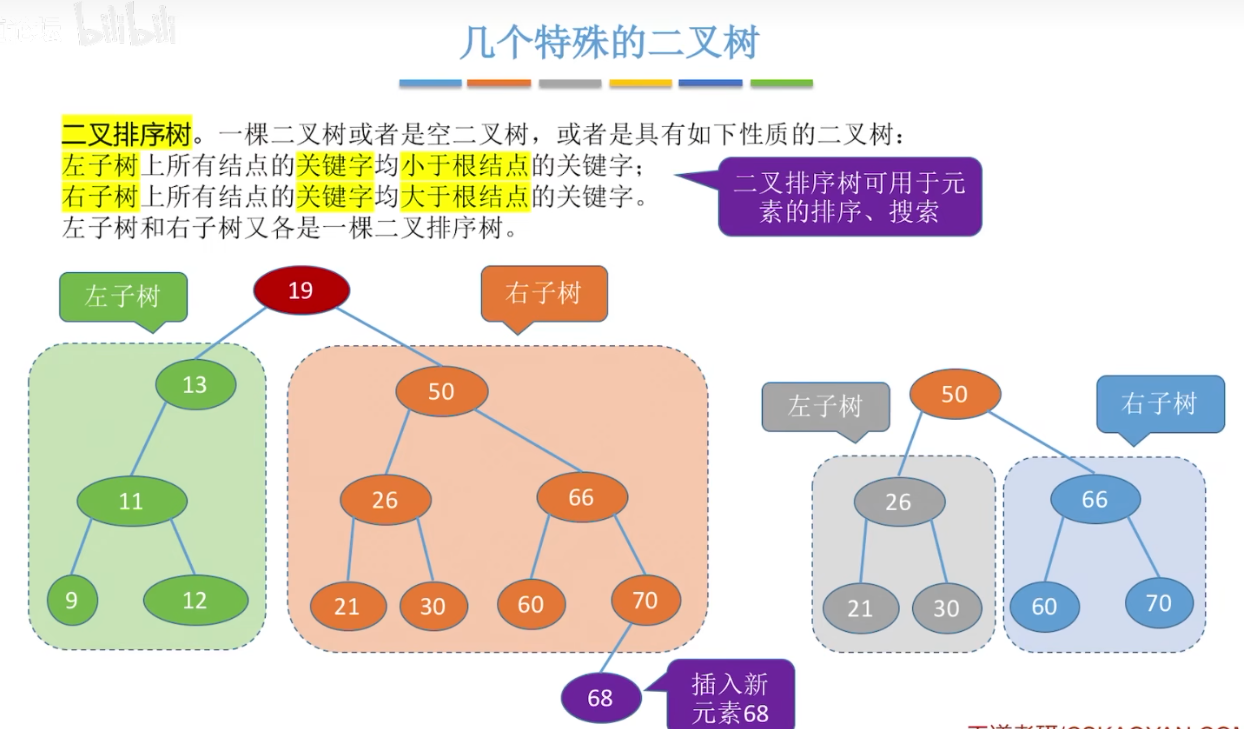 平衡二叉树:左右子树的高度差不超过1。效率很高
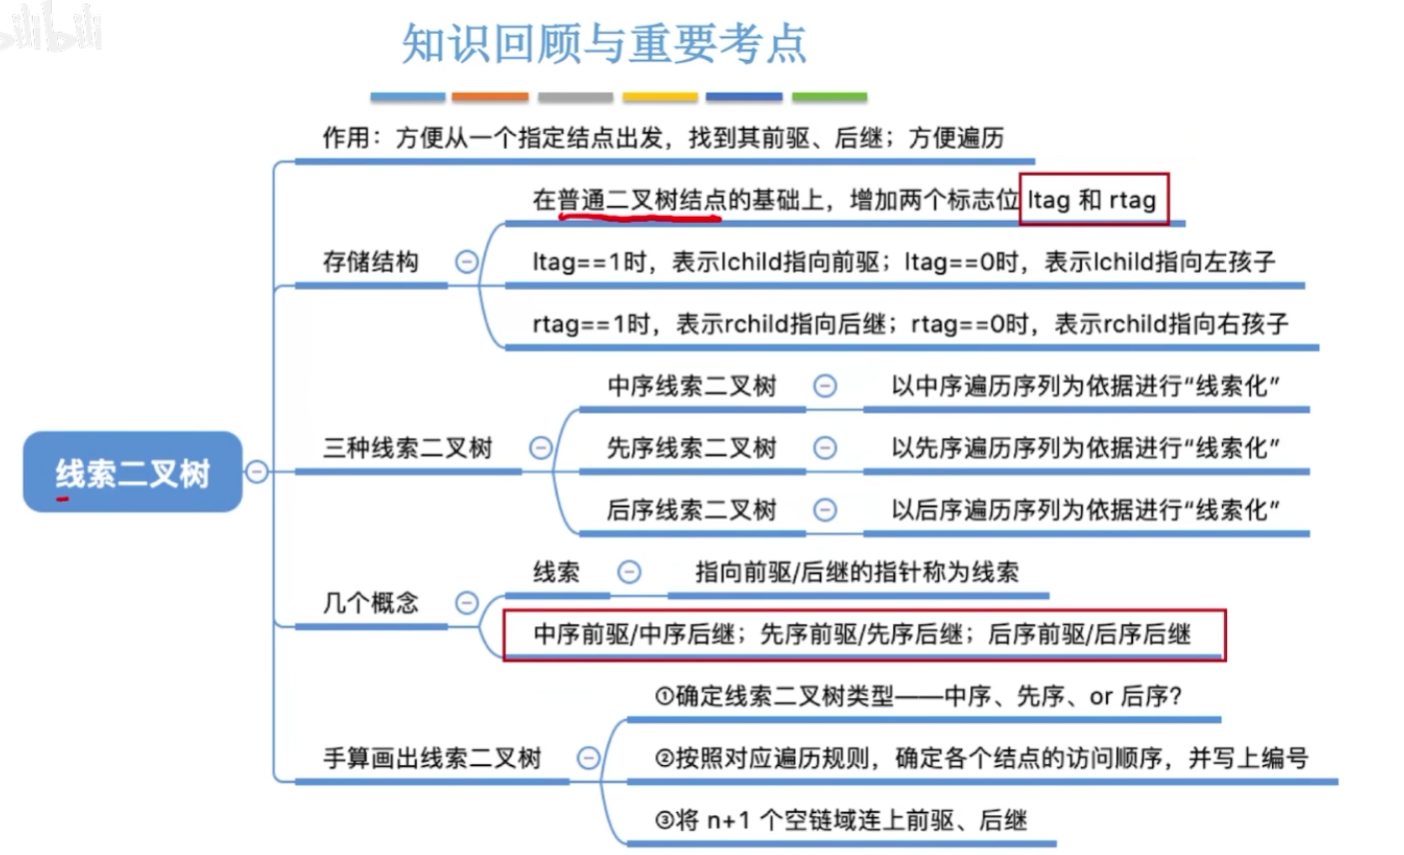 普通二叉树找前驱后继比较麻烦。
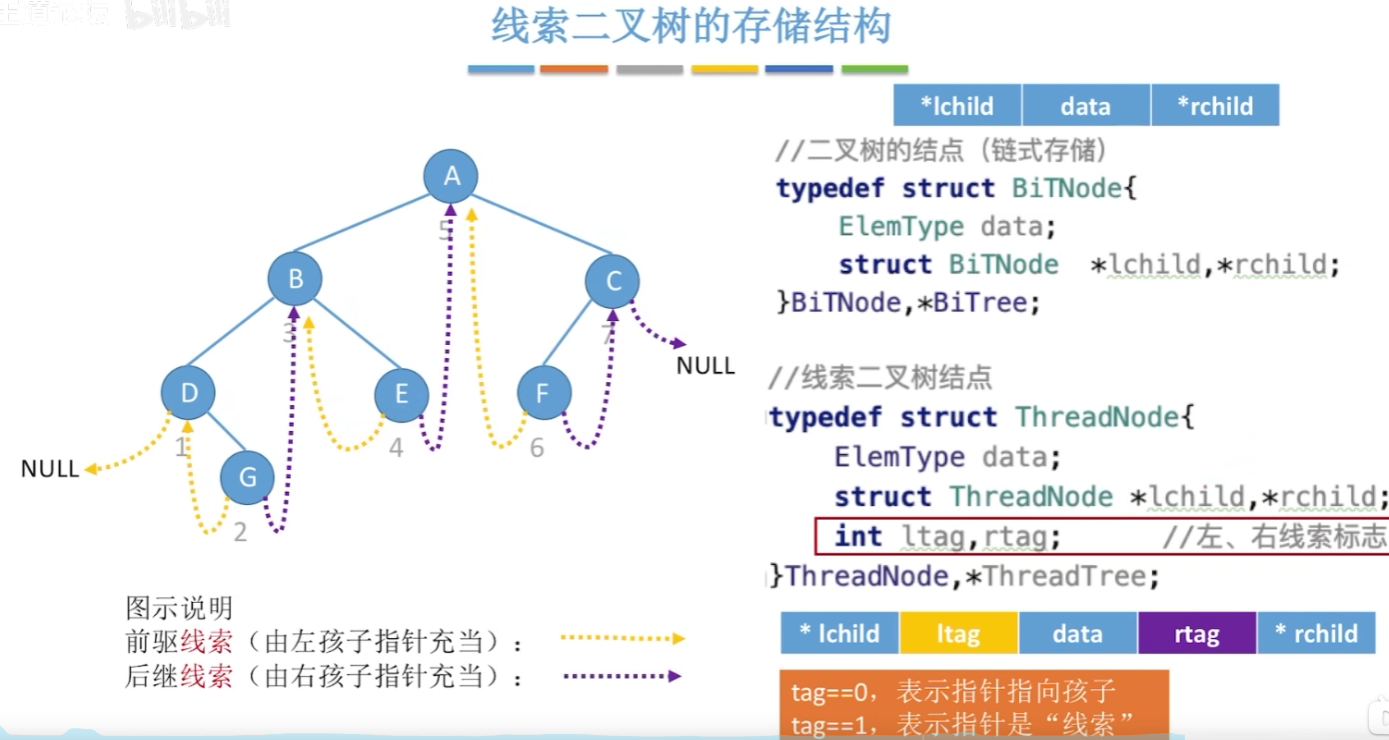
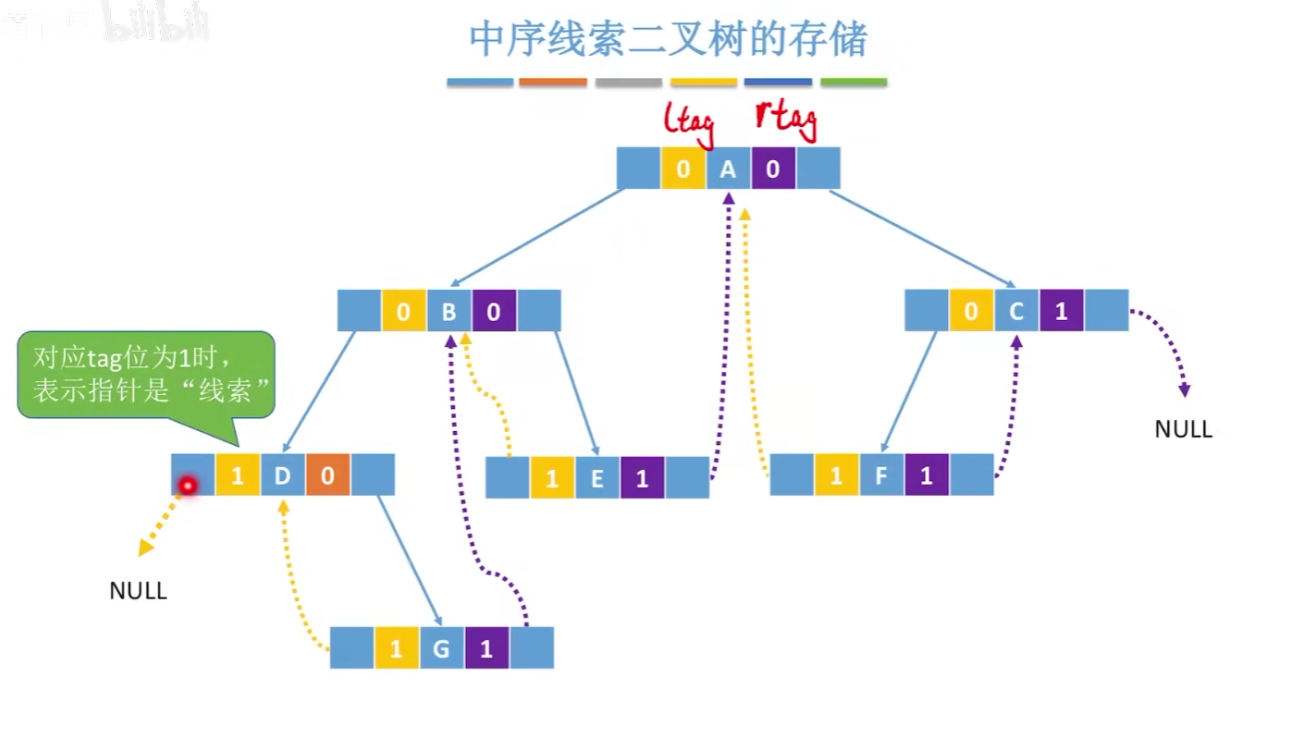
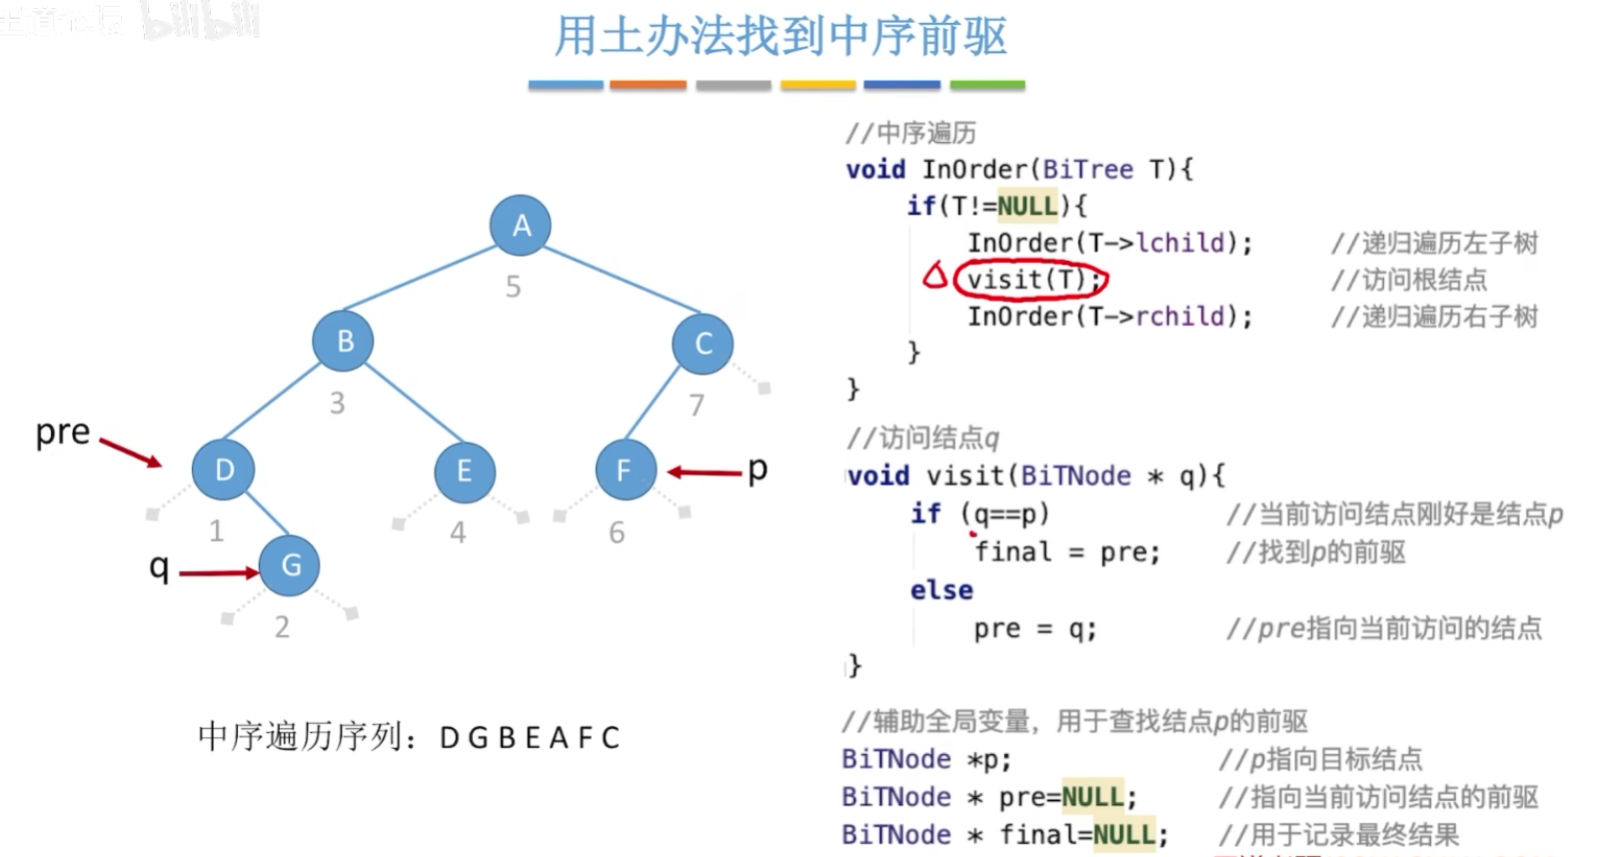 线索化先要对二叉树进行一次完整遍历。
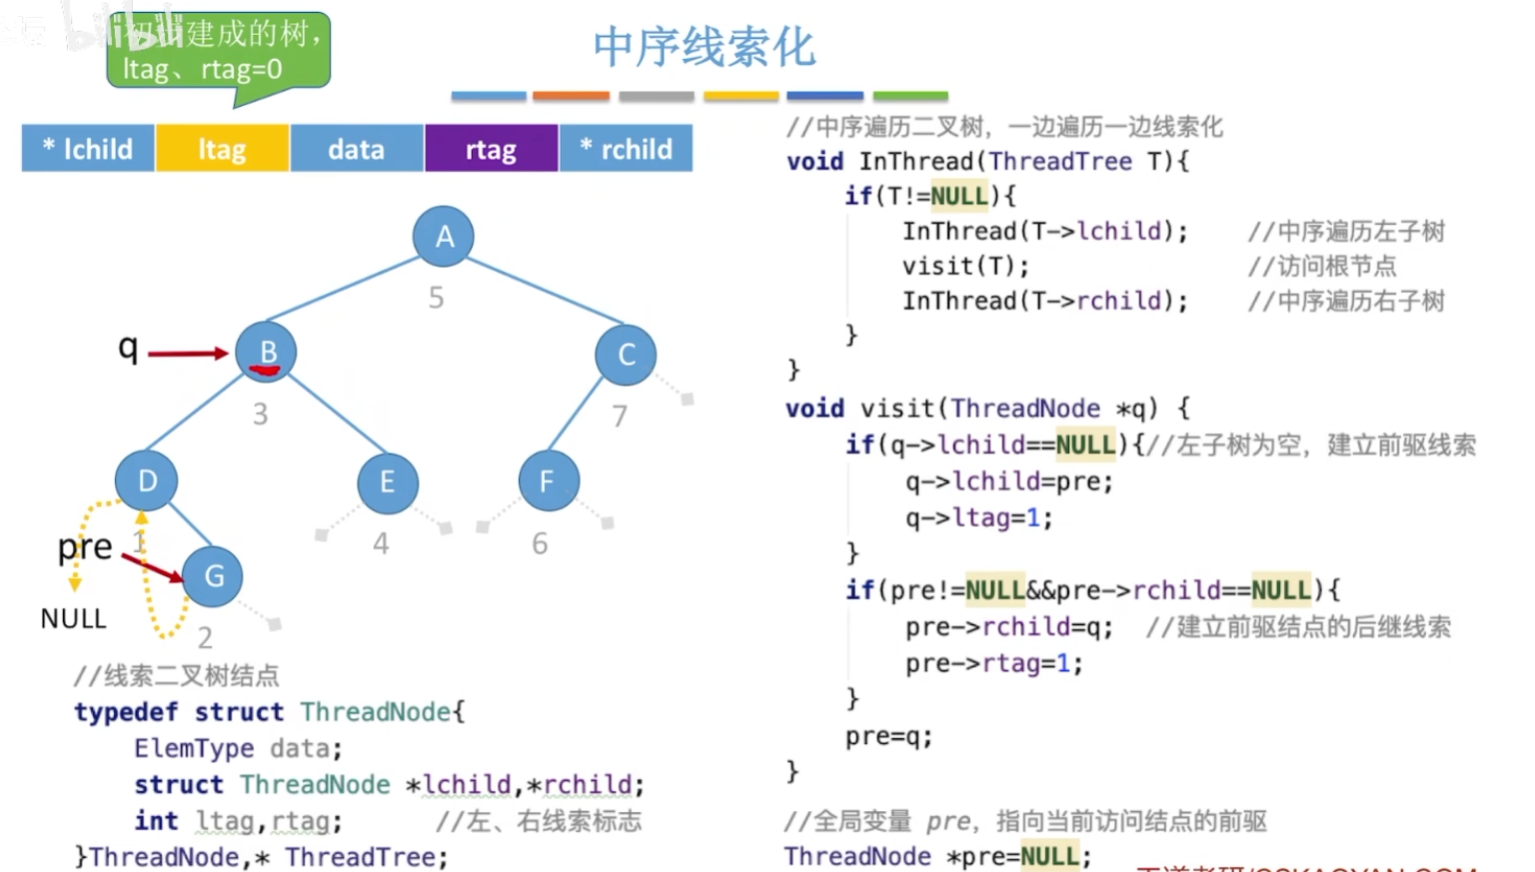
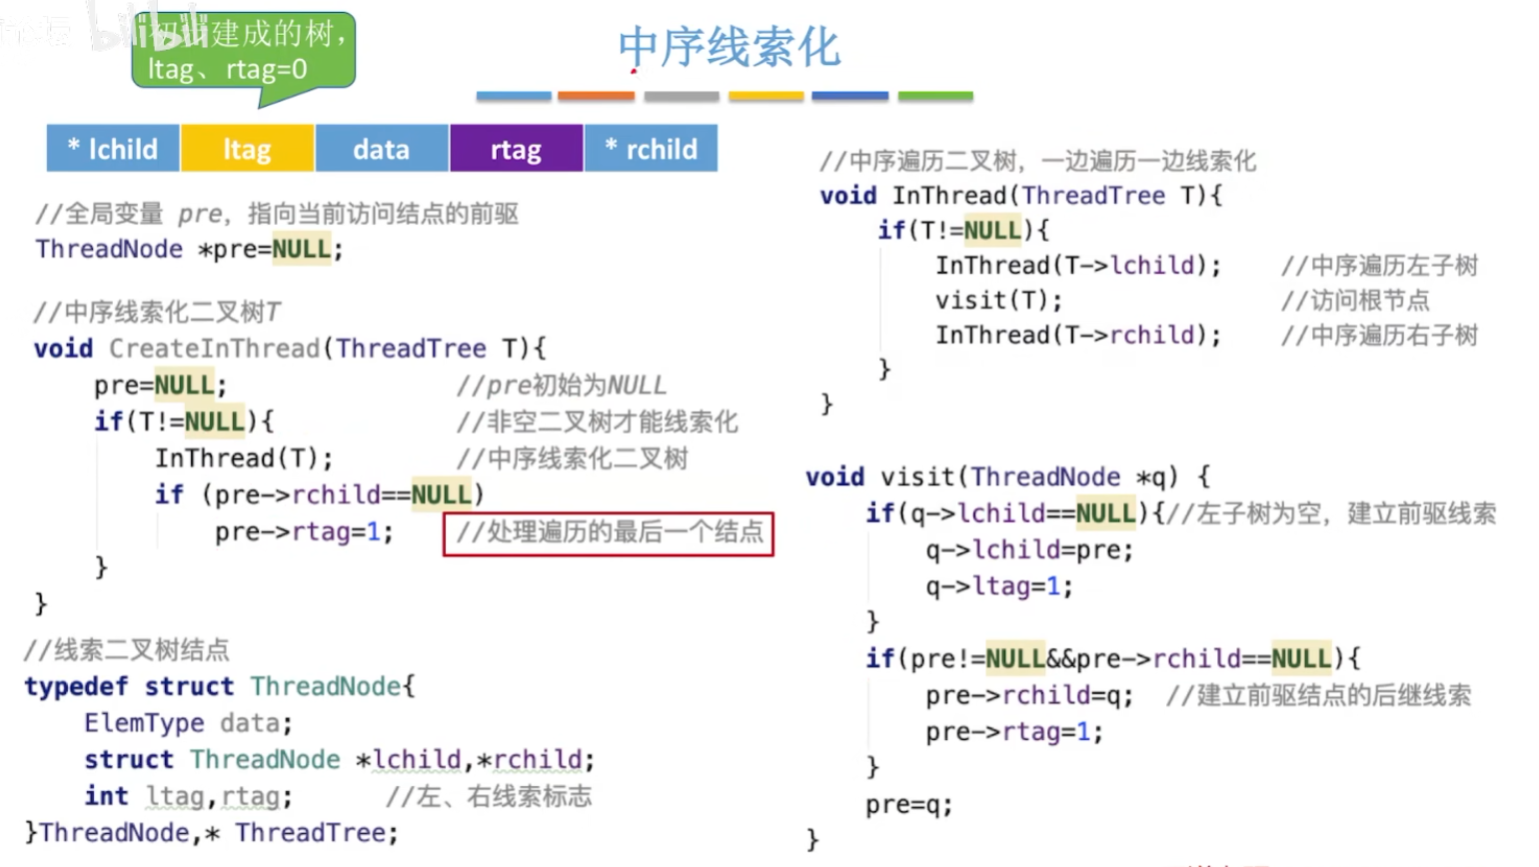
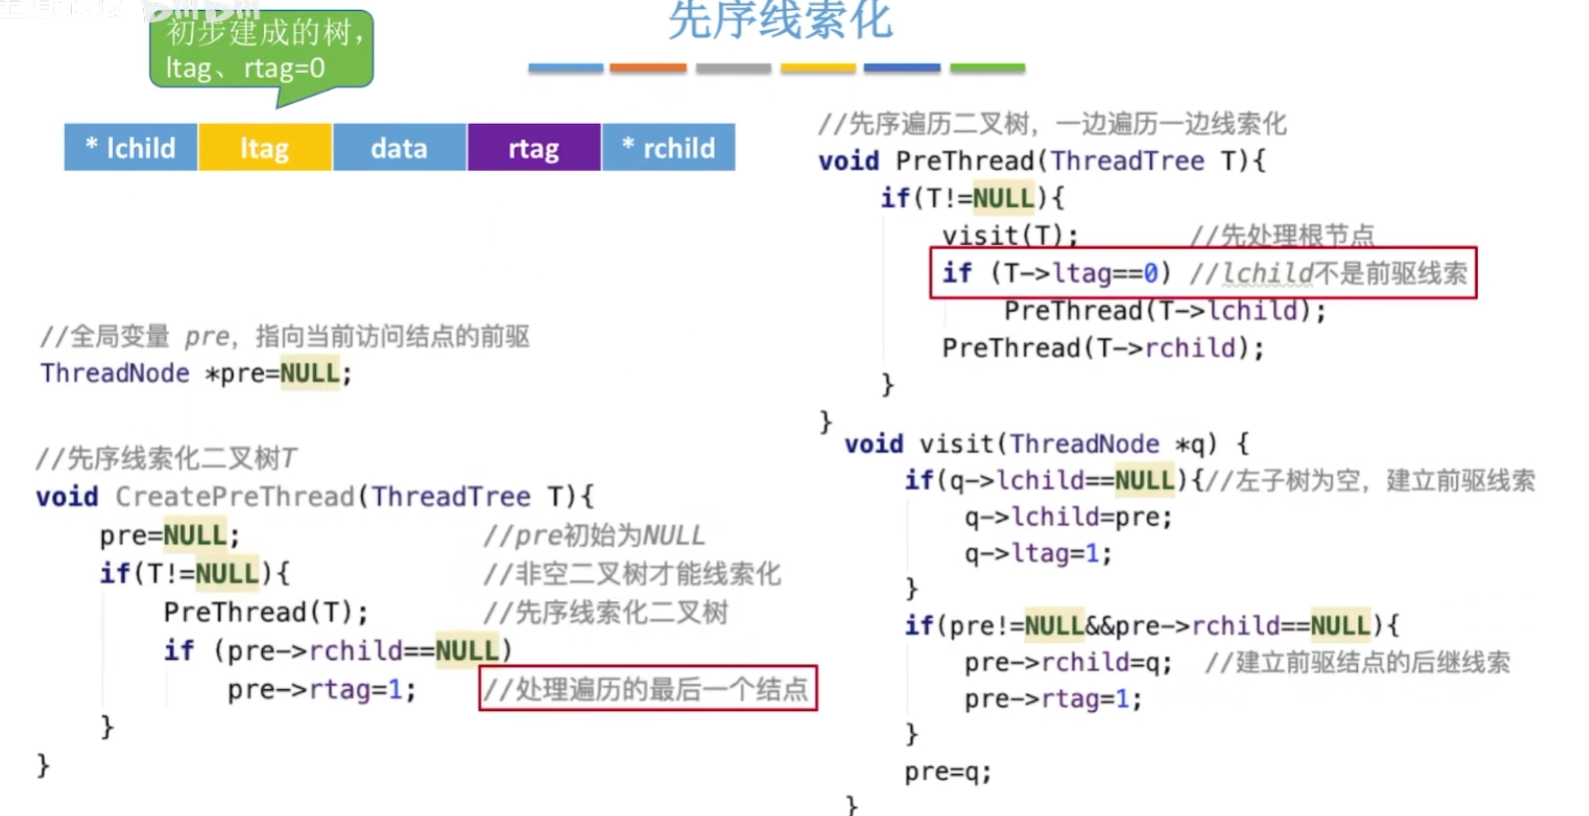
 二叉树的顺序存储,使用数组存储,至于链式存储在上面已经讲过了。
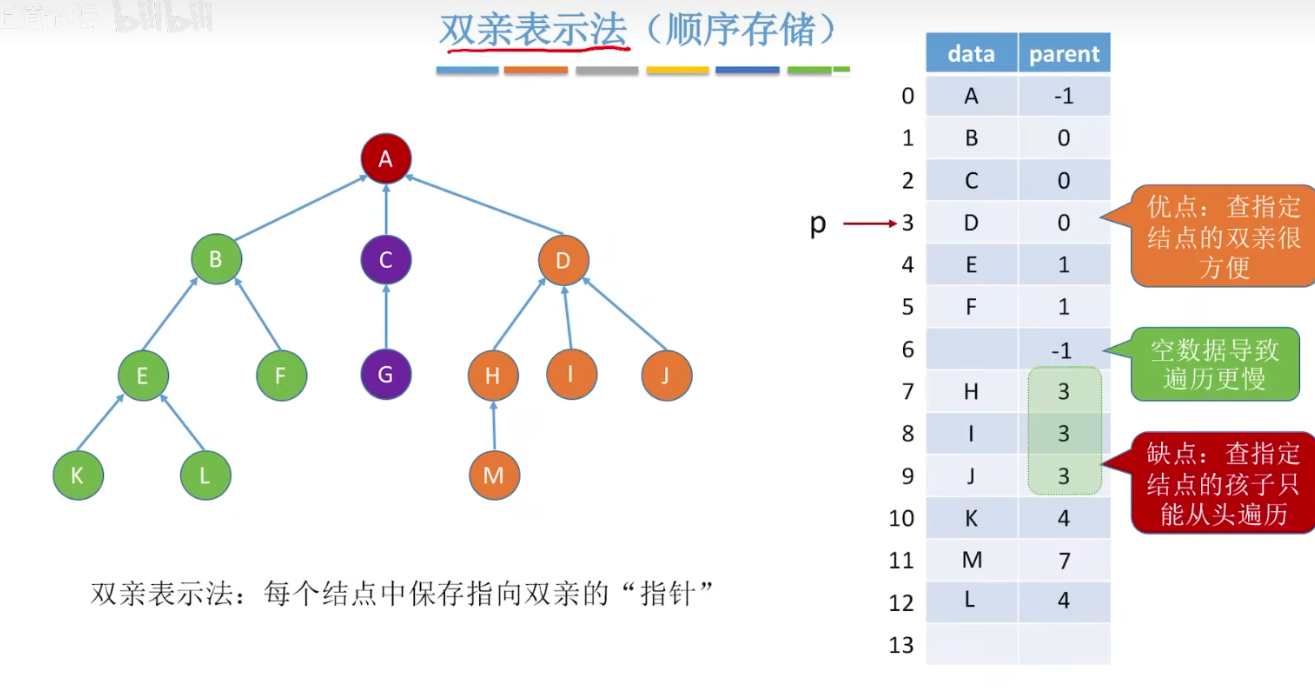 二叉树也可以以用这个方法存储。
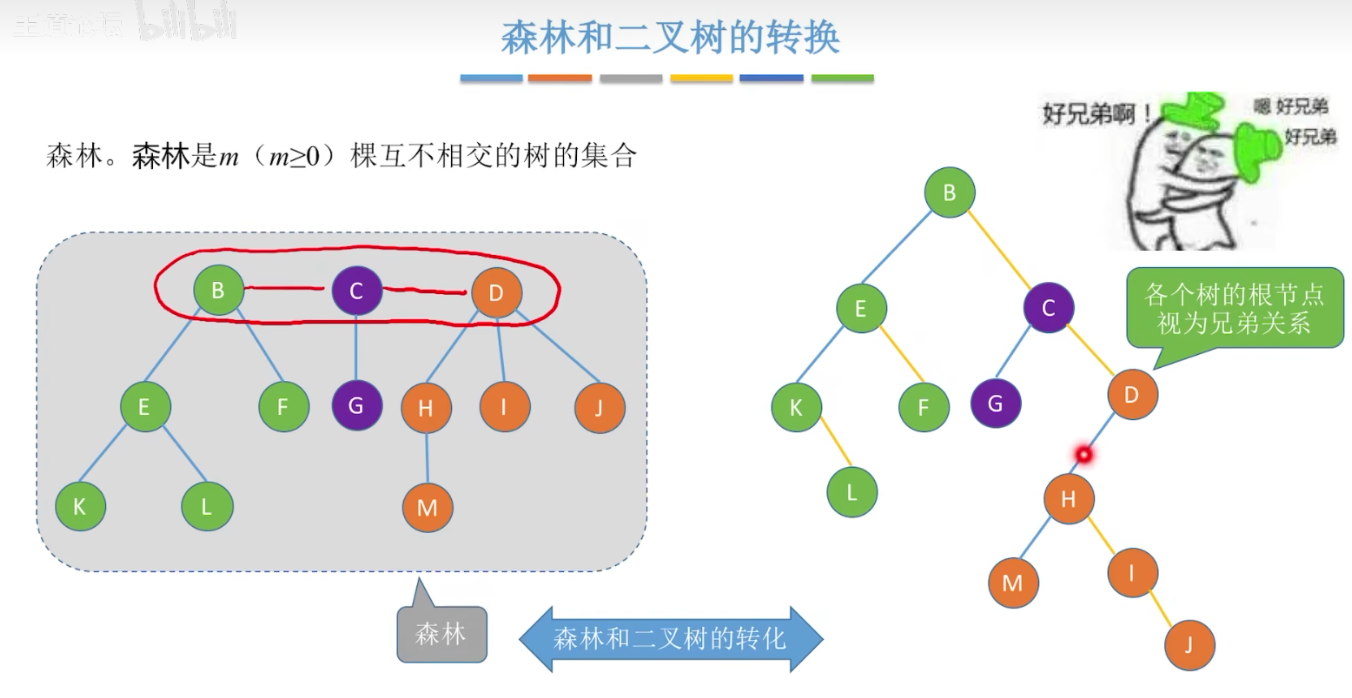
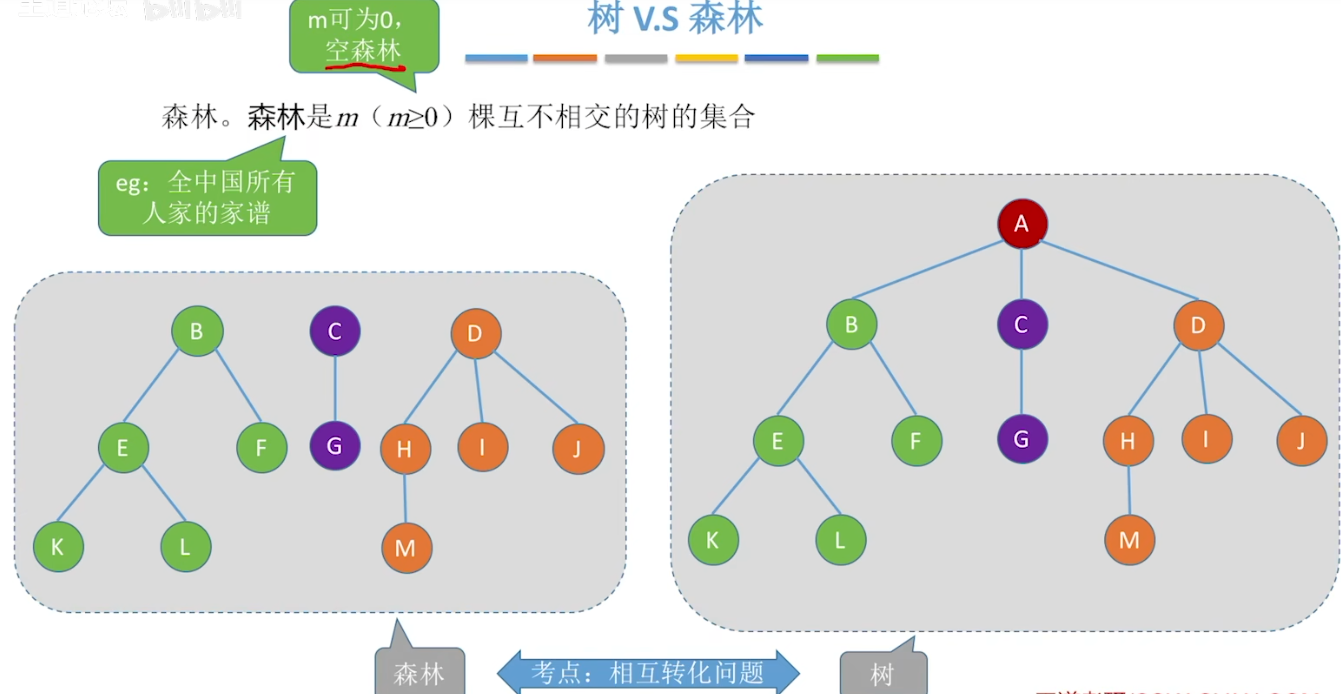
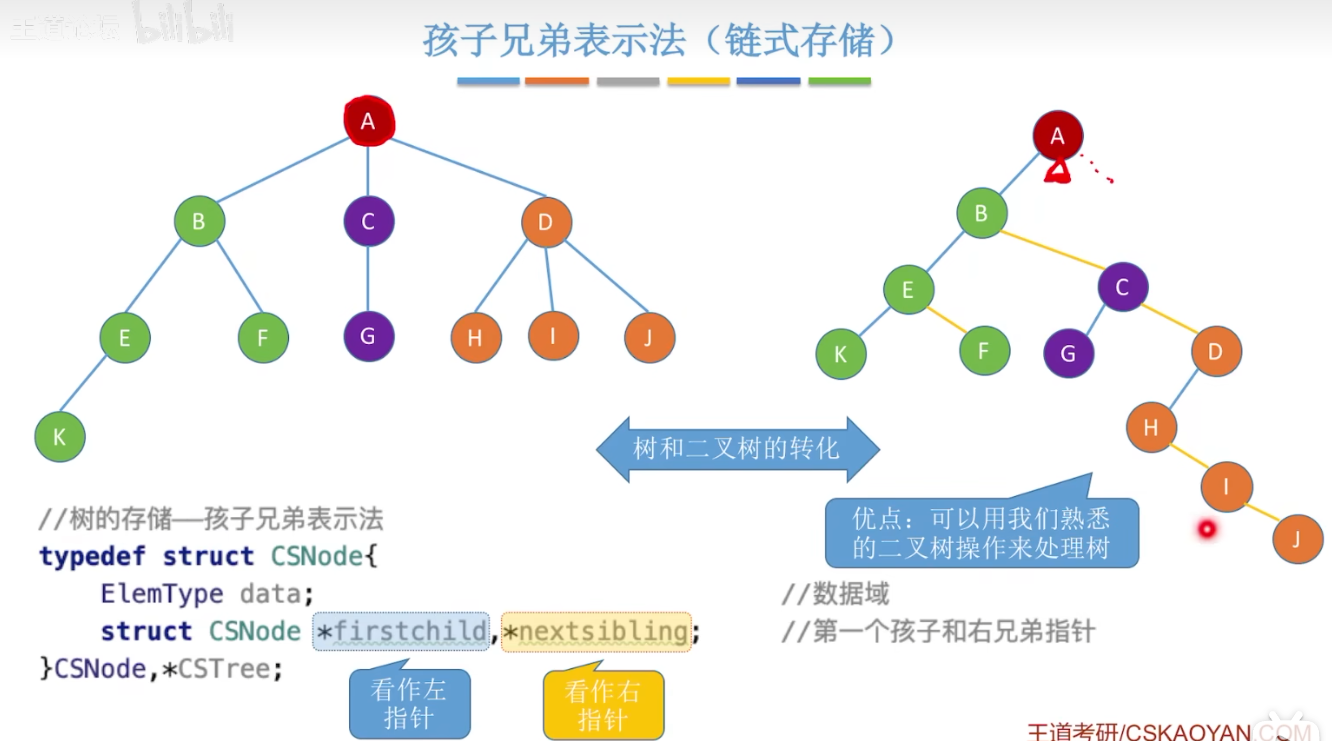 树和二叉树的转化:
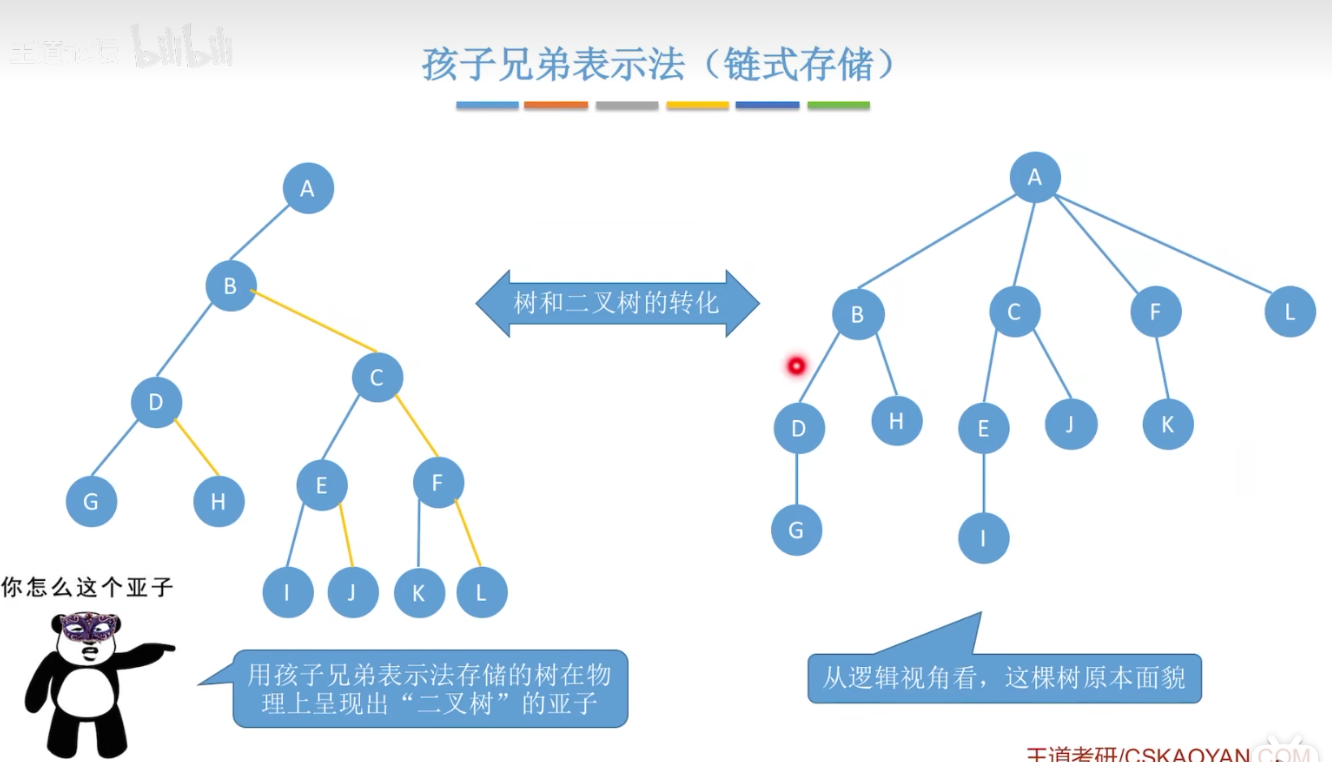 森林转化成二叉树: